
LocalAI:在任何硬件上运行 LLM、图像与视频,无需 GPU
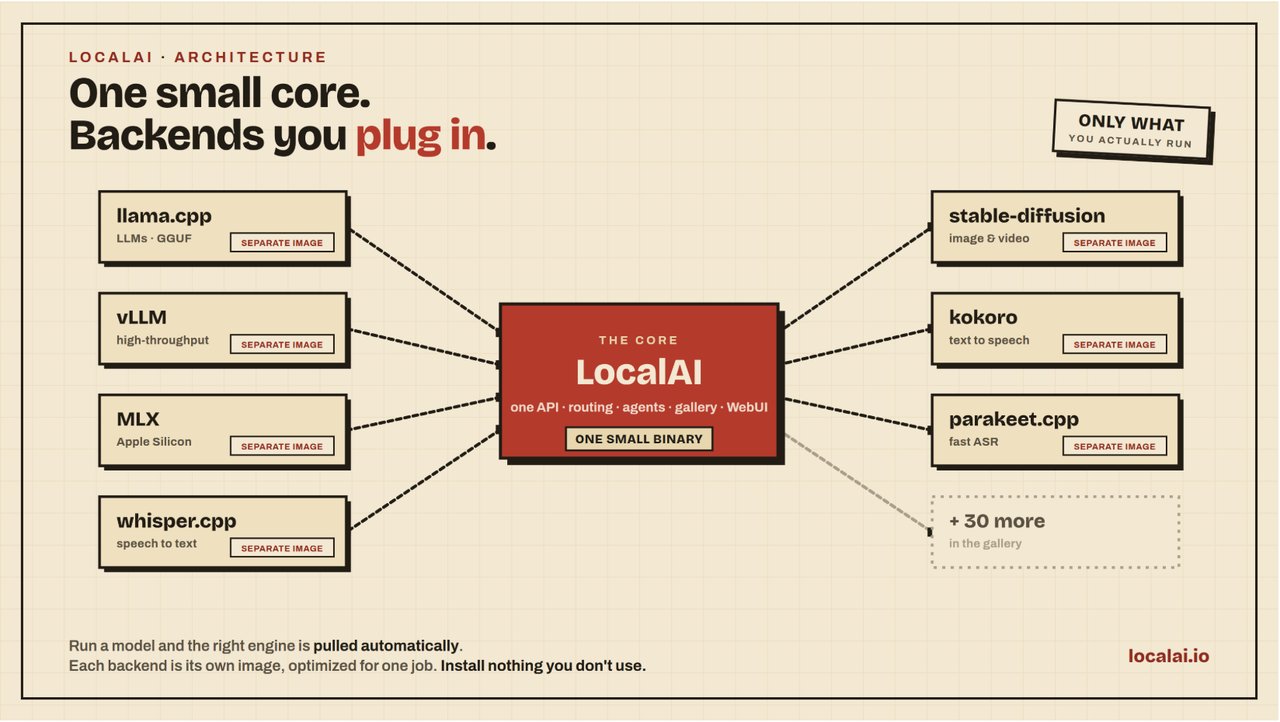
说实话吧:2026 年让我们都在想,运行 AI 是不是意味着要卖肾换一块数据中心 GPU。后来,像 LocalAI 这样的开源项目出现了,并彻底改变了局面。LocalAI 是一个自托管、开源 AI 引擎,可以在你自己的机器上运行大语言模型(LLM)、图像生成、视频模型、语音识别、文本转语音,以及更多能力——无需 GPU,而且完全保护隐私。如果你一直在寻找摆脱 API 锁定的方法,这就是你的门票。
LocalAI 有何不同?
这个项目自称是“一个小核心,而不是一个大捆绑包”。LocalAI 不会把所有可能的依赖都塞进一个巨型二进制文件,而是设计成可组合的:每个后端都将 llama.cpp、vLLM、whisper.cpp、stable-diffusion 或 MLX 等久经考验的引擎封装在自己的容器镜像中。某个后端只有在模型真正需要时才会被拉取。这意味着你不会安装一座用不上的软件大山,还能用任何语言编写的自定义后端来扩展 LocalAI。
LocalAI 也是你已熟悉 API 的无缝替代品。它在所有模态下都兼容 OpenAI API、Anthropic API 和 ElevenLabs 音频 API。所以,如果你已经为托管 API 写好代码,决定转为本地运行,通常只需修改端点 URL 即可。
无需 GPU 的魔法
大多数主流模型在 CPU 上也能正常运行,只是会慢一些;而当你拥有加速硬件时,LocalAI 也支持硬件加速:NVIDIA(CUDA 12/13)、AMD(ROCm)、Intel(oneAPI)、Apple Silicon(Metal)、Vulkan,甚至 NVIDIA Jetson 设备。你可以从一台纯 CPU 笔记本开始,之后不改变工作流就能迁移到 GPU。LocalAI 还会自动检测你的 GPU 能力并获取相应的后端,因此无需手动折腾几十个环境变量。
十秒安装
开始使用 LocalAI 真的很简单。最快的路径是 Docker。如果只用 CPU,运行这一行命令:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
有 NVIDIA GPU?选择匹配的 CUDA 镜像,并加上 --gpus all:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
AMD 用户可以配合几个设备标志使用 HIPBLAS 镜像;Intel 和 Vulkan 用户也有专属镜像。如果你更喜欢原生应用,官方提供了 macOS DMG——安装后记得移除隔离属性,因为 Apple 尚未对其签名。你可以在项目的 README 中找到确切命令。
加载模型:一条命令,无限选择
加载模型最简单的方式是通过内置的命令行工具。LocalAI 给你一条统管全局的命令:
local-ai run llama-3.2-1b-instruct:q4_k_m
它可以从 LocalAI 模型库中获取模型。但不只限于这个模型库,你还可以直接从 Hugging Face、Ollama 注册表或任意标准 OCI 注册表拉取模型:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
你甚至可以让 LocalAI 指向一个 YAML 配置文件,以精确满足你对模型设置和上下文长度的要求。
与终端代理聊天
模型加载后,你会看到一个实验性但非常酷的内置终端代理。它并非一个普普通通的 REPL,而是可以读取文件、回答问题,并在你的机器上执行命令。它在做任何更改前都会请求你的批准,因此控制权始终在你手中。在终端中启动服务器:
local-ai run llama-3.2-1b-instruct:q4_k_m
然后打开另一个 shell,与它对话:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
聊天时,你可以输入 /models 查看已安装的模型,输入 /model <name> 在对话中途切换。这非常方便,但如果你还没准备好让 AI 操控你的终端,8080 端口上还运行着一个兼容 OpenAI 的常规聊天服务器,你可以使用任何喜欢的客户端。
LocalAI 究竟能做什么?
说实话,LocalAI 的功能列表让人目不暇接。在文本方面,你可以使用文本生成、嵌入、重排序器、视觉 API,以及兼容 OpenAI 的工具。语音方面则有音频转文本、文本转音频、基于 WebRTC 的实时语音转语音、语音活动检测,甚至说话人分离。图像生成、视频生成、目标检测和深度估计也都包含在内。如果需要结构化输出,它还支持受限文法和 JSON Schema。
后端库中包含 60 多个后端。其中一些是 LocalAI 团队用 C++/GGML 构建的原生引擎,例如用于转录的 parakeet.cpp、用于说话人识别的 voice-detect.cpp,以及无需 GPU 和相机位姿就能把几张照片变成 3D 高斯模型的 free-splatter.cpp。它们不只是包装器,而是从零开始的 C++ 实现,运行时不需要 Python 推理——这可说是可移植性方面的一大壮举。
最近的版本还加入了支持 VRAM 感知路由和自动扩展的分布式模式、MCP(模型上下文协议)支持、多用户配额管理,以及 UI 内直接微调的能力。换句话说,它正从一个单纯的模型运行器,成长为一个面向个人和团队的完整平台。
隐私优先的 AI 终于变得实用
LocalAI 的 README 中有一句话概括了它的全部吸引力:“你的数据永远不会离开你的基础设施。”运行 LocalAI 时,每个 API 请求都留在你自己的机器上。没有提示词泄漏,没有数据去训练别人的模型,也没有合规方面的麻烦。再加上它对微调和量化的支持,你可以构建一套完全私有、但仍遵循开放标准的 AI 技术栈。
该项目以 MIT 许可证发布,由 Ettore Di Giacinto 和一个活跃社区维护。你可以在 LocalAI 模型库中浏览模型,也可以直接按 GitHub 上的快速入门操作。一旦深入使用,你很可能会同意:LocalAI 是我们目前最接近“以自己的方式运行 AI”这个目标的通用、开放且合乎伦理的方案。
相关文章
Deep-Live-Cam 2.1.6:仅需一张照片即可实时换脸
了解 Deep-Live-Cam,这款开源工具只需一张图像即可实时换脸。学习如何安装并负责任地使用它。
Hermes Agent:从每项任务中学习的自我改进AI
Hermes Agent是来自Nous Research的开源AI智能体,它会随时间学习技能、记住你的上下文,并能在手机、笔记本电脑或5美元VPS上运行。
Humanizer:让AI写作文本听起来像人写的开源工具
Humanizer 能利用维基百科“Signs of AI writing”中的35种模式,将带有AI腔的文本改写成自然、像人写的文章。本文将介绍其工作原理,并附有前后对比示例和安装步骤。
认识 VoiceStudio:免费、本地优先,支持 646 种语言的语音克隆
VoiceStudio 在你的桌面上打造了一个免费、开源、本地优先的语音工作室——用 3 秒音频克隆任意声音,并以 646 种语言生成,无需花费一分钱。