
LocalAI:あらゆるハードウェアでLLM・画像・動画を実行、GPU不要
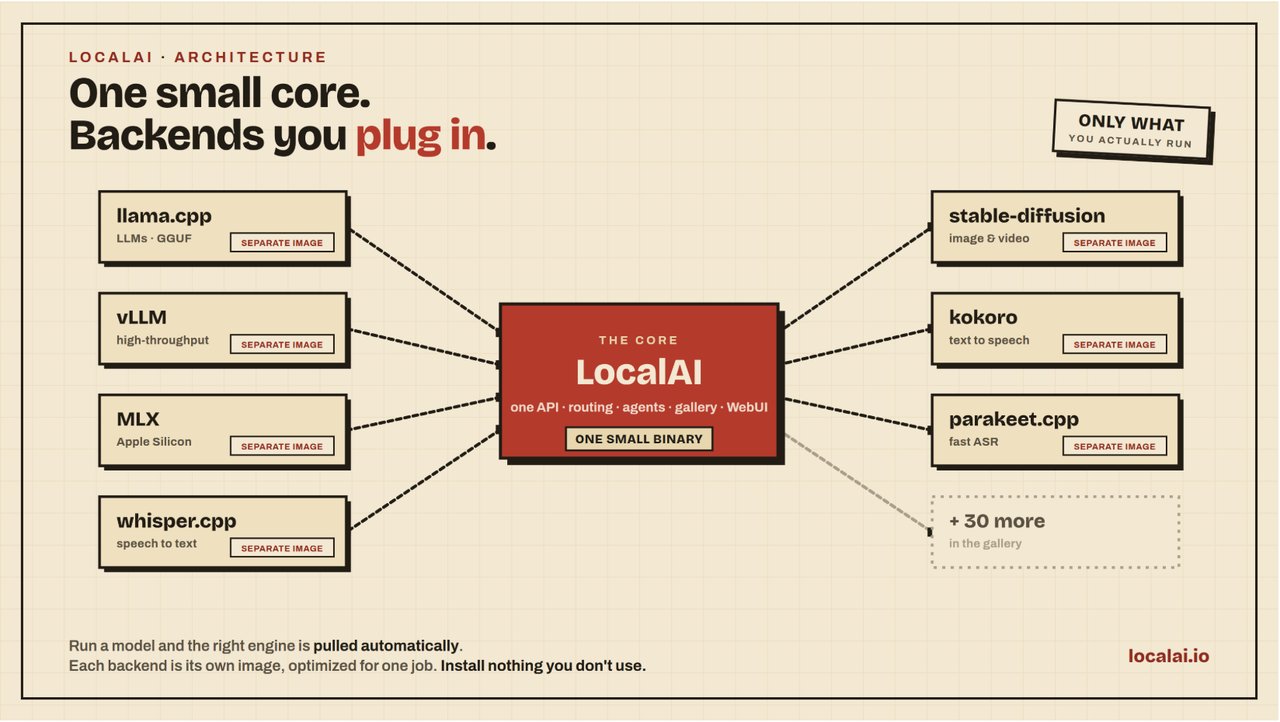
正直に言いましょう。2026年は、AIを実行するためにデータセンター用GPUと引き換えに片方の腎臓を売るようなことになるのか、と皆が考えた年でした。そんな中、LocalAIのようなオープンソースプロジェクトが登場し、状況を一変させました。LocalAIはセルフホスト型のオープンソースAIエンジンで、LLM、画像生成、動画モデル、音声認識、テキスト読み上げなど、その他にもさまざまな処理を、自分のマシン上で、GPUなしで、完全なプライバシーを保って実行できます。APIロックインから逃れたいなら、これが最適な方法です。
LocalAIが他と違う点は?
このプロジェクトは、自身を「バンドルではなく小さなコア」と表現しています。考えられるすべての依存関係を1つの巨大なバイナリに詰め込むのではなく、LocalAIは構成可能なように設計されています。各バックエンドは、llama.cpp、vLLM、whisper.cpp、stable-diffusion、MLXといった実績のあるエンジンを独自のコンテナイメージにラップします。そのバックエンドが取得されるのは、モデルが実際にそれを必要とするときだけです。つまり、決して使わない大量のソフトウェアをインストールする必要はなく、任意の言語でカスタムバックエンドを追加してLocalAIを拡張できるのです。
LocalAIは、既によく知られているAPIのドロップイン代替品でもあります。テキスト、画像、音声など、すべてのモダリティにわたってOpenAI API、Anthropic API、ElevenLabsのオーディオAPIと互換性があります。つまり、ホスト型API向けに書かれたコードがすでにある場合、ローカルに移行する際に変更が必要なのは通常エンドポイントURLだけです。
GPU不要の魔法
人気のあるモデルのほとんどはCPUでも問題なく動作しますが、遅くなります。LocalAIは、お使いの環境にその機能があれば、ハードウェアアクセラレーションをサポートします。NVIDIA(CUDA 12/13)、AMD(ROCm)、Intel(oneAPI)、Apple Silicon(Metal)、Vulkan、さらにはNVIDIA Jetsonデバイスに対応しています。CPUのみのラップトップで始めて、あとからワークフローを変えずにGPUへ移行できます。また、LocalAIはGPUの性能を自動的に検出して適切なバックエンドを取得するため、何十もの環境変数を設定する必要はありません。
10秒でインストール
LocalAIのセットアップは驚くほど簡単です。最速の方法はDockerを使うことです。CPUのみの場合は、次のワンライナーを実行してください:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
NVIDIA GPUをお持ちですか?対応するCUDAイメージを選び、--gpus all を追加してください:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
AMDユーザーは、いくつかのデバイスフラグを指定してHIPBLASイメージを使用できます。IntelユーザーとVulkanユーザー向けの専用イメージもあります。ネイティブアプリをご希望の場合は、公式のmacOS DMGがあります。ただし、Appleが署名していないため、インストール後に検疫属性を忘れずに解除してください。正確なコマンドはプロジェクトのREADMEに記載されています。
モデルの読み込み:1つのコマンドで無限の選択肢
モデルを読み込む最も簡単な方法は、内蔵のコマンドラインツールを使うことです。LocalAIには、すべてを司る1つのコマンドがあります:
local-ai run llama-3.2-1b-instruct:q4_k_m
これにより、LocalAIのモデルギャラリーからモデルが取得されます。ただし、そのギャラリーに限定されるわけではありません。Hugging Face、Ollamaのレジストリ、または標準的なOCIレジストリから直接モデルを取得できます:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
さらに、YAML設定ファイルをLocalAIに指定して、モデルの設定やコンテキスト長を思いどおりに定義することもできます。
ターミナルエージェントとチャットする
モデルが読み込まれると、実験的ですが非常にクールな内蔵ターミナルエージェントが利用できます。このエージェントは、単なるREPLに入るのではなく、ファイルの読み取り、質問への回答、マシン上でのコマンド実行ができます。何かを変更する前には承認を求めるので、常にあなたが制御できます。ターミナルでサーバーを起動してください:
local-ai run llama-3.2-1b-instruct:q4_k_m
次に、別のシェルを開いて話しかけてください:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
チャット中に/modelsと入力するとインストール済みモデルの一覧が表示され、/model <name>と入力すると会話の途中でモデルを切り替えられます。これは便利ですが、AIにターミナルを触らせる準備がまだ整っていない場合は、通常のOpenAI互換チャットサーバーがポート8080で稼働しているので、お好みのクライアントを使用できます。
LocalAIで実際にできること
LocalAIの機能リストは、正直なところ圧倒的です。テキスト分野では、テキスト生成、埋め込み(embeddings)、リランカー、Vision API、OpenAI互換ツールを利用できます。音声分野では、音声からテキスト、テキストから音声、WebRTCを使ったリアルタイムの音声から音声への変換、音声活動検出、そして話者ダイアリゼーション(話者分離)まで提供されます。画像生成、動画生成、物体検出、深度推定もすべてメニューに含まれています。構造化出力が必要な場合は、制約付き文法とJSONスキーマに対応しています。
バックエンドギャラリーには60以上のバックエンドが含まれています。一部はLocalAIチームがC++/GGMLで構築したネイティブエンジンで、例えば文字起こし用のparakeet.cpp、話者認識用のvoice-detect.cpp、そしてGPUもカメラポーズも使わずに数枚の写真を3Dガウシアンへ変換できるfree-splatter.cppなどがあります。これらは単なるラッパーではなく、一から作られたC++実装であり、実行時にPython推論を一切使用しません。移植性の高さは見事です。
最近のリリースでは、VRAMを考慮したルーティングとオートスケーリングを備えた分散モード、MCP(Model Context Protocol)サポート、マルチユーザー向けクォータ管理、UI内でのファインチューニングが追加されました。言い換えれば、LocalAIは単なるモデルランナーではなく、個人やチームのための完全なプラットフォームになりつつあります。
プライバシー最優先のAIがついに実用的に
LocalAIのREADMEには、その魅力をすべて言い表した一文があります。「あなたのデータがあなたのインフラから出ることは決してありません」。LocalAIを実行すれば、すべてのAPIリクエストは自分のマシン上に留まります。プロンプトが漏れることも、データが他人のモデルの学習に使われることも、コンプライアンス上の頭痛もありません。ファインチューニングと量子化のサポートと組み合わせれば、オープン標準に準拠しつつ、完全にプライベートなAIスタックを構築できます。
このプロジェクトはMITライセンスで提供され、Ettore Di Giacintoと活発なコミュニティによって維持されています。LocalAIモデルギャラリーでモデルを閲覧するか、GitHubのクイックスタートを参照するだけで始められます。使い込んでみれば、きっとこう思うはずです。LocalAIは、自分の条件でAIを実行するための、普遍的でオープンかつ倫理的にも健全な方法として、現時点で最も近いものだと。