
LocalAI : exécutez des LLM et des modèles image/vidéo sur n'importe quel matériel, sans GPU requis
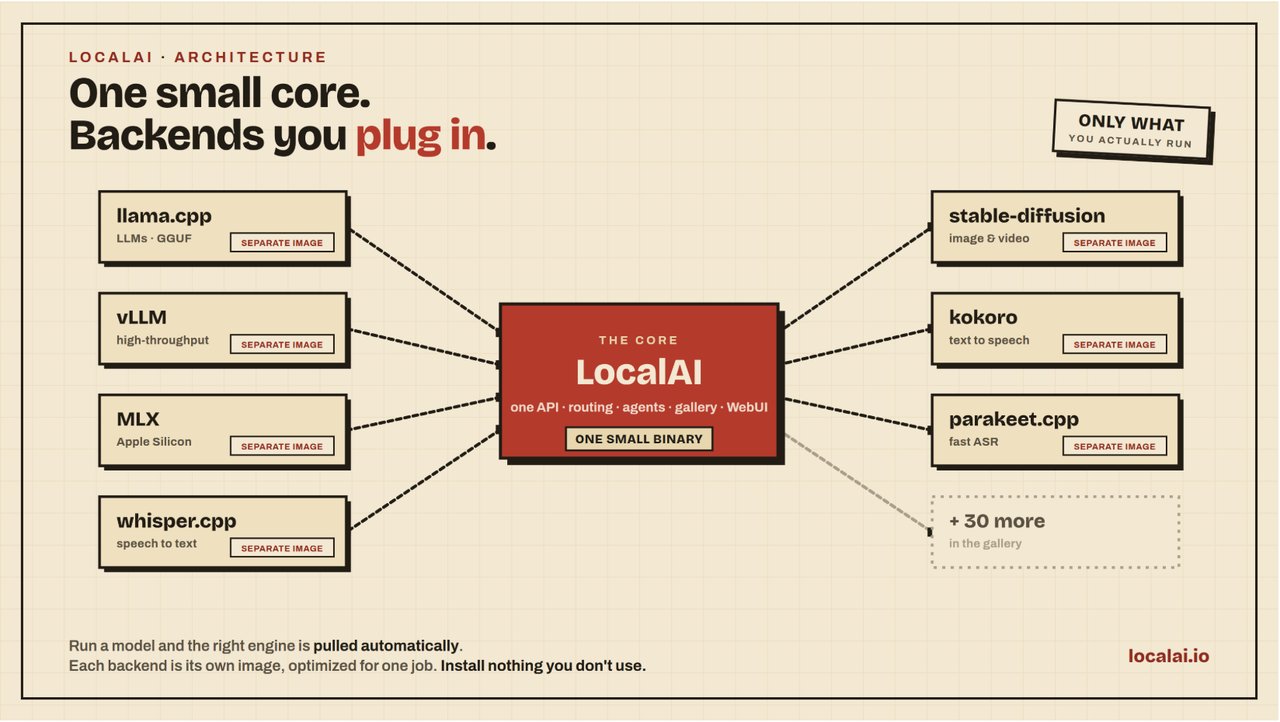
Soyons honnêtes : en 2026, nous nous demandions tous si faire tourner de l'IA signifiait vendre un rein pour un GPU de centre de données. Puis des projets open source comme LocalAI sont arrivés et ont renversé la donne. LocalAI est un moteur d'IA open source auto-hébergé qui peut faire tourner des LLM, générer des images, exécuter des modèles vidéo, effectuer la reconnaissance vocale et la synthèse vocale, et bien plus encore — sur votre propre machine, sans GPU, et en toute confidentialité. Si vous cherchez un moyen d'échapper à la dépendance envers un fournisseur d'API, c'est ce qu'il vous faut.
Qu'est-ce qui rend LocalAI différent ?
Le projet se décrit comme « un petit noyau, pas un fourre-tout ». Plutôt que de livrer toutes les dépendances possibles dans un seul binaire géant, LocalAI est conçu pour être modulaire : chaque backend encapsule un moteur éprouvé — comme llama.cpp, vLLM, whisper.cpp, stable-diffusion ou MLX — dans sa propre image conteneur. Ce backend n'est téléchargé que lorsqu'un modèle en a réellement besoin. Cela signifie que vous n'installez pas une montagne de logiciels dont vous ne vous servirez jamais, et que vous pouvez étendre LocalAI avec des backends personnalisés dans n'importe quel langage.
LocalAI est aussi un remplaçant direct des API que vous connaissez déjà. Il est compatible avec l'API OpenAI, l'API Anthropic et l'API audio ElevenLabs dans toutes ses modalités. Ainsi, si vous avez déjà du code écrit pour une API hébergée et que vous décidez de passer au local, vous n'aurez généralement qu'à changer l'URL du point de terminaison.
La magie sans GPU
La plupart des modèles populaires fonctionnent bien sur CPU, mais plus lentement, et LocalAI prend en charge l'accélération matérielle lorsque vous en disposez : NVIDIA (CUDA 12/13), AMD (ROCm), Intel (oneAPI), Apple Silicon (Metal), Vulkan, et même les appareils NVIDIA Jetson. Vous pouvez commencer avec un simple ordinateur portable sans GPU, puis passer à un GPU plus tard sans modifier votre flux de travail. LocalAI détecte aussi automatiquement les capacités de votre GPU et récupère le bon backend, vous n'avez donc pas à bidouiller des dizaines de variables d'environnement.
Installation en dix secondes
Démarrer avec LocalAI est vraiment sans complication. Le plus rapide est de passer par Docker. Pour une utilisation CPU uniquement, exécutez cette commande :
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
Vous avez un GPU NVIDIA ? Choisissez l'image CUDA correspondante et ajoutez --gpus all :
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
Côté AMD, l'image HIPBLAS est disponible avec quelques options de périphérique, tandis que les utilisateurs d'Intel et de Vulkan ont aussi droit à des images dédiées. Si vous préférez les applications natives, il existe un DMG macOS officiel — pensez simplement à supprimer l'attribut de quarantaine après l'installation, car Apple ne l'a pas signé. Vous trouverez la commande exacte dans le README du projet.
Chargement des modèles : une commande, une infinité de choix
Le moyen le plus simple de charger un modèle est d'utiliser l'outil en ligne de commande intégré. LocalAI vous offre une commande pour les gouverner tous :
local-ai run llama-3.2-1b-instruct:q4_k_m
Cela récupère un modèle depuis la galerie de modèles de LocalAI. Mais vous n'êtes pas limité à cette galerie. Vous pouvez récupérer des modèles directement depuis Hugging Face, le registre d'Ollama ou tout registre OCI standard :
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
Vous pouvez même pointer LocalAI vers un fichier de configuration YAML afin de définir les réglages du modèle et la longueur du contexte exactement comme vous le souhaitez.
Discutez avec votre agent de terminal
Une fois votre modèle chargé, il existe un agent de terminal intégré, expérimental mais très sympa. Au lieu de vous retrouver dans un simple REPL, cet agent peut lire des fichiers, répondre à des questions et exécuter des commandes sur votre machine. Il demande une approbation avant de modifier quoi que ce soit, pour que vous gardiez le contrôle. Dans un terminal, démarrez le serveur :
local-ai run llama-3.2-1b-instruct:q4_k_m
Ouvrez ensuite un autre shell et parlez-lui :
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
Pendant la conversation, vous pouvez taper /models pour voir les modèles installés, et /model <name> pour basculer entre eux en pleine discussion. C'est pratique, mais si vous n'êtes pas prêt à laisser une IA toucher à votre terminal, un serveur de chat classique compatible OpenAI tourne sur le port 8080 et vous pouvez utiliser n'importe quel client.
Que peut faire concrètement LocalAI ?
La liste des fonctionnalités de LocalAI est franchement impressionnante. Côté texte, vous disposez de la génération de texte, d'embeddings, de rerankers, d'une API Vision et d'outils compatibles OpenAI. Pour la parole, on trouve la transcription audio, la synthèse vocale, la conversation vocale en temps réel avec WebRTC, la détection d'activité vocale et même la diarisation des locuteurs. La génération d'images, la génération vidéo, la détection d'objets et l'estimation de profondeur sont également au menu. Si vous avez besoin d'une sortie structurée, il prend en charge les grammaires contraintes et les schémas JSON.
La galerie de backends comprend plus de 60 backends. Certains sont des moteurs natifs développés par l'équipe LocalAI en C++/GGML, comme parakeet.cpp pour la transcription, voice-detect.cpp pour la reconnaissance des locuteurs, et free-splatter.cpp, qui peut transformer une poignée de photos en Gaussiennes 3D sans GPU et sans poses de caméra. Ce ne sont pas de simples wrappers : ce sont des implémentations C++ écrites de zéro, sans inférence Python à l'exécution — une prouesse impressionnante en termes de portabilité.
Les versions récentes ont ajouté un mode distribué avec un routage adapté à la VRAM et une mise à l'échelle automatique, la prise en charge de MCP (Model Context Protocol), la gestion des quotas multi-utilisateurs et le fine-tuning directement dans l'interface. En d'autres termes, il devient non seulement un exécuteur de modèles, mais une plateforme complète pour les utilisateurs individuels et les équipes.
Une IA qui fait de la confidentialité une priorité est enfin pratique
Il y a une phrase dans le README de LocalAI qui résume tout l'intérêt : « vos données ne quittent jamais votre infrastructure ». Lorsque vous exécutez LocalAI, chaque requête API reste sur vos propres machines. Pas de fuite de prompt, pas de données servant à entraîner le modèle d'un inconnu, pas de casse-tête de conformité. Grâce à sa prise en charge du fine-tuning et de la quantification, vous pouvez construire une pile d'IA entièrement privée qui respecte toujours les standards ouverts.
Le projet est sous licence MIT et maintenu par Ettore Di Giacinto et une communauté active. Vous pouvez parcourir les modèles dans la galerie de modèles de LocalAI ou suivre le guide de démarrage rapide sur GitHub. Une fois que vous aurez exploré le projet, vous serez probablement d'accord : LocalAI est ce qui se rapproche le plus d'une méthode universelle, ouverte et éthiquement responsable pour exécuter l'IA selon vos propres conditions.
Articles associés
Deep-Live-Cam 2.1.6 : Échange de visage en temps réel avec une seule photo
Découvrez Deep-Live-Cam, l'outil open-source qui échange les visages en temps réel à partir d'une seule image. Apprenez à l'installer et à l'utiliser de manière responsable.
Hermes Agent : l'IA auto-améliorante qui apprend de chaque tâche
Hermes Agent est un agent IA open source de Nous Research qui apprend des compétences au fil du temps, mémorise votre contexte et peut fonctionner sur un téléphone, un ordinateur portable ou un VPS à 5 dollars.
Humanizer : l'outil open source qui rend les textes IA humains
Humanizer réécrit les textes à consonance IA en une prose naturelle et humaine en s'appuyant sur 35 schémas de la page Wikipédia « Signs of AI writing ». Voici comment il fonctionne, avec des exemples avant/après et les étapes d'installation.
Présentation de VoiceStudio : clonage vocal gratuit, local et disponible en 646 langues
VoiceStudio apporte un studio vocal open source gratuit et local sur votre bureau. Clonez n'importe quelle voix à partir de 3 secondes d'audio et générez en 646 langues sans dépenser un centime.