
LocalAI: execute LLMs, imagens e vídeo em qualquer hardware, sem necessidade de GPU
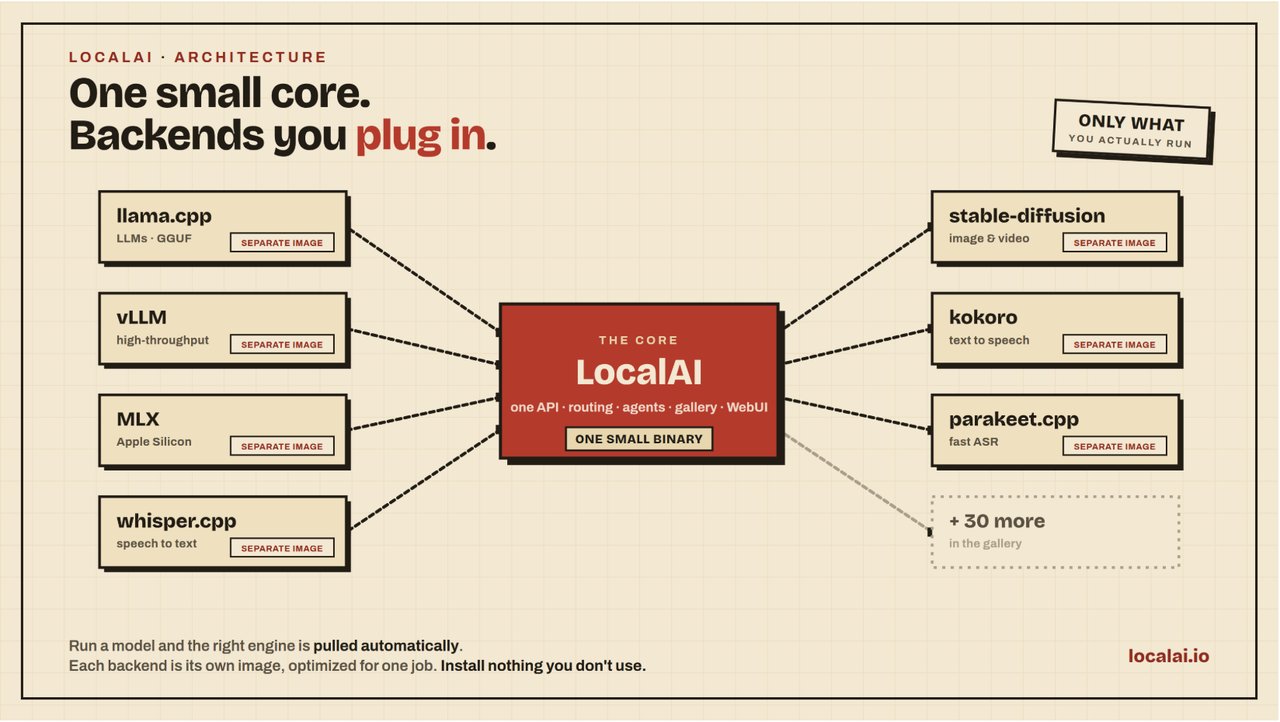
Sejamos honestos: em 2026, todos nós nos perguntávamos se rodar IA significava vender um rim por uma GPU de data center. Então projetos open-source como o LocalAI surgiram e viraram o jogo. O LocalAI é um mecanismo de IA open-source auto-hospedado que pode executar LLMs, geração de imagens, modelos de vídeo, reconhecimento de fala, texto para fala e muito mais — na sua própria máquina, sem GPU e com total privacidade. Se você procurava uma forma de escapar do lock-in de APIs, esse é o seu bilhete de entrada.
O que torna o LocalAI diferente?
O projeto se descreve como "um núcleo pequeno, não um pacote completo". Em vez de enviar todas as dependências possíveis em um único binário gigante, o LocalAI foi projetado para ser componível: cada backend encapsula um mecanismo comprovado como llama.cpp, vLLM, whisper.cpp, stable-diffusion ou MLX em sua própria imagem de contêiner. Esse backend só é baixado quando um modelo realmente precisa dele. Isso significa que você não instala uma montanha de software que nunca vai usar, e pode estender o LocalAI com backends personalizados em qualquer linguagem.
O LocalAI também é um substituto direto para APIs que você já conhece. Ele é compatível com a API da OpenAI, a API da Anthropic e a API de áudio da ElevenLabs em todas as suas modalidades. Então, se você já tem código escrito para uma API hospedada e decide ir para o local, normalmente tudo o que você precisa mudar é a URL do endpoint.
A mágica de rodar sem GPU
A maioria dos modelos populares roda bem em CPU, porém mais lentamente, e o LocalAI oferece suporte a aceleração de hardware quando você tem: NVIDIA (CUDA 12/13), AMD (ROCm), Intel (oneAPI), Apple Silicon (Metal), Vulkan e até dispositivos NVIDIA Jetson. Você pode começar com um laptop simples com CPU e depois migrar para uma GPU sem mudar seu fluxo de trabalho. O LocalAI também detecta automaticamente as capacidades da sua GPU e busca o backend correto, então você não precisa mexer em dezenas de variáveis de ambiente.
Instalação em dez segundos
Começar com o LocalAI é realmente indolor. O caminho mais rápido é o Docker. Para usar apenas CPU, execute este comando de uma linha:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
Tem uma GPU NVIDIA? Escolha a imagem CUDA correspondente e adicione --gpus all:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
Os fãs de AMD podem usar a imagem HIPBLAS com algumas flags de dispositivo, enquanto usuários de Intel e Vulkan também têm imagens dedicadas. Se você prefere aplicativos nativos, há um DMG oficial para macOS — apenas lembre-se de remover o atributo de quarentena após a instalação, pois a Apple não o assinou. Você encontrará o comando exato no README do projeto.
Carregando modelos: um comando, infinitas opções
A maneira mais fácil de carregar um modelo é por meio da ferramenta de linha de comando integrada. O LocalAI oferece um comando para governar todos:
local-ai run llama-3.2-1b-instruct:q4_k_m
Isso busca um modelo na galeria de modelos do LocalAI. Mas você não está limitado a essa galeria. Você pode puxar modelos diretamente do Hugging Face, do registry do Ollama ou de qualquer registry OCI padrão:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
Você pode inclusive apontar o LocalAI para um arquivo de configuração YAML para definir as configurações do modelo e o comprimento do contexto exatamente do jeito que quiser.
Converse com seu agente de terminal
Assim que seu modelo é carregado, há um agente de terminal integrado, experimental e muito legal. Em vez de cair em um REPL simples, esse agente pode ler arquivos, responder perguntas e executar comandos na sua máquina. Ele pede aprovação antes de alterar qualquer coisa, então você permanece no controle. Em um terminal, inicie o servidor:
local-ai run llama-3.2-1b-instruct:q4_k_m
Depois, abra outro shell e converse com ele:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
Enquanto conversa, você pode digitar /models para ver os modelos instalados e /model <name> para alternar entre eles no meio da conversa. É legal, mas se você ainda não está pronto para deixar uma IA mexer no seu terminal, um servidor de chat comum compatível com a OpenAI está rodando na porta 8080 e você pode usar qualquer cliente que preferir.
O que o LocalAI realmente pode fazer?
A lista de recursos do LocalAI é francamente impressionante. No lado do texto, você tem geração de texto, embeddings, rerankers, uma API de Visão e ferramentas compatíveis com a OpenAI. Para fala, há áudio para texto, texto para áudio, conversa de fala para fala em tempo real com WebRTC, detecção de atividade de voz e até diarização de locutores. Geração de imagens, geração de vídeo, detecção de objetos e estimativa de profundidade também estão no menu. Se você precisa de saída estruturada, ele suporta gramáticas restritas e esquemas JSON.
A galeria de backends inclui mais de 60 backends. Alguns são mecanismos nativos criados pela equipe do LocalAI em C++/GGML, como parakeet.cpp para transcrição, voice-detect.cpp para reconhecimento de locutor e free-splatter.cpp, que pode transformar algumas fotos em Gaussianos 3D sem GPU e sem poses de câmera. Esses não são apenas wrappers; são implementações em C++ feitas do zero, sem inferência em Python em tempo de execução — uma façanha impressionante para a portabilidade.
Os lançamentos recentes adicionaram modo distribuído com roteamento ciente de VRAM e autoescalonamento, suporte a MCP (Model Context Protocol), gerenciamento de cotas para múltiplos usuários e fine-tuning direto na interface. Em outras palavras, está se tornando não apenas um executor de modelos, mas uma plataforma completa para indivíduos e equipes.
IA com foco em privacidade finalmente se torna prática
Há uma frase no README do LocalAI que resume todo o apelo: "seus dados nunca saem da sua infraestrutura". Quando você executa o LocalAI, cada requisição de API permanece nas suas próprias máquinas. Sem vazamento de prompts, sem seus dados treinando o modelo de outra pessoa, sem dor de cabeça com conformidade. Combinado com o suporte a fine-tuning e quantização, você pode construir uma stack de IA totalmente privada que ainda segue padrões abertos.
O projeto possui licença MIT e é mantido por Ettore Di Giacinto e uma comunidade ativa. Você pode navegar pelos modelos na galeria de modelos do LocalAI ou simplesmente seguir o guia de início rápido no GitHub. Quando você se aprofundar, provavelmente vai concordar: o LocalAI é a coisa mais próxima que temos de uma forma universal, aberta e eticamente sensata de executar IA nos seus próprios termos.
Artigos relacionados
Deep-Live-Cam 2.1.6: Troca de rostos em tempo real com uma única foto
Descubra o Deep-Live-Cam, a ferramenta de código aberto que troca rostos em tempo real com uma única imagem. Aprenda a instalá-lo e usá-lo de forma responsável.
Hermes Agent: a IA autoaprimorável que aprende com cada tarefa
Hermes Agent é um agente de IA open source da Nous Research que aprende habilidades ao longo do tempo, lembra do seu contexto e pode rodar no celular, no notebook ou em um VPS de US$ 5.
Humanizer: A Ferramenta de Código Aberto que Faz a Escrita de IA Soar Humana
O Humanizer reescreve textos que soam como IA em prosa natural e humana usando 35 padrões da página “Signs of AI writing”, da Wikipédia. Veja como funciona, com exemplos de antes e depois e passos de instalação.
Conheça o VoiceStudio: clonagem de voz gratuita e local para 646 idiomas
O VoiceStudio coloca no seu desktop um estúdio de voz gratuito, open source e com processamento local. Clone qualquer voz com apenas 3 segundos de áudio e gere conteúdo em 646 idiomas sem pagar nada.