
LocalAI: LLMs, Bilder & Videos auf jeder Hardware ausführen – ganz ohne GPU
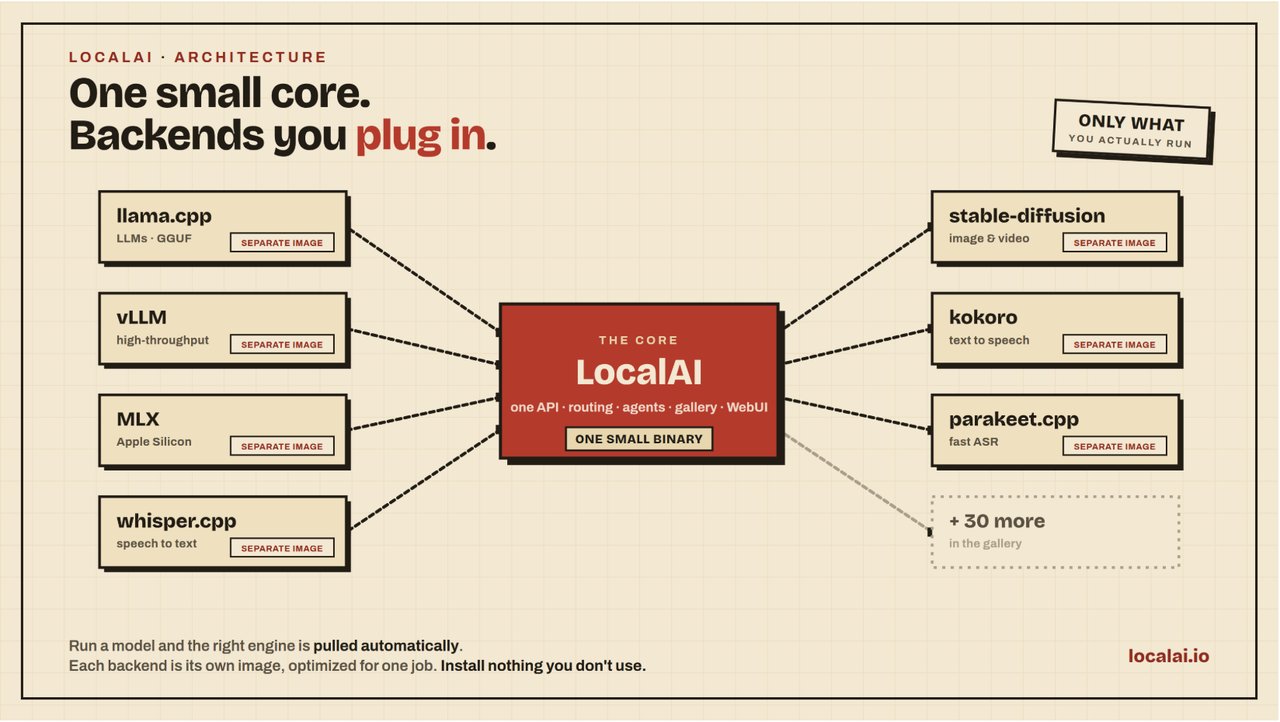
Seien wir ehrlich: 2026 fragten wir uns alle, ob das Ausführen von KI bedeutet, eine Niere für eine Rechenzentrums-GPU zu verkaufen. Dann kamen Open-Source-Projekte wie LocalAI und drehten den Spieß um. LocalAI ist eine selbst gehostete, quelloffene KI-Engine, die LLMs, Bildgenerierung, Videomodelle, Spracherkennung, Text-to-Speech und vieles mehr ausführen kann – auf Ihrem eigenen Rechner, ganz ohne GPU und bei vollständiger Privatsphäre. Wenn Sie nach einem Weg gesucht haben, dem API-Lock-in zu entkommen, ist das Ihre Eintrittskarte.
Was macht LocalAI anders?
Das Projekt beschreibt sich selbst mit den Worten „ein kleiner Kern, kein Bündel“. Statt jede mögliche Abhängigkeit in einer einzigen riesigen Binärdatei auszuliefern, ist LocalAI modular aufgebaut: Jedes Backend kapselt eine bewährte Engine wie llama.cpp, vLLM, whisper.cpp, stable-diffusion oder MLX in einem eigenen Container-Image. Dieses Backend wird nur dann heruntergeladen, wenn ein Modell es tatsächlich benötigt. Das bedeutet: Sie installieren keinen Berg von Software, die Sie nie verwenden werden, und Sie können LocalAI mit benutzerdefinierten Backends in jeder Sprache erweitern.
LocalAI ist außerdem ein sofort einsetzbarer Ersatz für APIs, die Sie bereits kennen. Es ist mit der OpenAI-API, der Anthropic-API und der ElevenLabs-Audio-API in allen Modalitäten kompatibel. Wenn Sie also bereits Code für eine gehostete API geschrieben haben und lokal betreiben möchten, müssen Sie in der Regel nur die Endpunkt-URL ändern.
Die Magie ohne GPU
Die meisten gängigen Modelle laufen auf der CPU problemlos, aber langsamer, und LocalAI unterstützt Hardwarebeschleunigung, sofern vorhanden: NVIDIA (CUDA 12/13), AMD (ROCm), Intel (oneAPI), Apple Silicon (Metal), Vulkan und sogar NVIDIA-Jetson-Geräte. Sie können mit einem einfachen CPU-Laptop beginnen und später zu einer GPU wechseln, ohne Ihren Arbeitsablauf zu ändern. LocalAI erkennt Ihre GPU-Fähigkeiten außerdem automatisch und lädt das passende Backend, sodass Sie nicht mit Dutzenden von Umgebungsvariablen herumspielen müssen.
Installation in zehn Sekunden
Der Einstieg in LocalAI ist wirklich schmerzlos. Der schnellste Weg führt über Docker. Für reine CPU-Nutzung führen Sie diesen Einzeiler aus:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
Haben Sie eine NVIDIA-GPU? Wählen Sie das passende CUDA-Image und fügen Sie --gpus all hinzu:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
AMD-Fans können das HIPBLAS-Image mit ein paar Geräte-Flags verwenden, während Intel- und Vulkan-Nutzer ebenfalls eigene Images haben. Wenn Sie native Anwendungen bevorzugen, gibt es ein offizielles macOS-DMG – denken Sie nur daran, nach der Installation das Quarantäne-Attribut zu entfernen, da Apple es nicht signiert hat. Den genauen Befehl finden Sie in der README des Projekts.
Modelle laden: ein Befehl, unendlich viele Möglichkeiten
Der einfachste Weg, ein Modell zu laden, führt über das integrierte Befehlszeilentool. LocalAI gibt Ihnen einen Befehl, um alle Modelle zu laden:
local-ai run llama-3.2-1b-instruct:q4_k_m
Das lädt ein Modell aus der LocalAI-Modellgalerie. Sie sind jedoch nicht auf diese Galerie beschränkt. Sie können Modelle direkt von Hugging Face, aus der Ollama-Registry oder aus jeder Standard-OCI-Registry laden:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
Sie können LocalAI sogar mit einer YAML-Konfigurationsdatei füttern, um die Einstellungen und die Kontextlänge des Modells genau nach Ihren Wünschen festzulegen.
Chatten Sie mit Ihrem Terminal-Agenten
Sobald Ihr Modell geladen ist, gibt es einen experimentellen, aber sehr coolen integrierten Terminal-Agenten. Statt einer einfachen REPL kann dieser Agent Dateien lesen, Fragen beantworten und Befehle auf Ihrem Rechner ausführen. Bevor er etwas ändert, fragt er um Genehmigung, sodass Sie die Kontrolle behalten. Starten Sie den Server in einem Terminal:
local-ai run llama-3.2-1b-instruct:q4_k_m
Öffnen Sie dann eine weitere Shell und sprechen Sie mit ihm:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
Während Sie chatten, können Sie /models eingeben, um installierte Modelle anzuzeigen, und /model <name>, um mitten im Gespräch zwischen ihnen zu wechseln. Das ist praktisch, aber wenn Sie noch nicht bereit sind, einer KI Zugriff auf Ihr Terminal zu gewähren, läuft auf Port 8080 ein regulärer OpenAI-kompatibler Chat-Server, den Sie mit jedem beliebigen Client verwenden können.
Was kann LocalAI eigentlich?
Die Funktionsliste von LocalAI ist wirklich überwältigend. Auf der Textseite erhalten Sie Textgenerierung, Embeddings, Re-Ranker, eine Vision-API und OpenAI-kompatible Werkzeuge. Im Audio-/Sprachbereich gibt es Audio-zu-Text, Text-zu-Audio, Echtzeit-Sprache-zu-Sprache mit WebRTC, Sprachaktivitätserkennung und sogar Sprecher-Diarisierung. Bildgenerierung, Videogenerierung, Objekterkennung und Tiefenschätzung stehen ebenfalls auf dem Programm. Wenn Sie strukturierte Ausgaben benötigen, unterstützt es eingeschränkte Grammatiken und JSON-Schemata.
Die Backend-Galerie umfasst über 60 Backends. Einige sind native Engines, die das LocalAI-Team in C++/GGML entwickelt hat – wie parakeet.cpp für Transkription, voice-detect.cpp für Sprechererkennung und free-splatter.cpp, das aus einer Handvoll Fotos 3D-Gaussians ganz ohne GPU und ohne Kamerapositionen erzeugt. Das sind keine bloßen Wrapper, sondern von Grund auf neu geschriebene C++-Implementierungen ohne Python-Inferenz zur Laufzeit – eine beeindruckende Leistung für die Portabilität.
Neuere Releases haben einen verteilten Modus mit VRAM-bewusstem Routing und Autoscaling, MCP-Unterstützung (Model Context Protocol), Multi-User-Quotenverwaltung und Fine-Tuning direkt in der UI hinzugefügt. Mit anderen Worten: LocalAI wird nicht nur zu einem Modell-Runner, sondern zu einer vollständigen Plattform für Einzelpersonen und Teams.
Privacy-first-KI ist endlich praktikabel
In der LocalAI-README gibt es einen Satz, der den gesamten Reiz zusammenfasst: „Ihre Daten verlassen nie Ihre Infrastruktur.“ Wenn Sie LocalAI ausführen, bleibt jede API-Anfrage auf Ihren eigenen Maschinen. Keine durchgesickerten Prompts, keine Daten, die das Modell eines Fremden trainieren, keine Compliance-Kopfschmerzen. In Kombination mit der Unterstützung für Fine-Tuning und Quantisierung können Sie einen vollständig privaten KI-Stack aufbauen, der dennoch offene Standards einhält.
Das Projekt steht unter der MIT-Lizenz und wird von Ettore Di Giacinto und einer aktiven Community gepflegt. Sie können Modelle in der LocalAI-Modellgalerie durchstöbern oder einfach dem Schnellstart auf GitHub folgen. Sobald Sie sich näher damit beschäftigen, werden Sie vermutlich zustimmen: LocalAI ist das, was einer universellen, offenen und ethisch vertretbaren Möglichkeit, KI zu Ihren eigenen Bedingungen zu betreiben, am nächsten kommt.
Verwandte Artikel
Deep-Live-Cam 2.1.6: Echtzeit-Gesichtstausch mit nur einem Foto
Entdecken Sie Deep-Live-Cam, das Open-Source-Tool, das Gesichter in Echtzeit mit nur einem Bild austauscht. Erfahren Sie, wie Sie es installieren und verantwortungsvoll nutzen.
Hermes Agent: Die selbstverbessernde KI, die aus jeder Aufgabe lernt
Hermes Agent ist ein Open-Source-KI-Agent von Nous Research, der mit der Zeit Fähigkeiten erlernt, deinen Kontext merkt und auf einem Smartphone, Laptop oder einer 5-Dollar-VPS laufen kann.
Humanizer: Das Open-Source-Tool, das KI-Texte menschlich klingen lässt
Humanizer macht aus KI-klingenden Texten natürliche, menschliche Prosa – mit 35 Mustern der Wikipedia-Seite „Signs of AI writing“. So funktioniert es, mit Vorher-nachher-Beispielen und der Anleitung zur Installation.
Wir stellen vor: VoiceStudio – kostenlose lokale Stimmklonierung für 646 Sprachen
VoiceStudio bringt ein kostenloses Open-Source-Studio für lokale Sprachverarbeitung auf Ihren Desktop. Klonen Sie jede Stimme mit einer 3-Sekunden-Audioprobe und generieren Sie Sprache in 646 Sprachen – ohne einen Cent auszugeben.