
LocalAI: Esegui LLM, immagini e video su qualsiasi hardware, senza bisogno di GPU
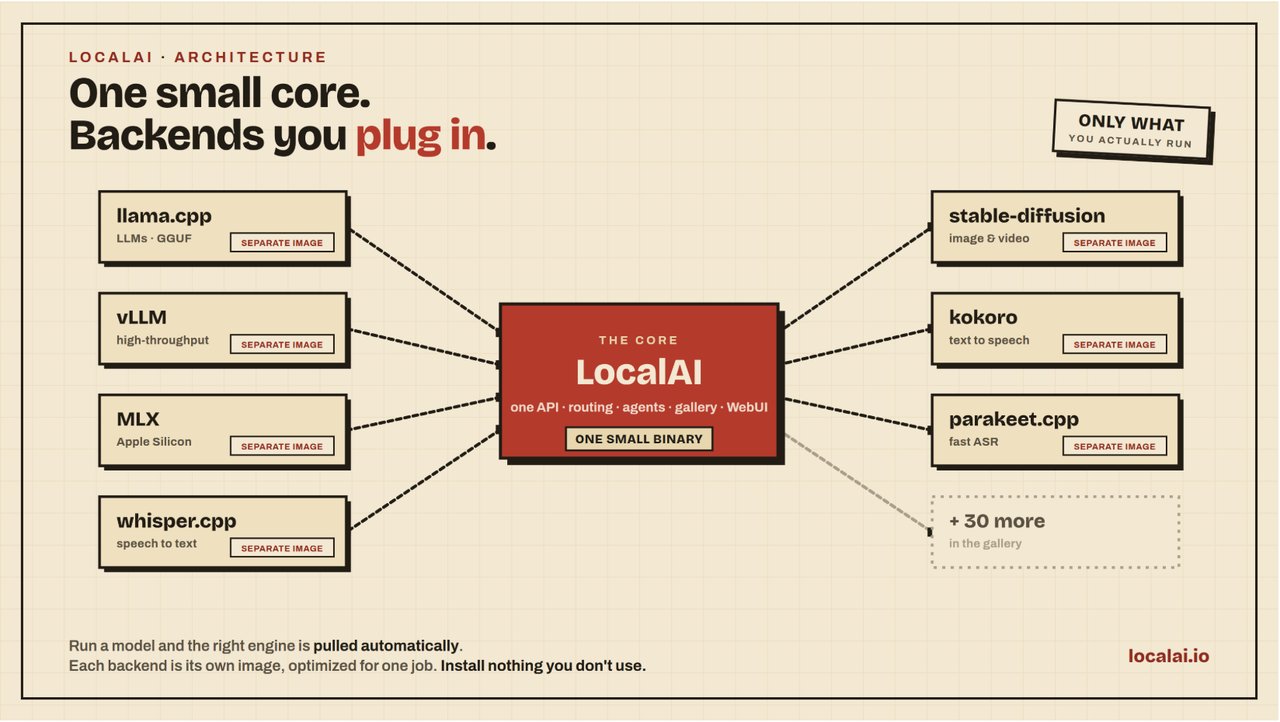
Siamo onesti: il 2026 ci ha fatto chiedere se eseguire l'IA significasse vendere un rene per una GPU da data center. Poi sono arrivati progetti open source come LocalAI e hanno ribaltato la situazione. LocalAI è un motore di IA open source e self-hosted in grado di eseguire LLM, generazione di immagini, modelli video, riconoscimento vocale, sintesi vocale e molto altro — sulla tua macchina, senza GPU e con piena privacy. Se stavi cercando un modo per sfuggire al lock-in delle API, questo è il tuo biglietto.
Cosa rende LocalAI diverso?
Il progetto si descrive come 'un piccolo nucleo, non un pacchetto'. Invece di includere ogni possibile dipendenza in un unico binario gigante, LocalAI è progettato per essere componibile: ogni backend racchiude un motore collaudato come llama.cpp, vLLM, whisper.cpp, stable-diffusion o MLX nella propria immagine container. Quel backend viene scaricato solo quando un modello lo richiede effettivamente. Questo significa che non installi una montagna di software che non userai mai e puoi estendere LocalAI con backend personalizzati in qualsiasi linguaggio.
LocalAI è anche un sostituto diretto delle API che già conosci. È compatibile con l'API OpenAI, l'API Anthropic e l'API audio ElevenLabs in tutte le sue modalità. Quindi, se hai già codice scritto per un'API ospitata e decidi di passare al locale, di solito tutto ciò che devi cambiare è l'URL dell'endpoint.
La magia senza GPU
La maggior parte dei modelli più popolari funziona bene su CPU, ma più lentamente, e LocalAI supporta l'accelerazione hardware quando è disponibile: NVIDIA (CUDA 12/13), AMD (ROCm), Intel (oneAPI), Apple Silicon (Metal), Vulkan e persino dispositivi NVIDIA Jetson. Puoi iniziare con un singolo laptop con CPU, per poi passare a una GPU in un secondo momento senza modificare il tuo flusso di lavoro. LocalAI rileva automaticamente le capacità della tua GPU e recupera il backend giusto, quindi non devi armeggiare con decine di variabili d'ambiente.
Installazione in dieci secondi
Iniziare con LocalAI è davvero indolore. Il percorso più veloce è Docker. Per la sola CPU, esegui questo comando in una riga:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
Hai una GPU NVIDIA? Scegli l'immagine CUDA corrispondente e aggiungi --gpus all:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
Gli appassionati AMD possono usare l'immagine HIPBLAS con un paio di flag di dispositivo, mentre gli utenti Intel e Vulkan hanno anch'essi immagini dedicate. Se preferisci le app native, c'è un DMG ufficiale per macOS — ricorda solo di rimuovere l'attributo di quarantena dopo l'installazione, dato che Apple non lo ha firmato. Troverai il comando esatto nel README del progetto.
Caricamento dei modelli: un comando, infinite scelte
Il modo più semplice per caricare un modello è tramite lo strumento da riga di comando integrato. LocalAI ti offre un comando per dominarli tutti:
local-ai run llama-3.2-1b-instruct:q4_k_m
Questo recupera un modello dalla galleria di modelli di LocalAI. Ma non sei limitato a quella galleria. Puoi scaricare modelli direttamente da Hugging Face, dal registro di Ollama o da qualsiasi registro OCI standard:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
Puoi persino indicare a LocalAI un file di configurazione YAML per definire le impostazioni del modello e la lunghezza del contesto esattamente come desideri.
Chatta con il tuo agente da terminale
Una volta caricato il modello, c'è un agente da terminale integrato, sperimentale ma molto interessante. Invece di limitarsi a un semplice REPL, questo agente può leggere file, rispondere a domande ed eseguire comandi sulla tua macchina. Chiede l'approvazione prima di modificare qualsiasi cosa, così mantieni il controllo. In un terminale, avvia il server:
local-ai run llama-3.2-1b-instruct:q4_k_m
Poi apri un'altra shell e parlagli:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
Mentre chatti, puoi digitare /models per vedere i modelli installati e /model <nome> per passare da uno all'altro a metà conversazione. È utile, ma se non sei pronto a lasciare che un'IA tocchi il tuo terminale, c'è un normale server di chat compatibile con OpenAI attivo sulla porta 8080 e puoi usare qualsiasi client tu preferisca.
Cosa può fare realmente LocalAI?
L'elenco delle funzionalità di LocalAI è davvero travolgente. Sul fronte del testo, trovi generazione testuale, embedding, reranker, un'API Vision e strumenti compatibili con OpenAI. Per il parlato, ci sono la trascrizione da audio a testo, la sintesi da testo a audio, la conversazione vocale in tempo reale con WebRTC, il rilevamento dell'attività vocale e persino la diarizzazione dei parlanti. Anche la generazione di immagini, la generazione video, il rilevamento di oggetti e la stima della profondità sono disponibili. Se hai bisogno di output strutturati, supporta grammatiche vincolate e schemi JSON.
La galleria di backend ne include oltre 60. Alcuni sono motori nativi creati dal team di LocalAI in C++/GGML, come parakeet.cpp per la trascrizione, voice-detect.cpp per il riconoscimento dei parlanti e free-splatter.cpp, che può trasformare una manciata di foto in gaussiane 3D senza GPU e senza pose della fotocamera. Non sono solo wrapper; sono implementazioni C++ scritte da zero senza inferenza Python in fase di esecuzione: un'impresa notevole per la portabilità.
Le versioni recenti hanno aggiunto la modalità distribuita con routing consapevole della VRAM e autoscaling, il supporto MCP (Model Context Protocol), la gestione delle quote multiutente e il fine-tuning direttamente nell'interfaccia. In altre parole, sta diventando non solo un esecutore di modelli, ma una piattaforma completa per singoli e team.
L'IA privacy-first è finalmente pratica
C'è una frase nel README di LocalAI che riassume tutto il fascino: 'i tuoi dati non lasciano mai la tua infrastruttura.' Quando esegui LocalAI, ogni richiesta API rimane sulle tue macchine. Nessuna fuga di prompt, nessun dato che addestra il modello di uno sconosciuto, nessun mal di testa per la conformità. Combinato con il supporto per il fine-tuning e la quantizzazione, puoi costruire uno stack IA completamente privato che segue comunque standard aperti.
Il progetto è concesso in licenza MIT ed è mantenuto da Ettore Di Giacinto e una community attiva. Puoi sfogliare i modelli nella galleria di modelli di LocalAI o semplicemente seguire la guida rapida su GitHub. Una volta che ti addentri, probabilmente sarai d'accordo: LocalAI è la cosa più vicina che abbiamo a un modo universale, aperto ed eticamente sensato di eseguire l'IA alle tue condizioni.
Articoli correlati
Deep-Live-Cam 2.1.6: Scambio di volti in tempo reale con una sola foto
Scopri Deep-Live-Cam, lo strumento open source che scambia volti in tempo reale con una sola immagine. Impara a installarlo e a usarlo in modo responsabile.
Hermes Agent: un'IA auto-migliorante che impara da ogni attività
Hermes Agent è un agente IA open source di Nous Research che impara abilità col tempo, ricorda il tuo contesto e può girare su telefoni, laptop o un VPS da 5 dollari.
Humanizer: lo strumento open-source che rende umana la scrittura AI
Humanizer riscrive i testi dal sapore artificiale in una prosa naturale e umana usando 35 pattern tratti dalla pagina 'Signs of AI writing' di Wikipedia. Ecco come funziona, con esempi prima/dopo e passaggi per l'installazione.
Introduzione a VoiceStudio: clonazione vocale gratuita e locale in 646 lingue
VoiceStudio porta sul desktop uno studio vocale gratuito, open source e locale. Clona qualsiasi voce con 3 secondi di audio e genera contenuti in 646 lingue senza spendere un centesimo.