
Riverflow 2.6 Pro 先請好評審,才把圖拿給你看
Sourceful 在 10 月 29 日發布 Riverflow 2.6 Pro,關於它,第一件值得說的事是:它其實不是拿來當「圖像模型」賣的。它賣的是一套有主見的工作流程。模型頁上的描述讀起來像職缺說明:一個內建的推理模型負責規劃多步驟編修、評選候選結果,通過了才交出成品。推理強度是一個四段式旋鈕,調得越高,編修回合越多、內部評審也越嚴格。
把這種東西擺在一個圖像生成器前面有點奇怪,而這正是它最有趣的地方。大多數模型要你描述想要的東西,然後幫你擲骰子。這個模型會問你想要什麼、提出一條路徑、走完那條路,最後在交還任何東西之前先替自己的成品打分。
規格,簡短版
Riverflow 2.6 Pro 是 2.6 家族的旗艦,在同一條管線裡同時處理文生圖與圖生圖。編修時最多可吃 10 張輸入圖。上下文支援到 33K。輸出尺寸是主打功能:你不必挑預設值,可以直接傳入字面上的 WIDTHxHEIGHT,單邊最長 16,384 像素,總計 16.8 百萬像素,長寬比最極端可到 16:1。1K/2K/4K 預設值還在,而且現在多了 5:4 和 4:5。
價格從每張圖 0.13 美元起——「起」這個字在這裡責任重大。實際費用要在任務完成時,依可計費的處理量結算。推理強度、輸出尺寸、編修複雜度都會推高這個數字。在 playground 跑一個 1280×720 的任務,顯示 $0.1501、91 秒。如果你習慣用「每張圖幾分錢」思考,這個模型要你改成「每件任務幾分錢」,而任務的長度是可變的。
三個功能,透露它是給誰用的
規格表上大部分都是基本盤。有意思的是那些只有在你大量生產商用圖像時才重要的部分。
自訂字體。你可以透過 font_inputs 傳入最多兩份字體參考,模型會試著對上字形、字距與字重。做過行銷活動的人都知道這在解什麼問題:圖很漂亮,標題用的字體卻只是「很像」你的品牌字,整張圖就不能用。字體對不對不是創意問題,是合規問題,把它當成第一級輸入是對的。
自訂評分。你可以提供 scoring_prompt 和 scoring_rubric,推理模型就會用你的標準、而不是它自己的標準去評估候選結果。這個功能我猜會最快被抄走。它的意思是:你可以告訴評審「logo 至少要佔畫面寬度 12%,而且不能被遮住」,然後它真的會去檢查。「生成一張漂亮的圖」和「生成一張能過品牌審查的圖」之間的差距,正是大多數量產預算陣亡的地方。
背景控制。原始、透明,或是指定 hex 值的純色。很不炫,但那正是「可直接使用的素材」和「還要進 Photoshop 開一輪」的差別。
這個評審到底替你買到什麼
有一種很實在的質疑:自我評分只是表演。模型評自己的產出,等於自己改自己的考卷,它發明出來的評分標準一定會討好自己剛做出來的東西。這套實作之所以比那個批評更有意思,是因為那份標準可以是你的,不是它的。
當你交給它一段評分提示,你等於把品味問題轉換成檢查表問題。這跟好的藝術指導做的事一樣:創意總監不會說「讓它更跳」,他會說「這個產品在縮圖尺寸下也要讀得出來」。標準一旦明確,模型就能對著它最佳化。而且跟真人修圖師不同的地方在於,它可以整晚重複一百次而不會膩。
代價是延遲。在 OpenRouter 上,端到端 P50 大約 104 秒,P90 約 171 秒,P99 超過 327 秒。如果你只是產一張主視覺,那沒問題。如果你要為一次測試產 200 個變體,那就是一個半小時的牆上時鐘,你會想把它丟進一個不在乎你感受的佇列裡跑。
另一個要盯的數字是可用率:三天內 88.55%,uptime 則是 100%。翻譯一下:端點連得到,但大約每九個請求就有一個沒有回傳推論結果。對一個每次嘗試要價五分之一美元的模型來說,這很煩。對一個你已經把整條管線綁上去的模型來說,這是上線前就得先寫好的重試策略。
橫向比較
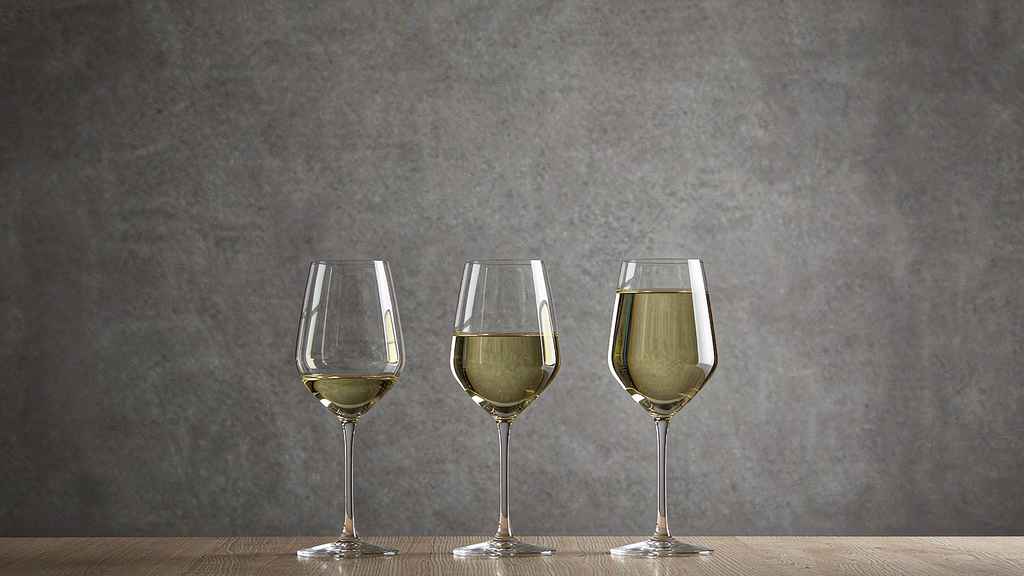
在 OpenRouter 的共用圖像基準測試裡——那個「倒到杯緣的葡萄酒杯」提示詞,專門用來抓那些因為訓練資料如此、所以把杯子畫成三分滿的模型——Riverflow V2.6 Pro 以 $0.157 通過 4 項中的 3 項。Nano Banana 2 和 2.1 以 $0.06 和 $0.035 通過 4 項全數。GPT-5.4 Image 2 以 $0.006 通過 4 項全數。
誠實讀完會有點痛。在一個通用的指令遵循測試上,Riverflow 不但更貴,準確度還不如價格只有它十分之一的模型。不過這個比較也不公平,因為葡萄酒杯測試只量一件事:模型是否服從一個不尋常的指令。它完全沒說標題字體對不對、透明度乾不乾淨,或 16:1 的橫幅實際上構圖成不成立。
而這正是這類模型存在的理由。如果你的工作是「畫一張杯子的圖」,那你該用那個 0.6 美分的模型,然後不要再讀下去了。如果你的工作是「產出四十份能通過法務審查的品牌素材」,那張爛圖的代價不是那六分錢,而是設計師花二十分鐘修它,再乘以四十。
你該不該用
如果你只是做一次性的創意探索,不要。延遲和浮動價格會讓你煩躁,而且便宜的模型比你想像中更常畫出更漂亮的圖。
如果你是在為某個品牌建立素材產線——包裝、零售、社群,任何對字體和背景有要求的東西——那值得花一個下午測試。設定一份能編碼你實際審查清單的評分標準,用中等推理強度跑一輪,看看這個評審抓不抓得到你的藝術總監會抓的東西。這比任何排行榜都更能測出東西。
更宏觀的觀察是:圖像模型正在分裂成兩類,一類負責生成,一類負責產出。Riverflow 明確屬於後者,而且它的定價方式,像是很清楚這中間的差距是用修圖時數、而不是用幾分錢來衡量的。
相關文章
Meta 最怪的幾個 AI App,先丟到東南亞試水溫
印尼、新加坡、泰國的 AI 試衣間,菲律賓的寵物日記本。兩個都沒發布,而這正是重點。
Ollie 有 SOC 2、有 750 萬美元,還是打不贏 Muse
一款隱私優先的家庭助理,有 Khosla 領投的種子輪,有貨真價實的 SOC 2 稽核,11 月 6 日還是要關。教訓不在隱私,而在通路。
Runware 想用底特律造車的方式蓋資料中心
2028 年做到每天 30 兆瓦、pod 到場 48 小時上線、每月 1 吉瓦。AI 容量的瓶頸已經不是晶片,而是蓋一棟建築要花的兩年。
Genspark 把一整組拍片團隊,收成了一張選單
三個語言模型當導演,七十個模型版本負責執行,而你的工作變成連續三十五次的核准。實際用起來,編排式影片製作到底是什麼感覺。