
Riverflow 2.6 Pro engage un juge avant de vous montrer l'image
Sourceful a publié Riverflow 2.6 Pro le 29 octobre, et la première chose à en dire, c'est qu'il n'est pas vraiment vendu comme un modèle d'image. Il est vendu comme un workflow avec un point de vue. La description de sa fiche modèle se lit comme une fiche de poste : un modèle de raisonnement intégré planifie des retouches en plusieurs étapes, juge les candidats, et n'accepte un résultat qu'ensuite. L'effort de raisonnement est un curseur à quatre positions. Plus le réglage est élevé, plus il y a de passes de retouche et plus le juge interne est sévère.
C'est une chose étrange à mettre devant un générateur d'images, et c'est ce qu'il a de plus intéressant. La plupart des modèles vous demandent de décrire ce que vous voulez puis jettent les dés. Celui-ci demande ce que vous voulez, propose un chemin, le parcourt, et note son propre travail avant de rendre quoi que ce soit.
Les specs, en bref
Riverflow 2.6 Pro est le fer de lance d'une famille 2.6 qui traite le texte-vers-image et l'image-vers-image dans un seul pipeline. Il accepte jusqu'à 10 images d'entrée pour l'édition. Il prend un contexte de 33K. Le dimensionnement de sortie est la fonction phare : au lieu de choisir un préréglage, vous pouvez passer un WIDTHxHEIGHT littéral, jusqu'à 16 384 pixels sur un côté, 16,8 mégapixels au total, et un ratio aussi extrême que 16:1. Les préréglages 1K/2K/4K existent toujours, et incluent désormais 5:4 et 4:5.
Le tarif démarre à 0,13 $ par image, et ce mot « démarre » porte beaucoup. Le coût est finalisé par tâche à l'achèvement, selon le traitement facturable. L'effort de raisonnement, la taille de sortie et la complexité de l'édition font tous bouger le chiffre. Une tâche en 1280×720 dans le playground affiche 0,1501 $ et 91 secondes. Si vous avez l'habitude de raisonner en centimes par image, ce modèle vous demande de raisonner en centimes par tâche, où la tâche a une durée variable.
Les trois fonctions qui révèlent à qui il s'adresse
L'essentiel de la fiche technique est un ticket d'entrée. Les parties intéressantes sont celles qui ne comptent que si vous produisez de l'image commerciale en volume.
Polices personnalisées. Vous pouvez passer jusqu'à deux références de police via font_inputs, et le modèle tentera de retrouver le lettering, l'interlettrage et la graisse. Quiconque a livré une campagne connaît le mode de défaillance que ça vise : l'image est superbe, le titre est dans une police qui ressemble presque à votre police de marque, et l'ensemble est inutilisable. Faire correspondre la typo n'est pas un problème créatif, c'est un problème de conformité, et la traiter comme une entrée de première classe est le bon choix.
Notation personnalisée. Vous pouvez fournir un scoring_prompt et un scoring_rubric, et le modèle de raisonnement évaluera les candidats selon vos critères plutôt que les siens. C'est la fonction que je m'attends à voir copiée en premier. Elle signifie qu'on peut dire au juge « le logo doit occuper au moins 12 % de la largeur du cadre et ne doit pas être masqué », et qu'il vérifie vraiment. L'écart entre « génère quelque chose de joli » et « génère quelque chose qui passe la revue de marque », c'est là que meurent la plupart des budgets de production.
Contrôle du fond. Original, transparent, ou une couleur unie avec une valeur hexadécimale. Peu glamour, et pourtant c'est la différence entre un asset utilisable et une session Photoshop.
Ce que le juge vous achète vraiment
Il y a un argument solide pour dire que l'auto-notation est du théâtre. Un modèle qui juge sa propre sortie corrige sa propre copie, et la grille qu'il invente flattera ce qu'il vient de faire. Ce qui rend cette implémentation plus intéressante que la critique, c'est que la grille peut être la vôtre, pas la sienne.
Quand vous lui donnez un prompt de notation, vous convertissez un problème de goût en problème de checklist. C'est le même geste que fait une bonne direction artistique : une directrice de création ne dit pas « fais péter », elle dit « le produit doit rester lisible en taille vignette ». Une fois le critère explicite, un modèle peut optimiser dessus. Et contrairement à un retoucheur humain, il peut le faire cent fois dans la nuit sans s'ennuyer.
Le coût, c'est la latence. Le temps de bout en bout P50 sur OpenRouter est d'environ 104 secondes, avec un P90 autour de 171 et un P99 au-delà de 327. Si vous générez une seule image hero, ça va. Si vous générez 200 variantes pour un test, c'est une heure et demie de temps réel, et vous voudrez lancer ça dans une file qui se moque de vos états d'âme.
La disponibilité est l'autre chiffre à surveiller : 88,55 % sur trois jours, avec un uptime de 100 %. Traduction : l'endpoint est joignable, mais environ une requête sur neuf n'a pas renvoyé d'inférence. Sur un modèle qui coûte un cinquième de dollar la tentative, c'est agaçant. Sur un modèle autour duquel vous avez bâti un pipeline, c'est une politique de retry à écrire avant le lancement.
Comment il se compare
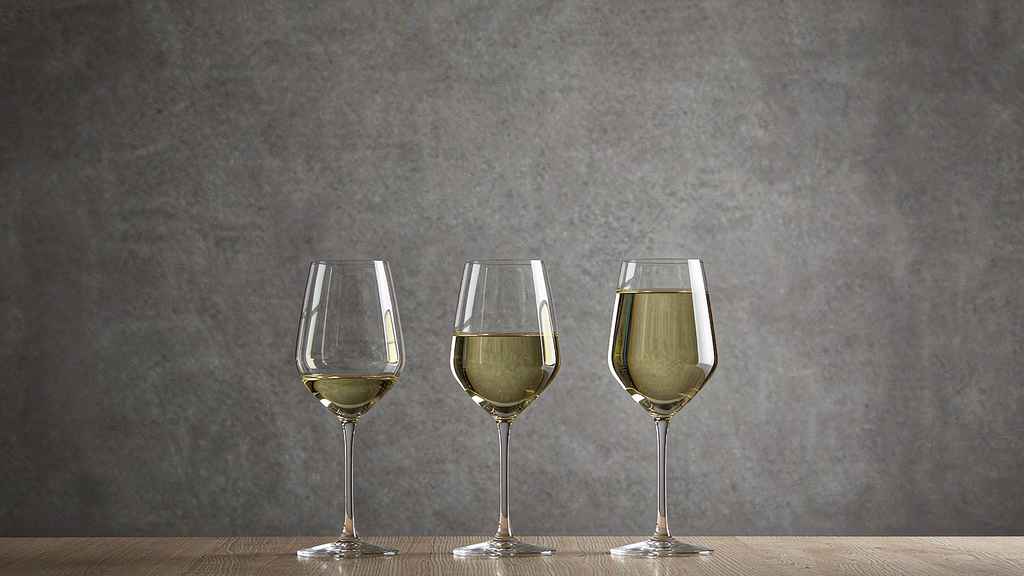
Sur le benchmark d'image partagé d'OpenRouter, le prompt du verre de vin rempli à ras bord, conçu pour attraper les modèles qui dessinent le verre au tiers parce que c'est ce que montrent leurs données d'entraînement, Riverflow V2.6 Pro passe 3 contrôles sur 4 à 0,157 $. Nano Banana 2 et 2.1 passent 4 sur 4 à 0,06 $ et 0,035 $. GPT-5.4 Image 2 passe 4 sur 4 à 0,006 $.
Lu honnêtement, ça fait un peu mal. Sur un test générique de suivi de prompt, Riverflow est à la fois plus cher et moins précis que des modèles dix fois moins chers. La comparaison est aussi injuste, parce que le test du verre de vin mesure une seule chose : si le modèle obéit à une instruction inhabituelle. Il ne dit rien de la question de savoir si le titre est dans la bonne police, si la transparence est propre, ou si la bannière en 16:1 compose vraiment.
Ce qui est tout l'argument pour un modèle comme celui-là. Si votre travail est de faire l'image d'un verre, prenez le modèle à six dixièmes de centime et arrêtez de lire. Si votre travail est de produire quarante assets conformes à la marque qui survivent à une revue juridique, le coût d'une mauvaise image n'est pas les six centimes payés. C'est les vingt minutes de temps d'un designer pour la corriger, multipliées par quarante.
Faut-il l'utiliser
Si vous faites de l'exploration créative ponctuelle, non. La latence et la tarification variable vous agaceront, et des modèles moins chers feront de plus jolies images plus souvent que vous ne le pensez.
Si vous construisez un pipeline d'assets pour une marque (packaging, retail, social, tout ce qui implique une exigence de police et une exigence de fond), ça vaut un après-midi de tests. Écrivez une grille de notation qui encode votre vraie checklist de revue, lancez-le en raisonnement moyen, et voyez si le juge attrape ce que votre directeur artistique attrape. C'est un bien meilleur test que n'importe quel classement.
Le point plus large, c'est que les modèles d'image se scindent en deux catégories : ceux qui génèrent, et ceux qui produisent. Riverflow est fermement dans la seconde, et son prix semble savoir que la différence se mesure en heures de retouche plutôt qu'en centimes.
Articles associés
Meta teste ses applications IA les plus étranges d'abord en Asie du Sud-Est
Une cabine d'essayage IA en Indonésie, à Singapour et en Thaïlande. Un journal pour animaux aux Philippines. Aucune des deux apps n'a été annoncée, et c'est précisément le propos.
Ollie avait la certification SOC 2 et 7,5 millions de dollars. Ça n'a pas suffi face à Muse.
Un assistant familial axé sur la vie privée, un tour de table mené par Khosla et un vrai audit SOC 2 : Ollie ferme le 6 novembre. La leçon ne porte pas sur la confidentialité, mais sur la distribution.
Runware veut construire des data centers comme Detroit construisait des voitures
Trente mégawatts par jour d'ici 2028, des pods en ligne en 48 heures, un gigawatt par mois. La contrainte de la capacité IA n'est plus le silicium, mais les deux ans qu'il faut pour construire un bâtiment.
Genspark a transformé une équipe de tournage en menu
Trois modèles de langage réalisent, soixante-dix versions de modèles exécutent, et votre travail devient trente-cinq validations d'affilée. Ce que donne vraiment une production vidéo orchestrée.