
Riverflow 2.6 Pro assume un giudice prima di mostrarti l'immagine
Sourceful ha rilasciato Riverflow 2.6 Pro il 29 ottobre, e la prima cosa da dire è che non viene davvero venduto come modello di immagini. Viene venduto come un flusso di lavoro con un'opinione. La descrizione sulla pagina del modello sembra una specifica di ruolo: un modello di ragionamento integrato pianifica modifiche in più passaggi, giudica i candidati e solo alla fine accetta un risultato. Lo sforzo di ragionamento è una manopola a quattro posizioni. Impostazioni più alte significano più passaggi di editing e un giudice interno più severo.
È una cosa strana da mettere davanti a un generatore di immagini, ed è la cosa più interessante che ha. La maggior parte dei modelli ti chiede di descrivere cosa vuoi e poi tira i dadi. Questo chiede cosa vuoi, propone un percorso, lo percorre e valuta il proprio lavoro prima di consegnare qualcosa.
Le specifiche, in breve
Riverflow 2.6 Pro è il flagship di una famiglia 2.6 che gestisce text-to-image e image-to-image in un'unica pipeline. Accetta fino a 10 immagini di input per l'editing. Supporta un contesto da 33K. Il dimensionamento dell'output è la funzione di punta: invece di scegliere un preset, puoi passare un valore letterale WIDTHxHEIGHT, fino a 16.384 pixel su un lato, 16,8 megapixel in totale e un rapporto d'aspetto estremo come 16:1. I preset 1K/2K/4K esistono ancora e ora includono 5:4 e 4:5.
Il prezzo parte da 0,13 dollari per immagine, e quel «parte da» fa molto lavoro. Il costo viene finalizzato per job al completamento, in base all'elaborazione fatturabile. Sforzo di ragionamento, dimensione dell'output e complessità dell'editing muovono tutti la cifra. Un job 1280×720 nel playground mostra 0,1501 dollari e 91 secondi. Se sei abituato a ragionare in centesimi per immagine, questo modello ti chiede di ragionare in centesimi per job, dove il job ha una durata variabile.
Le tre funzioni che rivelano a chi è destinato
Buona parte della scheda tecnica è il minimo indispensabile. Le parti interessanti sono quelle che contano solo se produci immagini commerciali in volume.
Font personalizzati. Puoi passare fino a due riferimenti di font tramite font_inputs, e il modello proverà a replicare il lettering, la spaziatura e il peso. Chiunque abbia pubblicato una campagna conosce il modo di fallire a cui questo risponde: l'immagine è bellissima, il titolo è in un font che è quasi il tuo font di marca, e il tutto è inutilizzabile. Far combaciare la tipografia non è un problema creativo, è un problema di conformità, e trattarlo come input di prima classe è la scelta giusta.
Punteggio personalizzato. Puoi fornire uno scoring_prompt e una scoring_rubric, e il modello di ragionamento valuterà i candidati in base ai tuoi criteri invece che ai suoi. Questa è la funzione che mi aspetto venga copiata per prima. Significa poter dire al giudice «il logo deve occupare almeno il 12% della larghezza del fotogramma e non deve essere occluso», e che poi lo verifichi davvero. Lo scarto tra «genera qualcosa di bello» e «genera qualcosa che supera la revisione di marca» è dove muore la maggior parte dei budget di produzione.
Controllo dello sfondo. Originale, trasparente, o un colore pieno con un valore esadecimale. Poco glamour, ed è la differenza tra un asset utilizzabile e una sessione in Photoshop.
Cosa ti compra davvero il giudice
C'è un argomento serio secondo cui l'autovalutazione è teatro. Un modello che giudica il proprio output sta correggendo il proprio compito, e la rubrica che inventa lusingherà la cosa che ha appena fatto. Il motivo per cui questa implementazione è più interessante di quella critica è che la rubrica può essere la tua, non la sua.
Quando gli passi uno scoring prompt, stai convertendo un problema di gusto in un problema di checklist. È la stessa mossa che fa la buona direzione artistica: un direttore creativo non dice «fallo saltare all'occhio», dice «il prodotto deve leggersi alla dimensione di una thumbnail». Una volta che il criterio è esplicito, un modello può ottimizzare contro di esso. E a differenza di un retoucher umano, può farlo cento volte in una notte senza annoiarsi.
Il costo è la latenza. Il tempo end-to-end P50 su OpenRouter è di circa 104 secondi, con un P90 intorno ai 171 e un P99 oltre i 327. Se stai generando una singola immagine hero, va bene. Se stai generando 200 varianti per un test, sono un'ora e mezza di orologio, e vorrai farlo girare in una coda che non si preoccupa dei tuoi sentimenti.
La disponibilità è l'altro numero da tenere d'occhio: 88,55% su tre giorni, con uptime al 100%. Tradotto: l'endpoint è raggiungibile, ma circa una richiesta su nove non ha restituito inferenza. Su un modello che costa un quinto di dollaro per tentativo, è fastidioso. Su un modello intorno a cui hai costruito una pipeline, è una politica di retry che devi scrivere prima del lancio.
Il confronto
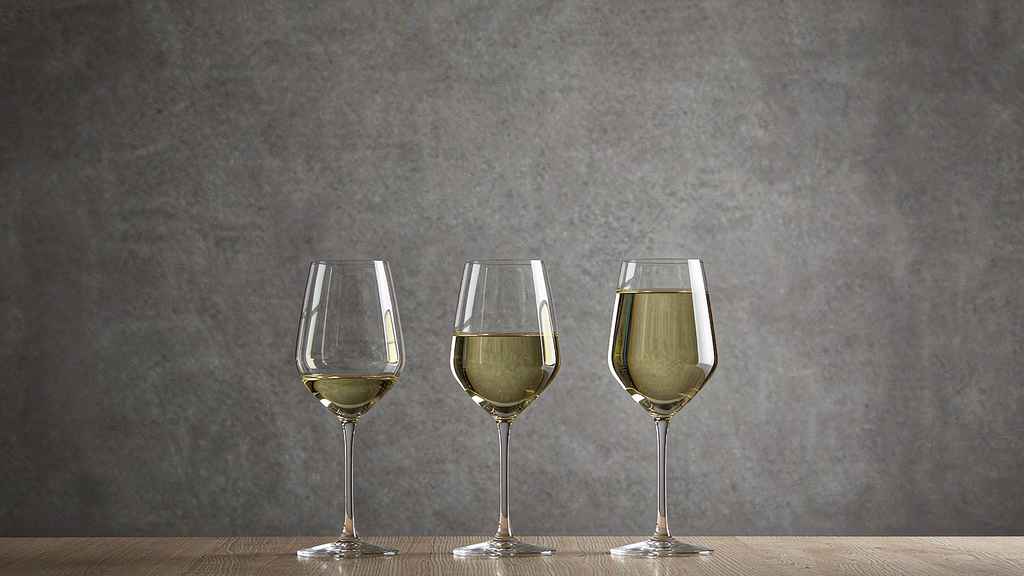
Sul benchmark condiviso delle immagini di OpenRouter — il prompt del «bicchiere di vino riempito fino all'orlo», pensato per smascherare i modelli che disegnano il bicchiere pieno a un terzo perché è ciò che mostrano i loro dati di addestramento — Riverflow V2.6 Pro supera 3 controlli su 4 a 0,157 dollari. Nano Banana 2 e 2.1 ne superano 4 su 4 a 0,06 e 0,035 dollari. GPT-5.4 Image 2 ne supera 4 su 4 a 0,006 dollari.
Letto onestamente, fa un po' male. Su un test generico di aderenza al prompt, Riverflow è sia più caro sia meno preciso di modelli che costano un decimo. Ma il confronto è anche ingiusto, perché il test del bicchiere misura una cosa sola: se il modello obbedisce a un'istruzione insolita. Non dice niente sul fatto che il titolo sia nel carattere giusto, che la trasparenza sia pulita o che il banner 16:1 componga davvero.
Che è poi tutto l'argomento a favore di un modello così. Se il tuo lavoro è «fammi la foto di un bicchiere», usa il modello da sei decimi di centesimo e smetti di leggere. Se il tuo lavoro è «produci quaranta asset coerenti con il brand che sopravvivano alla revisione legale», il costo di un'immagine sbagliata non sono i sei centesimi che hai pagato. Sono i venti minuti di un designer per sistemarla, moltiplicati per quaranta.
Dovresti usarlo
Se fai esplorazione creativa una volta ogni tanto, no. La latenza e il prezzo variabile ti daranno fastidio, e i modelli più economici faranno immagini più belle più spesso di quanto ti aspetti.
Se stai costruendo una pipeline di asset per un brand — packaging, retail, social, qualsiasi cosa con un requisito di carattere tipografico e uno di sfondo — vale un pomeriggio di test. Imposta una rubrica di valutazione che codifichi la tua vera checklist di revisione, falla girare a ragionamento medio e guarda se il giudice intercetta le cose che intercetta il tuo art director. È un test molto migliore di qualsiasi classifica.
Il punto più ampio è che i modelli di immagini si stanno dividendo in due categorie: quelli che generano e quelli che producono. Riverflow sta saldamente nella seconda, e ha un prezzo che sembra sapere che la differenza si misura in ore di ritocco più che in centesimi.
Articoli correlati
Meta testa le sue app AI più strane prima nel Sud-Est asiatico
Un camerino AI in Indonesia, Singapore e Thailandia. Un diario per animali nelle Filippine. Nessuno dei due è stato annunciato, e il punto è proprio questo.
Ollie aveva la SOC 2 e 7,5 milioni di dollari. E non è riuscita a superare Muse
Un assistente familiare privacy-first con un seed guidato da Khosla e un vero audit SOC 2 chiude il 6 novembre. La lezione non riguarda la privacy. Riguarda la distribuzione.
Runware vuole costruire data center come Detroit costruiva le auto
Trenta megawatt al giorno entro il 2028, pod online in 48 ore, un gigawatt al mese. Il vincolo sulla capacità AI ha smesso di essere i chip ed è diventato i due anni che servono per costruire un edificio.
Genspark ha trasformato una troupe in un menù
Tre modelli linguistici dirigono, settanta versioni di modelli eseguono, e il tuo lavoro diventa trentacinque approvazioni di fila. Come ci si sente davvero a produrre video orchestrati.