
Riverflow 2.6 Pro stellt einen Richter ein, bevor es dir das Bild zeigt
Sourceful hat Riverflow 2.6 Pro am 29. Oktober veröffentlicht, und das Erste, was man dazu sagen sollte: Es wird nicht wirklich als Bildmodell verkauft. Es wird als Workflow mit einer Meinung verkauft. Die Beschreibung auf der Modellseite liest sich wie ein Stellenprofil: Ein integriertes Reasoning-Modell plant mehrstufige Bearbeitungen, bewertet Kandidaten und akzeptiert erst dann ein Ergebnis. Der Reasoning-Aufwand ist ein Regler mit vier Stufen. Höhere Einstellungen bedeuten mehr Bearbeitungsdurchläufe und einen strengeren internen Richter.
Das ist eine seltsame Sache, um sie vor einen Bildgenerator zu stellen, und es ist das Interessanteste an ihm. Die meisten Modelle bitten dich, zu beschreiben, was du willst, und würfeln dann. Dieses fragt, was du willst, schlägt einen Weg vor, geht den Weg und benotet seine eigene Arbeit, bevor es etwas zurückgibt.
Die technischen Daten, kurz
Riverflow 2.6 Pro ist das Flaggschiff einer 2.6-Familie, die Text-zu-Bild und Bild-zu-Bild in einer Pipeline abwickelt. Es nimmt bis zu 10 Eingabebilder zur Bearbeitung. Es akzeptiert einen Kontext von 33K. Die Ausgabegröße ist das Kernfeature: Statt eine Voreinstellung zu wählen, kannst du ein wörtliches WIDTHxHEIGHT übergeben, bis zu 16.384 Pixel an einer Kante, 16,8 Megapixel insgesamt und ein Seitenverhältnis von bis zu 16:1. Die Voreinstellungen 1K/2K/4K gibt es weiterhin, jetzt auch in 5:4 und 4:5.
Der Preis beginnt bei 0,13 Dollar pro Bild, und das Wörtchen „beginnt“ leistet hier viel. Die Kosten werden pro Auftrag bei Abschluss festgelegt, basierend auf der abrechenbaren Verarbeitung. Reasoning-Aufwand, Ausgabegröße und Bearbeitungskomplexität verschieben die Zahl. Ein Auftrag mit 1280×720 im Playground zeigt 0,1501 Dollar und 91 Sekunden. Wer gewohnt ist, in Cent pro Bild zu denken, wird hier gebeten, in Cent pro Auftrag zu denken, wobei der Auftrag eine variable Länge hat.
Die drei Funktionen, die verraten, für wen es gedacht ist
Der größte Teil des Datenblatts ist Standard. Interessant sind die Teile, die nur zählen, wenn man kommerzielle Bildwelten in großem Umfang produziert.
Eigene Schriften. Du kannst bis zu zwei Schriftreferenzen über font_inputs übergeben, und das Modell versucht, Buchstabenformen, Laufweite und Strichstärke zu treffen. Wer schon einmal eine Kampagne ausgeliefert hat, kennt den Fehlerfall, den das adressiert: Das Bild ist schön, die Schlagzeile steht in einer Schrift, die fast deine Markenschrift ist, und das Ganze ist unbrauchbar. Typografie zu treffen ist kein kreatives Problem, sondern ein Compliance-Problem, und sie als erstklassige Eingabe zu behandeln ist die richtige Entscheidung.
Eigene Bewertung. Du kannst einen scoring_prompt und eine scoring_rubric mitgeben, und das Reasoning-Modell bewertet Kandidaten an deinen Kriterien statt an seinen eigenen. Das ist die Funktion, von der ich erwarte, dass sie zuerst kopiert wird. Sie bedeutet, dass man dem Richter sagen kann, das Logo müsse mindestens 12 Prozent der Bildbreite einnehmen und dürfe nicht verdeckt sein, und er prüft es dann tatsächlich. Die Lücke zwischen „etwas Hübsches generieren“ und „etwas generieren, das das Brand-Review besteht“ ist der Ort, an dem die meisten Produktionsbudgets sterben.
Hintergrundkontrolle. Original, transparent oder eine Volltonfarbe mit Hex-Wert. Unsinnspektakulär, und der Unterschied zwischen einem brauchbaren Asset und einer Photoshop-Sitzung.
Was der Richter dir tatsächlich bringt
Es gibt ein ernstzunehmendes Argument, dass Selbsteinschätzung Theater ist. Ein Modell, das seine eigene Ausgabe bewertet, korrigiert seine eigenen Hausaufgaben, und die Rubric, die es erfindet, wird das schmeicheln, was es gerade gemacht hat. Der Grund, warum diese Umsetzung interessanter ist als die Kritik, ist, dass die Rubric deine sein kann und nicht seine.
Wenn du ihm einen Bewertungs-Prompt gibst, verwandelst du ein Geschmacksproblem in ein Checklistenproblem. Das ist derselbe Zug, den gute Art Direction macht: Eine Creative Director sagt nicht „lass es knallen“, sondern „das Produkt muss in Thumbnail-Größe lesbar sein“. Sobald das Kriterium explizit ist, kann ein Modell darauf optimieren. Und anders als ein menschlicher Retuscheur kann es das über Nacht hundertmal tun, ohne gelangweilt zu werden.
Der Preis dafür ist Latenz. Die P50-End-to-End-Zeit auf OpenRouter liegt bei etwa 104 Sekunden, mit einer P90 um 171 und einer P99 über 327. Wenn du ein einzelnes Hero-Bild generierst, ist das in Ordnung. Wenn du 200 Varianten für einen Test generierst, sind das anderthalb Stunden reine Wartezeit, und du willst das in einer Warteschlange laufen lassen, die auf deine Gefühle keine Rücksicht nimmt.
Die Verfügbarkeit ist die andere Zahl, die man im Auge behalten sollte: 88,55 Prozent über drei Tage, bei einer Uptime von 100 Prozent. Übersetzt: Der Endpunkt ist erreichbar, aber ungefähr jede neunte Anfrage lieferte keine Inferenz zurück. Bei einem Modell, das ein Fünftel Dollar pro Versuch kostet, ist das ärgerlich. Bei einem Modell, um das man eine Pipeline gebaut hat, ist es eine Retry-Policy, die man vor dem Start schreiben muss.
Wie es im Vergleich abschneidet
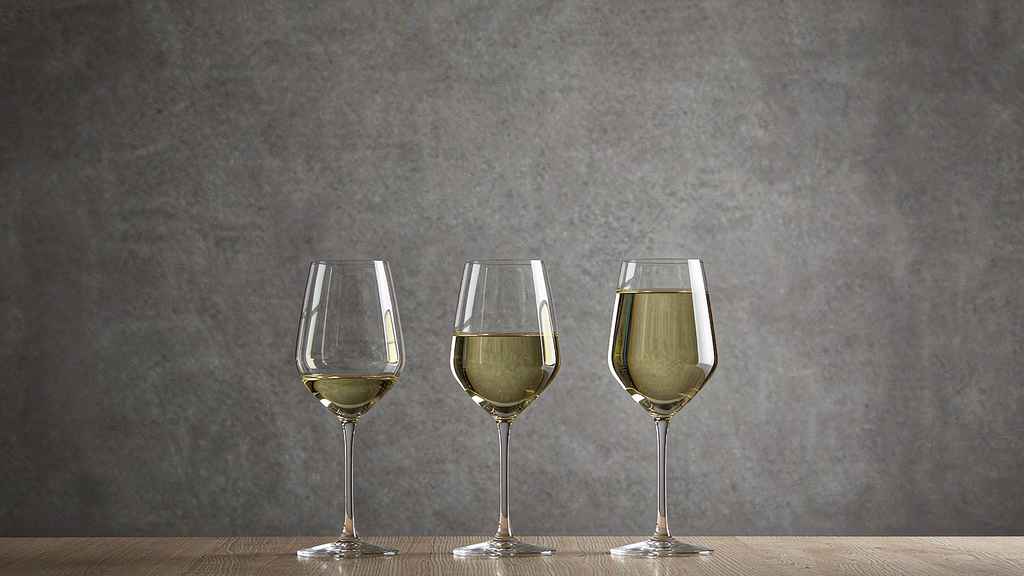
Im gemeinsamen Bild-Benchmark von OpenRouter — dem Prompt vom bis zum Rand gefüllten Weinglas, der Modelle entlarven soll, die das Glas zu einem Drittel voll zeichnen, weil ihre Trainingsdaten das so zeigen — besteht Riverflow V2.6 Pro 3 von 4 Prüfungen bei 0,157 Dollar. Nano Banana 2 und 2.1 bestehen 4 von 4 bei 0,06 und 0,035 Dollar. GPT-5.4 Image 2 besteht 4 von 4 bei 0,006 Dollar.
Liest man das ehrlich, tut es ein bisschen weh. In einem generischen Prompt-Following-Test ist Riverflow sowohl teurer als auch ungenauer als Modelle, die ein Zehntel kosten. Dieser Vergleich ist allerdings auch unfair, weil der Weinglas-Test genau eine Sache misst: ob das Modell einer ungewöhnlichen Anweisung folgt. Er sagt nichts darüber, ob die Schlagzeile in der richtigen Schriftart steht, ob die Transparenz sauber ist oder ob das 16:1-Banner tatsächlich komponiert.
Was genau das Argument für ein Modell wie dieses ist. Wenn deine Aufgabe lautet, ein Bild von einem Glas zu machen, solltest du das Modell für sechs Zehntel Cent nehmen und aufhören zu lesen. Wenn deine Aufgabe lautet, vierzig markenkonforme Assets zu produzieren, die das Legal-Review überstehen, dann sind die Kosten eines schlechten Bildes nicht die sechs Cent, die du dafür bezahlt hast. Es sind die zwanzig Minuten Design-Zeit, um es zu korrigieren, mal vierzig.
Solltest du es benutzen
Für einmalige kreative Erkundung: nein. Die Latenz und der variable Preis werden dich ärgern, und günstigere Modelle machen öfter schönere Bilder, als du erwartest.
Wenn du eine Asset-Pipeline für eine Marke baust — Verpackung, Retail, Social, irgendetwas mit einer Schriftarten- und einer Hintergrundanforderung —, ist ein Nachmittag Testen es wert. Setze eine Bewertungs-Rubric, die deine tatsächliche Review-Checkliste abbildet, lass sie mit mittlerem Reasoning laufen und schau, ob der Richter die Dinge fängt, die dein Art Director fängt. Das ist ein viel besserer Test als jedes Leaderboard.
Der allgemeinere Punkt: Bildmodelle spalten sich in zwei Kategorien — solche, die generieren, und solche, die produzieren. Riverflow ist klar in der zweiten, und es ist so bepreist, als wüsste es, dass der Unterschied in Retusche-Stunden gemessen wird, nicht in Cent.
Verwandte Artikel
Meta testet seine seltsamsten KI-Apps zuerst in Südostasien
Eine KI-Anprobe in Indonesien, Singapur und Thailand. Ein Haustier-Tagebuch auf den Philippinen. Nichts davon wurde angekündigt, und genau das ist der Punkt.
Ollie hatte SOC 2 und 7,5 Millionen Dollar. Trotzdem konnte es Muse nicht überholen.
Ein datenschutzorientierter Familienassistent mit einer von Khosla angeführten Seed-Runde und einem echten SOC-2-Audit schließt am 6. November. Die Lehre handelt nicht von Datenschutz. Sie handelt von Distribution.
Runware will Rechenzentren bauen wie Detroit Autos gebaut hat
Dreißig Megawatt pro Tag bis 2028, Pods online innerhalb von 48 Stunden, ein Gigawatt pro Monat. Der Engpass der KI-Kapazität sind nicht mehr die Chips, sondern die zwei Jahre, die ein Gebäude braucht.
Genspark hat ein Filmteam in ein Menü verwandelt
Drei Sprachmodelle führen Regie, siebzig Modellversionen führen aus, und deine Aufgabe wird zu fünfunddreißig Genehmigungen hintereinander. Ein Praxiseindruck davon, wie sich orchestrierte Videoproduktion tatsächlich anfühlt.