
Riverflow 2.6 Pro contrata a un juez antes de mostrarte la imagen
Sourceful lanzó Riverflow 2.6 Pro el 29 de octubre, y lo primero que hay que decir es que no se vende realmente como un modelo de imagen. Se vende como un flujo de trabajo con opinión. La descripción de su página de modelo se lee como una oferta de empleo: un modelo de razonamiento integrado planifica ediciones de varios pasos, evalúa candidatos y solo entonces acepta un resultado. El esfuerzo de razonamiento es un dial de cuatro posiciones. Los ajustes más altos significan más pasadas de edición y un juez interno más estricto.
Es algo extraño para poner delante de un generador de imágenes, y es lo más interesante que tiene. La mayoría de los modelos te piden que describas lo que quieres y luego tiran los dados. Este pregunta qué quieres, propone un camino, lo recorre y pone nota a su propio trabajo antes de devolverte nada.
Las especificaciones, en breve
Riverflow 2.6 Pro es el buque insignia de una familia 2.6 que cubre texto a imagen e imagen a imagen en un solo pipeline. Acepta hasta 10 imágenes de entrada para editar. Admite un contexto de 33K. El dimensionado de salida es la función estrella: en lugar de elegir un preajuste, puedes pasar un WIDTHxHEIGHT literal, de hasta 16.384 píxeles por lado, 16,8 megapíxeles en total y una relación de aspecto tan extrema como 16:1. Los preajustes de 1K/2K/4K siguen existiendo y ahora incluyen 5:4 y 4:5.
El precio parte de 0,13 dólares por imagen, y esa palabra, «parte», hace mucho trabajo. El coste se cierra por trabajo al terminar, según el procesamiento facturable. El esfuerzo de razonamiento, el tamaño de salida y la complejidad de la edición mueven la cifra. Un trabajo de 1280×720 en el playground marca 0,1501 dólares y 91 segundos. Si estás acostumbrado a pensar en céntimos por imagen, este modelo te pide pensar en céntimos por trabajo, y el trabajo tiene una duración variable.
Las tres funciones que revelan para quién es
La mayor parte de la ficha técnica es lo mínimo esperable. Las partes interesantes son las que solo importan si produces imagen comercial en volumen.
Fuentes personalizadas. Puedes pasar hasta dos referencias de fuente en font_inputs, y el modelo intentará igualar las letras, el espaciado y el peso. Cualquiera que haya sacado una campaña conoce el modo de fallo que esto ataca: la imagen es preciosa, el titular está en una tipografía que casi es la de tu marca y todo el conjunto es inservible. Igualar la tipografía no es un problema creativo, es un problema de cumplimiento, y tratarla como una entrada de primera clase es la decisión correcta.
Puntuación personalizada. Puedes aportar un scoring_prompt y una scoring_rubric, y el modelo de razonamiento evaluará los candidatos con tus criterios en lugar de con los suyos. Es la función que espero que copien primero. Significa que al juez se le puede decir «el logo debe ocupar al menos el 12% del ancho del encuadre y no puede quedar tapado», y que de verdad lo compruebe. La distancia entre «genera algo bonito» y «genera algo que pase la revisión de marca» es donde mueren la mayoría de los presupuestos de producción.
Control del fondo. Original, transparente o un color plano con un valor hexadecimal. Poco glamuroso, y la diferencia entre un recurso utilizable y una sesión de Photoshop.
Qué te compra realmente el juez
Hay un argumento serio de que autoevaluarse es teatro. Un modelo que juzga su propia salida se está corrigiendo su propia tarea, y la rúbrica que invente halagará lo que acaba de hacer. La razón por la que esta implementación es más interesante que esa crítica es que la rúbrica puede ser tuya, no suya.
Cuando le das un prompt de puntuación, conviertes un problema de gusto en un problema de lista de comprobación. Es el mismo movimiento que hace la buena dirección de arte: un director creativo no dice «hazlo que destaque», dice «el producto tiene que leerse en tamaño miniatura». Una vez que el criterio es explícito, un modelo puede optimizar contra él. Y a diferencia de un retocador humano, puede hacerlo cien veces de noche sin aburrirse.
El coste es la latencia. El tiempo de extremo a extremo P50 en OpenRouter es de unos 104 segundos, con un P90 alrededor de 171 y un P99 por encima de 327. Si generas una sola imagen principal, está bien. Si generas 200 variantes para una prueba, son hora y media de reloj, y querrás meterlo en una cola que no se apiade de ti.
La disponibilidad es la otra cifra que conviene vigilar: 88,55% en tres días, con un tiempo de actividad del 100%. Traducción: el endpoint responde, pero aproximadamente una de cada nueve peticiones no devolvió inferencia. En un modelo que cuesta un quinto de dólar por intento, eso es molesto. En un modelo alrededor del cual has construido un pipeline, es una política de reintentos que tienes que escribir antes de lanzar.
Cómo se compara
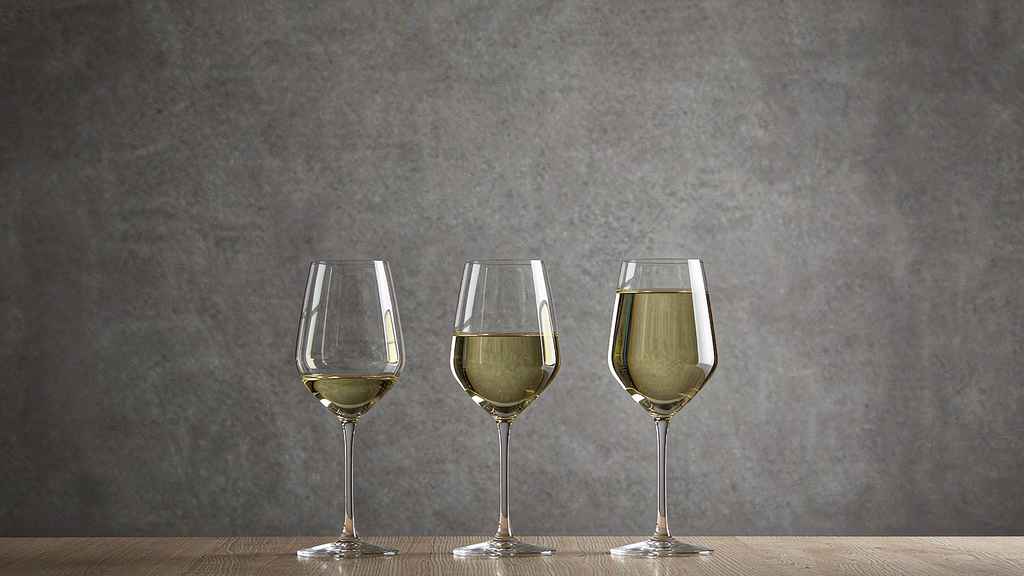
En el benchmark de imagen compartido de OpenRouter —el prompt de la «copa de vino llena hasta el borde», pensado para pillar a los modelos que dibujan la copa a un tercio porque eso es lo que muestran sus datos de entrenamiento—, Riverflow V2.6 Pro pasa 3 de 4 comprobaciones a 0,157 dólares. Nano Banana 2 y 2.1 pasan 4 de 4 a 0,06 y 0,035 dólares. GPT-5.4 Image 2 pasa 4 de 4 a 0,006 dólares.
Léelo con honestidad y duele un poco. En una prueba genérica de seguimiento de instrucciones, Riverflow es a la vez más caro y menos preciso que modelos que cuestan una décima parte. La comparación también es injusta, porque la prueba de la copa mide una sola cosa: si el modelo obedece una instrucción poco habitual. No dice nada sobre si el titular está en la tipografía correcta, si la transparencia está limpia o si el banner de 16:1 compone de verdad.
Y ese es todo el argumento a favor de un modelo así. Si tu trabajo es «haz una foto de una copa», deberías usar el modelo de seis décimas de céntimo y dejar de leer. Si tu trabajo es «produce cuarenta recursos de marca que sobrevivan a la revisión legal», el coste de una imagen mala no son los seis céntimos que pagaste por ella. Son los veinte minutos del tiempo de un diseñador para arreglarla, multiplicados por cuarenta.
¿Deberías usarlo?
Si haces exploración creativa puntual, no. La latencia y el precio variable te van a irritar, y los modelos más baratos harán imágenes más bonitas más a menudo de lo que esperas.
Si estás montando un pipeline de recursos para una marca —packaging, retail, redes, cualquier cosa con un requisito de tipografía y uno de fondo—, merece una tarde de pruebas. Arma una rúbrica de puntuación que codifique tu lista de revisión real, ejecútala con razonamiento medio y mira si el juez detecta las mismas cosas que tu director de arte. Es una prueba mucho mejor que cualquier ranking.
La idea de fondo es que los modelos de imagen se están partiendo en dos categorías: los que generan y los que producen. Riverflow está claramente en la segunda, y tiene un precio como si supiera que la diferencia se mide en horas de retoque y no en céntimos.
Artículos relacionados
Meta prueba sus apps de IA más extrañas primero en el sudeste asiático
Un probador virtual con IA en Indonesia, Singapur y Tailandia. Un diario con mascota en Filipinas. Ninguno se anunció, y esa es la cuestión.
Ollie tenía SOC 2 y 7,5 millones de dólares. Aun así no pudo superar a Muse.
Un asistente familiar centrado en la privacidad, con una ronda semilla liderada por Khosla y una auditoría SOC 2 real, cierra el 6 de noviembre. La lección no va de privacidad. Va de distribución.
Runware quiere construir centros de datos como Detroit construía coches
Treinta megavatios al día para 2028, módulos operativos en 48 horas, un gigavatio al mes. El límite de la capacidad de IA dejó de ser los chips y pasó a ser los dos años que cuesta levantar un edificio.
Genspark convirtió un equipo de rodaje en un menú
Tres modelos de lenguaje dirigen, setenta versiones de modelos ejecutan y tu trabajo se convierte en treinta y cinco aprobaciones seguidas. Una prueba práctica de cómo se siente realmente la producción de vídeo orquestada.