
O Riverflow 2.6 Pro contrata um juiz antes de te mostrar a imagem
A Sourceful lançou o Riverflow 2.6 Pro em 29 de outubro, e a primeira coisa a dizer sobre ele é que não é bem vendido como modelo de imagem. É vendido como um fluxo de trabalho com opinião. A descrição na página do modelo parece um anúncio de vaga: um modelo de raciocínio integrado planeja edições em várias etapas, julga candidatos e só então aceita um resultado. O esforço de raciocínio é um botão com quatro posições. Configurações mais altas significam mais passadas de edição e um juiz interno mais rigoroso.
É uma coisa estranha de colocar na frente de um gerador de imagens, e é o mais interessante nele. A maioria dos modelos pede que você descreva o que quer e então joga os dados. Este pergunta o que você quer, propõe um caminho, percorre o caminho e dá nota ao próprio trabalho antes de devolver qualquer coisa.
As especificações, em resumo
O Riverflow 2.6 Pro é o carro-chefe de uma família 2.6 que dá conta de texto-para-imagem e imagem-para-imagem num único pipeline. Aceita até 10 imagens de entrada para edição. Aceita um contexto de 33K. O dimensionamento da saída é o recurso de destaque: em vez de escolher um preset, você pode passar um LARGURAxALTURA literal, com até 16.384 pixels em um dos lados, 16,8 megapixels no total e uma proporção tão extrema quanto 16:1. Os presets 1K/2K/4K continuam existindo e agora incluem 5:4 e 4:5.
O preço começa em US$ 0,13 por imagem, e esse «começa» faz muito trabalho. O custo é fechado por tarefa na conclusão, com base no processamento faturável. Esforço de raciocínio, tamanho da saída e complexidade da edição mexem no número. Uma tarefa de 1280×720 no playground aparece como US$ 0,1501 e 91 segundos. Se você está acostumado a pensar em centavos por imagem, este modelo pede que você pense em centavos por tarefa, onde a tarefa tem duração variável.
Os três recursos que revelam para quem ele é
A maior parte da ficha técnica é o básico esperado. As partes interessantes são as que só importam se você produz imagens comerciais em volume.
Fontes personalizadas. Você pode passar até duas referências de fonte por font_inputs, e o modelo tenta acompanhar o desenho das letras, o espaçamento e o peso. Quem já entregou uma campanha conhece o modo de falha que isso resolve: a imagem está linda, a manchete está numa fonte que é quase a fonte da sua marca, e o conjunto todo é inutilizável. Acertar a tipografia não é um problema criativo, é um problema de conformidade, e tratar isso como entrada de primeira classe é a decisão certa.
Avaliação personalizada. Você pode fornecer um scoring_prompt e uma scoring_rubric, e o modelo de raciocínio avalia os candidatos pelos seus critérios, não pelos dele. É o recurso que eu esperaria ver copiado primeiro. Significa que dá para dizer ao juiz «o logo precisa ocupar pelo menos 12% da largura do quadro e não pode estar obstruído», e ele de fato verifica. A distância entre «gere algo bonito» e «gere algo que passe na revisão de marca» é onde morre a maior parte dos orçamentos de produção.
Controle de fundo. Original, transparente ou uma cor sólida com valor hexadecimal. Sem glamour, e é a diferença entre um arquivo utilizável e uma sessão no Photoshop.
O que o juiz realmente entrega
Existe um argumento sério de que autoavaliação é teatro. Um modelo que julga a própria saída está corrigindo a própria prova, e a rubrica que ele inventa vai elogiar o que acabou de fazer. O motivo de esta implementação ser mais interessante do que essa crítica é que a rubrica pode ser sua, não dele.
Quando você entrega um prompt de avaliação, está convertendo um problema de gosto num problema de checklist. É o mesmo movimento que a boa direção de arte faz: um diretor de criação não diz «deixe mais chamativo», diz «o produto precisa ser legível no tamanho de miniatura». Uma vez que o critério é explícito, um modelo consegue otimizar por ele. E, diferente de um retocador humano, consegue fazer isso cem vezes durante a noite sem se entediar.
O custo é a latência. O tempo ponta a ponta P50 no OpenRouter fica em torno de 104 segundos, com P90 perto de 171 e P99 acima de 327. Se você está gerando uma única imagem principal, tudo bem. Se está gerando 200 variantes para um teste, são uma hora e meia de relógio, e você vai querer rodar isso numa fila que não se importa com os seus sentimentos.
A disponibilidade é o outro número a acompanhar: 88,55% em três dias, com uptime de 100%. Tradução: o endpoint responde, mas mais ou menos uma requisição em cada nove não devolveu inferência. Num modelo que custa um quinto de dólar por tentativa, isso incomoda. Num modelo em torno do qual você construiu um pipeline, é uma política de retry que você precisa escrever antes do lançamento.
Como ele se compara
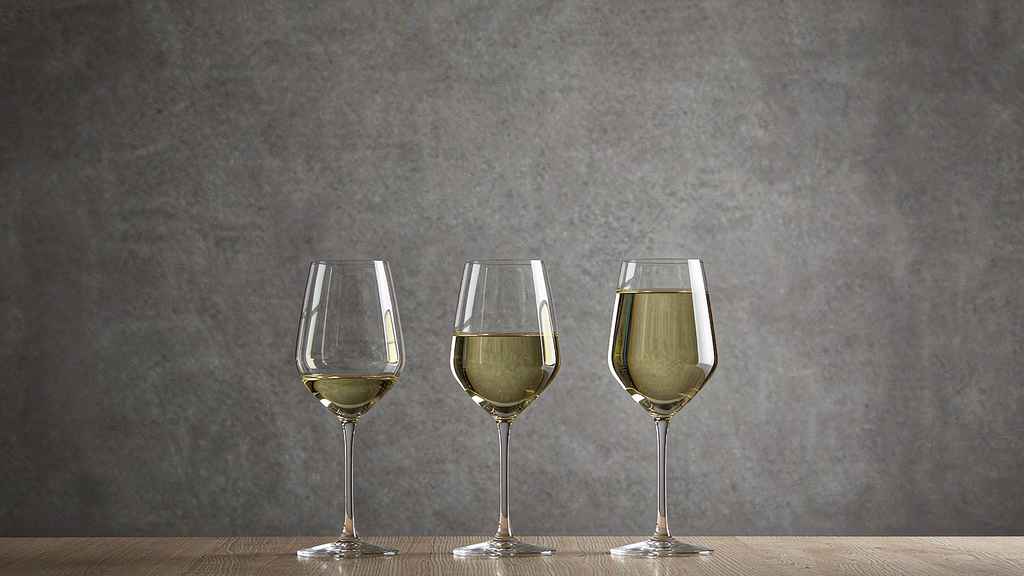
No benchmark de imagem compartilhado do OpenRouter — o prompt da «taça de vinho cheia até a borda», feito para pegar modelos que desenham a taça com um terço do conteúdo porque foi isso que os dados de treino mostraram —, o Riverflow V2.6 Pro passa em 3 de 4 checagens por US$ 0,157. O Nano Banana 2 e o 2.1 passam em 4 de 4 por US$ 0,06 e US$ 0,035. O GPT-5.4 Image 2 passa em 4 de 4 por US$ 0,006.
Ler isso com honestidade dói um pouco. Num teste genérico de seguir instruções, o Riverflow é ao mesmo tempo mais caro e menos preciso do que modelos que custam um décimo. Essa comparação também é injusta, porque o teste da taça mede uma coisa só: se o modelo obedece a uma instrução incomum. Não diz nada sobre a manchete estar na tipografia certa, sobre a transparência estar limpa ou sobre o banner 16:1 realmente compor.
O que é justamente o argumento a favor de um modelo assim. Se o seu trabalho é «faça uma imagem de uma taça», use o modelo de seis décimos de centavo e pare de ler. Se o seu trabalho é «produza quarenta peças dentro da marca que sobrevivam à revisão jurídica», o custo de uma imagem ruim não são os seis centavos que você pagou por ela. São os vinte minutos do designer para consertar, vezes quarenta.
Vale usar
Se você faz exploração criativa pontual, não. A latência e o preço variável vão te irritar, e modelos mais baratos vão fazer imagens mais bonitas com mais frequência do que você espera.
Se você está montando um pipeline de peças para uma marca — embalagem, varejo, social, qualquer coisa com exigência de tipografia e de fundo —, vale uma tarde de testes. Monte uma rubrica de avaliação que reproduza o seu checklist real de revisão, rode com raciocínio médio e veja se o juiz pega o que o seu diretor de arte pega. É um teste muito melhor do que qualquer ranking.
O ponto mais amplo é que os modelos de imagem estão se dividindo em duas categorias: os que geram e os que produzem. O Riverflow está firmemente na segunda, e o preço dele sugere que sabe que a diferença se mede em horas de retoque, não em centavos.
Artigos relacionados
A Meta está testando seus apps de IA mais estranhos primeiro no Sudeste Asiático
Um provador de IA na Indonésia, em Singapura e na Tailândia. Um diário de bicho de estimação nas Filipinas. Nenhum dos dois foi anunciado, e é justamente esse o ponto.
O Ollie tinha SOC 2 e US$ 7,5 milhões. Ainda assim, não conseguiu superar o Muse.
Um assistente familiar com privacidade em primeiro lugar, rodada seed liderada pela Khosla e auditoria SOC 2 de verdade, fecha em 6 de novembro. A lição não é sobre privacidade. É sobre distribuição.
A Runware quer construir data centers do jeito que Detroit construía carros
Trinta megawatts por dia até 2028, pods no ar em 48 horas, um gigawatt por mês. A restrição da capacidade de IA deixou de ser chip e passou a ser os dois anos que leva para construir um prédio.
O Genspark transformou uma equipe de cinema em um menu
Três modelos de linguagem dirigem, setenta versões de modelo executam, e o seu trabalho vira trinta e cinco aprovações seguidas. Um olhar prático sobre como é, de fato, a produção de vídeo orquestrada.