
Runware 想用底特律造車的方式蓋資料中心
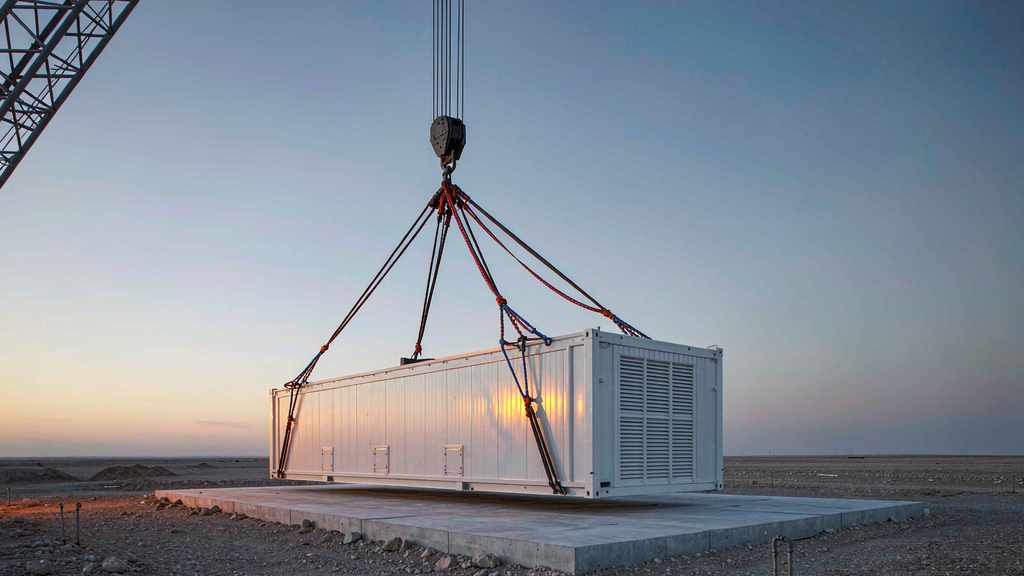
這個說法聽起來像玩笑,直到你看到那些數字:用生產線蓋資料中心,像底特律造車那樣,而且送到現場後 48 小時就能運轉。
Runware 是認真的。這家公司已經在賣 Sonic Inference Pod——一個在工廠裡做好、送到就能安裝的模組化資料中心,今年初亮相。現在它說,它要的是一座用生產線組裝這些 pod 的工廠,而且喊出了目標:2028 年達到每天 30 兆瓦的容量。換算下來,接近每月 1 吉瓦。
放進脈絡裡看:全美國今年預期新增的資料中心電力大約是 10 吉瓦。Runware 主張的是,滿載生產時,一座工廠十二個月就能產出相當於全國一整年的建設量。
瓶頸到底在哪
這個說法之所以有說服力,不是因為「工廠」很新奇。Crusoe 在賣預製 pod,Schneider Electric 也賣。Nvidia 今年發表了自己的 Vera Rubin AI 工廠與 DSX POD 設計。整個產業大致上已經同意:在工地上一棟一棟蓋資料中心,太慢了。
Runware 主張的差別在於,它真的把工廠蓋出來了,而不只是畫了設計圖。它有兩座:一座已經用了幾年,另一座今年初動工,預計 2027 年初上線。創辦人暨執行長 Flaviu Radulescu 告訴 TechCrunch,目標是 pod 到場後 48 小時內就能運轉——而這 48 小時包含安裝與設定,不含製造。
根據公司的說法,一個原本要花三週製造的 pod,很快會縮短到一天。
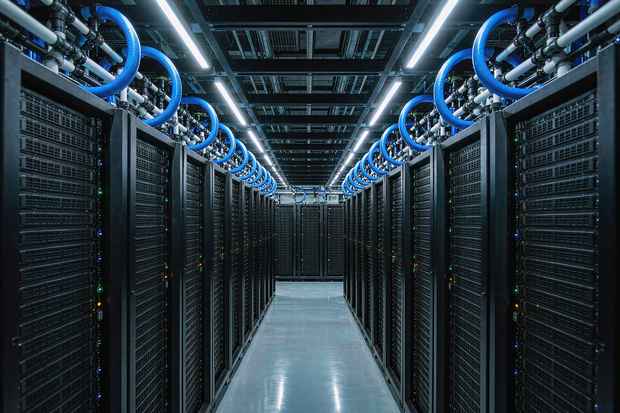
讓它可信的那一塊
我一直回頭想的細節,是那個關於時間的論證。Radulescu 說 pod 的交期比 GPU 的前置時間還短,也就是說,基礎設施可以配合「實際到貨的硬體」來調整。這是對常見問題一次很聰明的反轉。正常情況下,你先對一棟建築做出承諾,然後等上十八個月,等晶片和配電設備都排到位。
第二個可信的細節是實體佔地。這些 pod 採封閉式液冷搭配氣冷散熱排,所以不需要接水——只要電和網路。根據公司說法,它們運轉時安靜無聲,可耐到華氏 86 度。它們可以部署在比超大規模業者小得多的場址,通常是已經有電的地方,這就繞過了很多讓大型專案卡關的電網併聯爭議。
如果這點成立,它會改變「誰有辦法蓋資料中心」。不只 Amazon 和 Microsoft,還包括區域型的機房業者、一所大學、一家需要在產線旁邊就有推論算力的製造商。
商業模式長什麼樣
兩種買法。你可以向 Runware 租算力,或是自帶 GPU、每月付費使用 pod 與維運。兩種情況下,電和網路都另外計費。
Runware 表示,自從一個月前開始向外部客戶提供 pod 以來,已收到 10 億美元的意向承諾,代表超過 20 兆瓦是它現在正努力交付的量。場址儲備有 397 兆瓦,潛在可擴充到 1.2 吉瓦。
它至今募到超過 6,000 萬美元,包括 2025 年 12 月由 Dawn Capital 與 Comcast Ventures 領投的 5,000 萬美元 A 輪。B 輪正在規劃,但工廠是用 A 輪的錢在完成。
最明顯的對照,以及為什麼它公平
TechCrunch 拿 Arrival 來比,這個對照挑得好。Arrival 是那家一度估值超過 130 億美元的電動車新創,它試圖用微型工廠重新發明汽車製造,最後發現大量生產是一門紀律,不是一個點子。它破產了。
這個類比不只是修辭。兩家公司都主張用更便宜的人力與標準化零件,在小工廠裡製造複雜硬體,也都主張現有玩家的成本結構過於臃腫。Radulescu 的論點是,差別在於 Runware 的產品每單位人力所創造的價值高得多。一個能解鎖數十兆瓦推論營收的 pod,撐得起一輛 3 萬美元廂型車撐不起的工廠薪資。
他還從汽車業挖來了一位廠長——這要看你對汽車業老將的感覺,可能是整個故事裡最讓人安心的細節,也可能是最不祥的。
到底是誰在買
48 小時這個承諾有意思的地方,在於它解鎖了誰。超大規模業者以年為單位規劃、以大批量採購。區域型供應商、研究實驗室,或是一家想在自己工廠旁邊放推論算力的公司,則是以月為單位規劃、以台為單位採購。這些客戶過去基本上被擋在市場外,不是因為買不起算力,而是因為排不進那個時程。
還有一個很少寫進新聞稿的成本面向。傳統資料中心施工有一條很長的尾巴:許可、併聯研究、與電力公司的談判,這些在還顆 GPU 都還沒開始賺錢之前,就不斷在資本上累積利息。如果你能把 pod 放到一個已經有電的場址,那條尾巴大半就省了。pod 佔地較小也意味著社區阻力較低,而這對大型專案來說,已經變成實質的時程風險。
可能出什麼錯
供應。Runware 自行設計冷卻與 pod 系統,但部分零件——泵、風扇——來自德國,網路設備仍得靠 Nvidia。一座工廠的可靠度,取決於它的供應鏈,而單一來源的泵就是單點故障。
需求的時間點。10 億美元的「意向承諾」不是 10 億美元的訂單。意向與簽約之間的落差,正是基礎設施新創葬身之地,尤其當客戶自己也在盤算十八個月後到底需不需要那個容量。
還有那個根本假設:AI 需求會持續成長到足以吸收每月 1 吉瓦。近來質疑這波支出熱潮開始出現裂縫的聲音越來越多。如果真裂了,工廠就是庫存最不該堆放的地方。
為什麼它仍然重要
即使 Runware 失敗,它正在驗證的命題大概還是對的。AI 部署的瓶頸已經從晶片移到電力,再移到時間——具體來說,是讓一座傳統資料中心上線所需要的二到四年。任何能壓縮這段時程的東西都值真金白銀,因為一顆等建築的 GPU,就是一顆不賺錢的 GPU。
模組化 pod 是顯而易見的答案,產業也知道。還沒確定的是:一家只有 6,000 萬美元和一張計畫藍圖的公司,能不能把製造做到汽車業的規模。這是個值得盯的賭注,而 2028 年的產能目標,就是拿來檢驗它的那個數字。
相關文章
Meta 最怪的幾個 AI App,先丟到東南亞試水溫
印尼、新加坡、泰國的 AI 試衣間,菲律賓的寵物日記本。兩個都沒發布,而這正是重點。
Ollie 有 SOC 2、有 750 萬美元,還是打不贏 Muse
一款隱私優先的家庭助理,有 Khosla 領投的種子輪,有貨真價實的 SOC 2 稽核,11 月 6 日還是要關。教訓不在隱私,而在通路。
Genspark 把一整組拍片團隊,收成了一張選單
三個語言模型當導演,七十個模型版本負責執行,而你的工作變成連續三十五次的核准。實際用起來,編排式影片製作到底是什麼感覺。
十二小時、五千台機器:一個不屬於 Anthropic 的 Claude Code 擴充套件
一份被植入後門的 Claude Code 擴充套件,在 Cursor 商店上架近十二小時,並帶著持續性的 SSH 後門。Cursor 表示最多有 5,000 名開發者安裝過。