
Die nächste KI-Grenze: Ein einzelnes Standbild in eine bewegte Szene verwandeln
Die Bildgenerierung ist inzwischen gut genug, dass sich die Diskussion weiterbewegt. Die neue Grenze, die die Tools und Forscher in dieser Saison verfolgen, ist Video. Genauer gesagt: ein einzelnes Standbild zu nehmen und es in Bewegung zu versetzen.
Das klingt nach einem kleinen Schritt, ist aber ein anderes technisches Problem. Ein Diffusions-Bildmodell verfeinert Rauschen zu einem einzigen kohärenten Einzelbild. Video bedeutet hunderte Frames, die untereinander, mit der Physik des Motivs und mit dem Originalbild konsistent bleiben müssen. Macht man es falsch, zerfließt das Gesicht der Figur nach drei Sekunden.
Hierhin fließt die Energie im Jahr 2026, und es lohnt sich zu verstehen, was jetzt tatsächlich möglich ist, denn die Kluft zwischen der Demo und dem brauchbaren Tool ist immer noch das eigentliche Spiel.
Das Physikproblem – und warum es so schwierig war
Am deutlichsten erkennt man, warum das schwierig ist, wenn man sich ansieht, was ein gutes Bild-zu-Video-Tool tut, wenn es funktioniert.
Nehmen wir eine Figur. Ein Standbild einer Person ist eine eingefrorene Pose. Um diese Person tanzen, gehen oder winken zu lassen, muss das Modell Körpergeometrie verstehen, nicht nur Pixel. Wenn es nur visuelle Muster kopiert, driften die Gliedmaßen, die Proportionen verzerren sich, und man erhält die verschmolzene, puppenhafte Bewegung, die die frühen Tools geprägt hat.
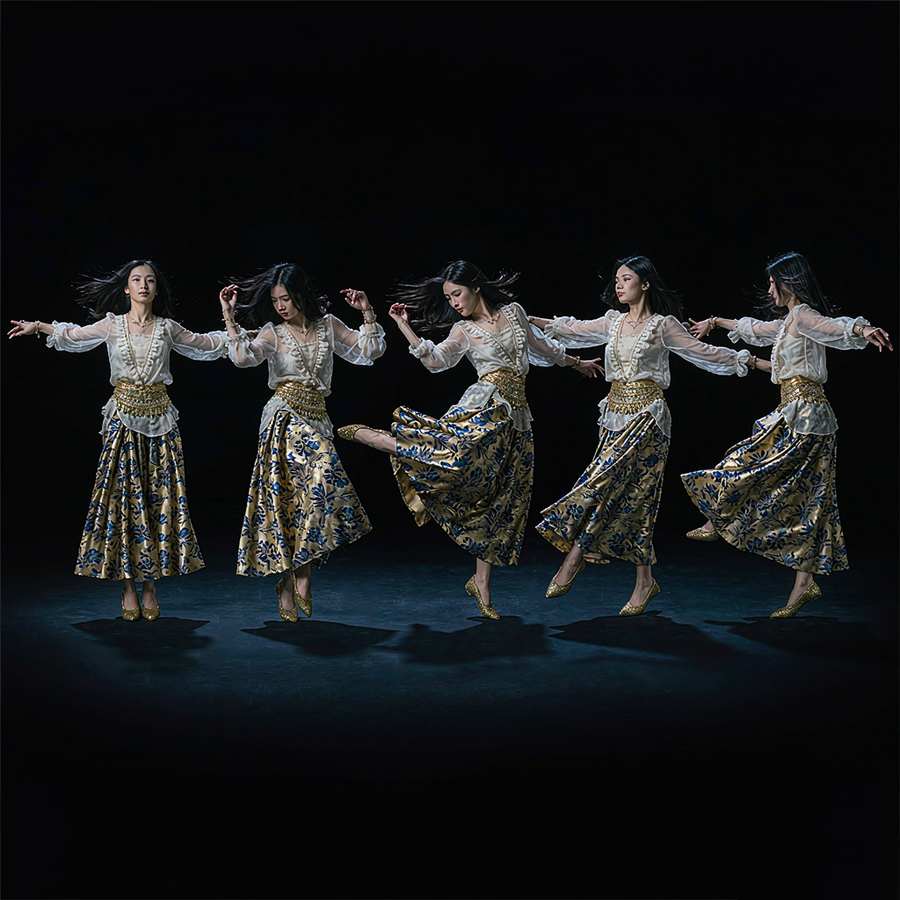
Viggle, das Tool, das genau dafür bekannt wurde, hat seinen Ruf mit einem anderen Ansatz aufgebaut. Sein JST-1-Modell ist ein 3D-Physikmodell statt eines reinen Diffusionsmodells. Es arbeitet mit einem Verständnis der Körpergeometrie, weshalb die Proportionen der Figur bei schneller, komplexer Choreografie stabil bleiben, wo Frame-für-Frame-Generatoren oft auseinanderfallen. Das Modell treibt die Charakteranimation aus einem einzigen Standbild an und ist zum Standard für Meme-Macher und Kurzvideo-Kreative geworden, die eine Figur tanzen lassen wollen.
Die Open-Source-Seite wacht auf
Die Open-Source-Welt war hier langsamer, weil das Training von Videogenerierung teuer ist. Aber sie bewegt sich.
Viggle hat im September Viggle-Animate auf Hugging Face veröffentlicht, ein Bild-zu-Video-Modell, das auf Charakterersetzung und Videobearbeitung abzielt und aus MiniMax-H3 destilliert wurde. Destillation ist der Trick, ein kleineres Modell zu trainieren, das das Verhalten eines größeren Elternmodells reproduziert – was wichtig ist, wenn es um schnellere Inferenz und niedrigere Rechenkosten geht. Die Veröffentlichung ist in ihrem Umfang eng gefasst – Figuren austauschen und vorhandenes Material bearbeiten statt Clips von Grund auf zu generieren –, aber sie legt ein zweckgebundenes Tool ohne geschlossene API in die Hände von Entwicklern.
Dieses Muster sollte man im Auge behalten. Jedes schwierige Problem in der KI wird irgendwann geöffnet, und die charaktergesteuerte Videobearbeitung war eines der schwierigeren, das sich nicht geschlossen halten ließ. Die offene Veröffentlichung ist noch rau und die Lizenz nicht standardisiert, aber sie ist ein Signal, dass der Open-Source-Stack gegenüber den geschlossenen Tools aufholt.
Die kommerzielle Landschaft
Auf der kommerziellen Seite hat sich das Feld in Nischen sortiert.
Viggle dominiert die Charakteranimation aus Standbildern. Es ist kein Allzweck-Videotool und beherrscht keine Landschaften oder Produkte, aber wenn es darum geht, eine Figur aus einem einzigen Bild tanzen oder posieren zu lassen, hat es keinen echten Rivalen. Die kostenlose Stufe bietet fünf mit Wasserzeichen versehene Videos pro Tag, die Bezahlpläne fügen Auflösung hinzu und entfernen das Wasserzeichen.
PixVerse führt beim Budget. Es verwandelt ein einzelnes Standbild in einen kurzen stilisierten Clip, mit Start- und Endframe-Steuerung, sodass man die Bewegung zwischen zwei Keyframes lenken kann, und es hat einen umfangreichen Katalog an viralen Ein-Tipp-Effekten. Der Kompromiss sind kurze Clips und eine schwächere narrative Konsistenz.
Runway und Kling sitzen am Produktionsende für alle, die Kontrolle über mehrere Szenen und Kameraarbeit brauchen. Und die Modellhersteller selbst – OpenAI, Google und xAI – treiben ihre Videomodelle weiter voran, wobei die Funktion „Einzelbild zu Video“ zunehmend in die Haupt-Apps integriert wird, statt als eigenständiges Produkt verkauft zu werden.
So nutzt du diese Tools, ohne Zeit zu verschwenden
Die Leute, die gerade echten Nutzen aus Bild-zu-Video ziehen, haben ein paar Gewohnheiten gemeinsam – und es lohnt sich, sie zu übernehmen.
Beginne mit einem guten Standbild. Die Animation kann ein schlechtes Ausgangsbild nicht reparieren. Wenn die Figur unscharf, nicht zentriert oder ungeschickt posiert ist, wird das Video in Bewegung unscharf, nicht zentriert und ungeschickt posiert sein. Generiere oder wähle zuerst ein sauberes, gut beleuchtetes Standbild, dann hat die Animation etwas, womit sie arbeiten kann.
Plane um das Clip-Limit herum. Die meisten dieser Tools enden bei etwa zehn bis fünfzehn Sekunden, und die besten Ergebnisse bleiben deutlich darunter. Plane eher einen Loop, einen Hook oder einen einzelnen Beat als eine ganze Szene. Der Versuch, ein Tool über seine Möglichkeiten hinaus zu dehnen, führt genau zu den zerfließenden Frames, die jeder schon gesehen hat.
Nutze Keyframes, wenn das Tool sie anbietet. PixVerse und andere lassen dich einen Start- und einen Endframe setzen, was dem Modell zwei Ankerpunkte zum Interpolieren gibt. Diese eine Gewohnheit beseitigt den größten Teil des Drifts und lässt die Bewegung bewusst statt zufällig wirken.
Und sei ehrlich, was das Ergebnis angeht. Diese Tools sind am stärksten bei stilisierten, charaktergetriebenen oder Produkt-Spin-Inhalten. Sie sind noch kein Ersatz für echtes Footage, wenn Realismus und Vertrauen eine Rolle spielen. Für ein Meme, einen Social-Media-Post oder einen Produkt-Loop sind sie bereit. Für alles, was aussehen muss, als wäre es gefilmt worden, sind sie es nicht.
Die Kreativen, die mit Bild-zu-Video erfolgreich sind, behandeln es als eine neue Art von Kamera mit eigenen Grenzen – nicht als billigere Version der alten. Lerne die Grenzen und drehe innerhalb dieser Grenzen, und ein einzelnes Standbild wird zu einer erstaunlich großen Leinwand.
Was heute tatsächlich brauchbar ist
Die ehrliche Einschätzung ist, dass Bild-zu-Video den Schritt von der Demo zum nützlichen Werkzeug für kurze Clips geschafft hat, aber noch nicht den Schritt zur Produktionsreife für lange Formate.
Für einen Zehn-Sekunden-Loop einer tanzenden Figur, einen stilisierten Social-Media-Post oder einen Produkt-Spin für eine Anzeige sind die Tools gut genug, dass sich der Aufwand lohnt. Für alles, was narrative Kontinuität, konsistente Kameraführung oder eine ganze Minute kohärentes Material braucht, fallen die Tools immer noch auseinander.
Das ist keine Kritik. Es ist einfach der aktuelle Stand der Technik. Die Menschen, die heute Nutzen aus Bild-zu-Video ziehen, sind diejenigen, die das Clip-Längenlimit respektieren und darum herum planen, statt dagegen anzukämpfen.
Die Grenze ist jedoch real. Die Branche hat klargemacht, dass 3D-Generierung und Videoanimation aus einzelnen Bildern der nächste große Schritt sind, der voraussichtlich in den nächsten ein bis zwei Jahren ausreifen wird. Die Tatsache, dass Open-Source- und geschlossene Tools jetzt bei der Charakteranimation aus einem einzigen Standbild zusammenkommen, bedeutet, dass das schwierigste Stück – die Physik der Bewegung – endlich als lösbares Ingenieursproblem behandelt wird und nicht mehr als Forschungskuriosität.
Verwandte Artikel
Der Open-Source-KI-Bild-Stack wird neu aufgebaut – ein Workflow nach dem anderen
Workflow1111 bildet AUTOMATIC1111 mit 73 Knoten und 11 Pipelines nach. Was der Neuaufbau durch die Community für die lokale Bildgenerierung bedeutet.
Die Zahlen hinter der KI-Bildgenerierung: Ein Preissturz von 99 Prozent hat die Stockfotografie aufgefressen
Marktgröße, Stockfoto-Disruption, Adoptionszahlen und der hybride Workflow, erklärt anhand der Statistiken.
Flux 2 vs. Stable Diffusion 3.5: Der Open-Source-Bildwettlauf hat einen klaren Spitzenreiter
Flux 2 liegt bei der Qualität vorn, Stable Diffusion 3.5 hat das tiefste Ökosystem. So wählst du 2026 zwischen ihnen.
Wem gehört ein KI-generiertes Bild? Urheberrecht und das Firefly-Schlupfloch
Lizenzierung, Freistellung und Adobe Fireflys rechtliche Absicherung: was Sie 2026 sicher veröffentlichen können.