
La prossima frontiera dell'IA è trasformare una singola immagine fissa in una scena in movimento
La generazione di immagini è diventata abbastanza buona che la conversazione sta andando avanti. La nuova frontiera, quella che gli strumenti e i ricercatori stanno inseguendo in questa stagione, è il video. In particolare, prendere una singola immagine fissa e farla muovere.
Sembra un piccolo passo, ma è un problema tecnico diverso. Un modello di diffusione per immagini raffina il rumore in un singolo fotogramma coerente. Il video significa centinaia di fotogrammi che devono restare coerenti tra loro, con la fisica del soggetto e con l'immagine originale. Se sbagli, il volto del personaggio si scioglie dopo tre secondi.
È qui che si sta dirigendo l'energia nel 2026, e vale la pena capire cosa è davvero possibile ora, perché il divario tra la demo e lo strumento utilizzabile è ancora tutto il gioco.
Il problema della fisica, e perché era difficile
Il modo più chiaro per capire perché è difficile è osservare cosa fa un buon strumento da immagine a video quando funziona.
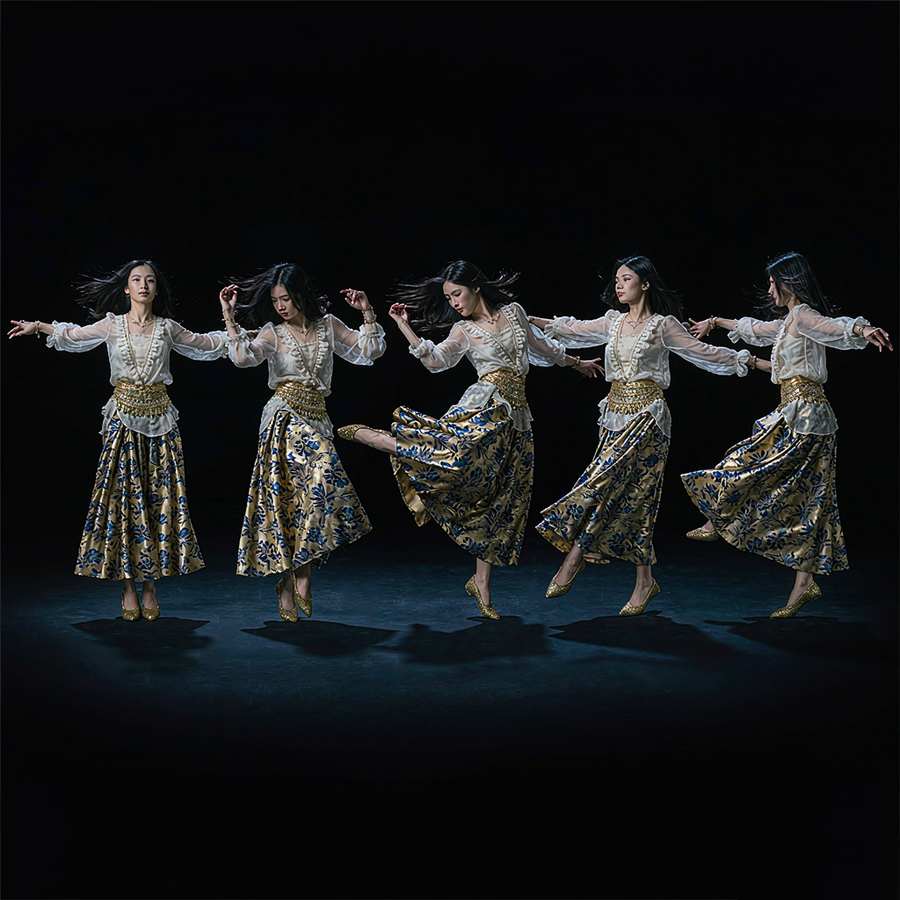
Prendi un personaggio. Un'immagine fissa di una persona è una posa congelata. Per animare quella persona che balla, cammina o saluta, il modello deve comprendere la geometria del corpo, non solo i pixel. Se copia soltanto i pattern visivi, gli arti slittano, le proporzioni si deformano e ottieni il movimento fuso, da marionetta, che caratterizzava i primi strumenti.
Viggle, lo strumento diventato famoso proprio per questo, ha costruito la sua reputazione su un approccio diverso. Il suo modello JST-1 è un modello fisico 3D piuttosto che un puro modello di diffusione. Lavora a partire dalla comprensione della geometria del corpo, ed è per questo che le proporzioni del personaggio reggono in coreografie veloci e complesse dove i generatori fotogramma per fotogramma tendono a cedere. Il modello alimenta l'animazione dei personaggi da una singola immagine fissa ed è diventato lo standard per i creatori di meme e di contenuti brevi che vogliono far ballare un personaggio.
Il lato open-source si sta svegliando
Il mondo open-source è stato più lento in questo ambito, perché addestrare la generazione video è costoso. Ma si sta muovendo.
Viggle ha rilasciato Viggle-Animate su Hugging Face a settembre, un modello da immagine a video pensato per la sostituzione dei personaggi e il montaggio video, distillato da MiniMax-H3. La distillazione è il trucco di addestrare un modello più piccolo per riprodurre il comportamento di un modello genitore più grande, e conta quando l'obiettivo è un'inferenza più veloce e costi di calcolo inferiori. Il rilascio ha un ambito limitato, sostituzione di personaggi e modifica di filmati esistenti piuttosto che generazione di clip da zero, ma mette uno strumento appositamente creato nelle mani degli sviluppatori senza un'API chiusa.
È un modello da tenere d'occhio. Ogni problema difficile nell'IA alla fine viene aperto, e il montaggio video basato sui personaggi era uno dei più difficili da mantenere chiuso. Il rilascio open è grezzo e la licenza non è standard, ma è un segnale che lo stack open-source sta raggiungendo gli strumenti chiusi.
Il panorama commerciale
Sul fronte commerciale, il settore si è suddiviso in nicchie.
Viggle domina l'animazione dei personaggi da immagini fisse. Non è uno strumento video generico e non gestisce paesaggi o prodotti, ma per far ballare o mettere in posa un personaggio da una singola immagine non ha veri rivali. Il piano gratuito offre cinque video con filigrana al giorno, mentre i piani a pagamento aggiungono risoluzione e rimuovono la filigrana.
PixVerse guida sul budget. Trasforma una singola immagine fissa in una breve clip stilizzata, con controllo del fotogramma iniziale e finale in modo da poter guidare il movimento tra due fotogrammi chiave, e ha un ampio catalogo di effetti virali con un solo tocco. Il compromesso sono clip brevi e una coerenza narrativa più debole.
Runway e Kling si collocano all'estremità della produzione per chi ha bisogno di controllo multi-scena e lavoro di camera. E gli stessi produttori di modelli, OpenAI, Google e xAI, continuano a far avanzare i loro modelli video, con la funzionalità «da singola immagine a video» sempre più integrata nelle app principali piuttosto che venduta come cosa separata.
Come usare davvero questi strumenti senza sprecare tempo
Le persone che oggi ottengono un valore reale dall'immagine-a-video condividono alcune abitudini, e vale la pena copiarle.
Parti da una buona immagine fissa. L'animazione non può correggere una cattiva immagine sorgente. Se il personaggio è sfocato, decentrato o in una posa goffa, il video sarà sfocato, decentrato e in una posa goffa, in movimento. Genera o scegli prima un'immagine fissa pulita e ben illuminata, e l'animazione avrà qualcosa su cui lavorare.
Progetta in base al limite della clip. La maggior parte di questi strumenti arriva a circa dieci-quindici secondi, e i migliori risultati restano ben dentro quel limite. Pianifica un loop, un gancio o un singolo momento piuttosto che una scena. Cercare di spingere uno strumento oltre ciò che sa fare è il modo in cui finisci con i fotogrammi fusi che tutti hanno visto.
Usa i fotogrammi chiave quando lo strumento li offre. PixVerse e altri ti permettono di impostare un fotogramma iniziale e uno finale, il che dà al modello due ancore tra cui interpolare. Questa sola abitudine elimina la maggior parte della deriva e fa sembrare il movimento intenzionale invece che casuale.
E sii onesto riguardo al risultato. Questi strumenti sono più forti per contenuti stilizzati, guidati dai personaggi o per la rotazione di prodotti. Non sono ancora un sostituto dei filmati reali quando realismo e fiducia contano. Per un meme, un post social o un loop di prodotto, sono pronti. Per qualsiasi cosa debba sembrare girata dal vero, non lo sono.
I creatori che prosperano con l'immagine-a-video sono quelli che la trattano come un nuovo tipo di macchina da presa, con i suoi limiti, piuttosto che come una versione più economica di quella vecchia. Impara i limiti e gira dentro di essi, e una singola immagine fissa diventa una tela sorprendentemente grande.
Cosa è davvero utilizzabile oggi
La versione onesta è che l'immagine-a-video ha superato il confine da «demo» a «utile per clip brevi», ma non ha ancora varcato quello verso «pronto per la produzione di contenuti lunghi».
Per un loop di dieci secondi di un personaggio che balla, un post social stilizzato o una rotazione di prodotto per una pubblicità, gli strumenti sono abbastanza buoni da rendere il risultato valido. Per qualsiasi cosa richieda continuità narrativa, lavoro di camera coerente o un minuto intero di filmato coerente, gli strumenti continuano a cedere.
Non è una critica. È semplicemente il punto in cui si trova la tecnologia. Le persone che oggi traggono valore dall'immagine-a-video sono quelle che rispettano il limite di durata della clip e progettano di conseguenza, invece di combatterlo.
La frontiera però è reale. Il settore è stato chiaro: la generazione 3D e l'animazione video da singole immagini sono il prossimo grande passo, che dovrebbe maturare nel giro di uno o due anni. Il fatto che gli strumenti open-source e chiusi stiano ora convergendo sull'animazione dei personaggi da una singola immagine fissa significa che il pezzo più difficile, la fisica del movimento, viene finalmente trattato come un problema ingegneristico risolvibile invece che come una curiosità di ricerca.
Articoli correlati
Lo stack open-source per le immagini IA viene ricostruito, un workflow alla volta
Workflow1111 ricrea AUTOMATIC1111 con 73 nodi e 11 pipeline. Cosa significa la ricostruzione della community per la generazione locale di immagini.
I numeri dietro la generazione di immagini IA: un calo dei prezzi del 99% ha fagocitato la fotografia stock
Dimensioni del mercato, sconvolgimento della fotografia stock, numeri di adozione e flusso di lavoro ibrido, spiegati attraverso le statistiche.
Settembre 2026: come scegliere gli strumenti AI cinesi per la generazione di immagini – confronto tra Jimeng, Tongyi Wan
Confronto dettagliato tra Jimeng, Tongyi Wanxiang, Kling, Doubao e LiblibAI: qualità dell'immagine, comprensione del cinese, copyright per uso commerciale, quota gratuita. Scegli lo strumento giusto in base alle tue esigenze.
Flux 2 vs Stable Diffusion 3.5: la corsa open-source alle immagini ha un chiaro vincitore
Flux 2 guida per qualità, Stable Diffusion 3.5 conserva l'ecosistema più profondo. Come scegliere tra i due nel 2026.