
La próxima frontera de la IA: convertir una única imagen fija en una escena en movimiento
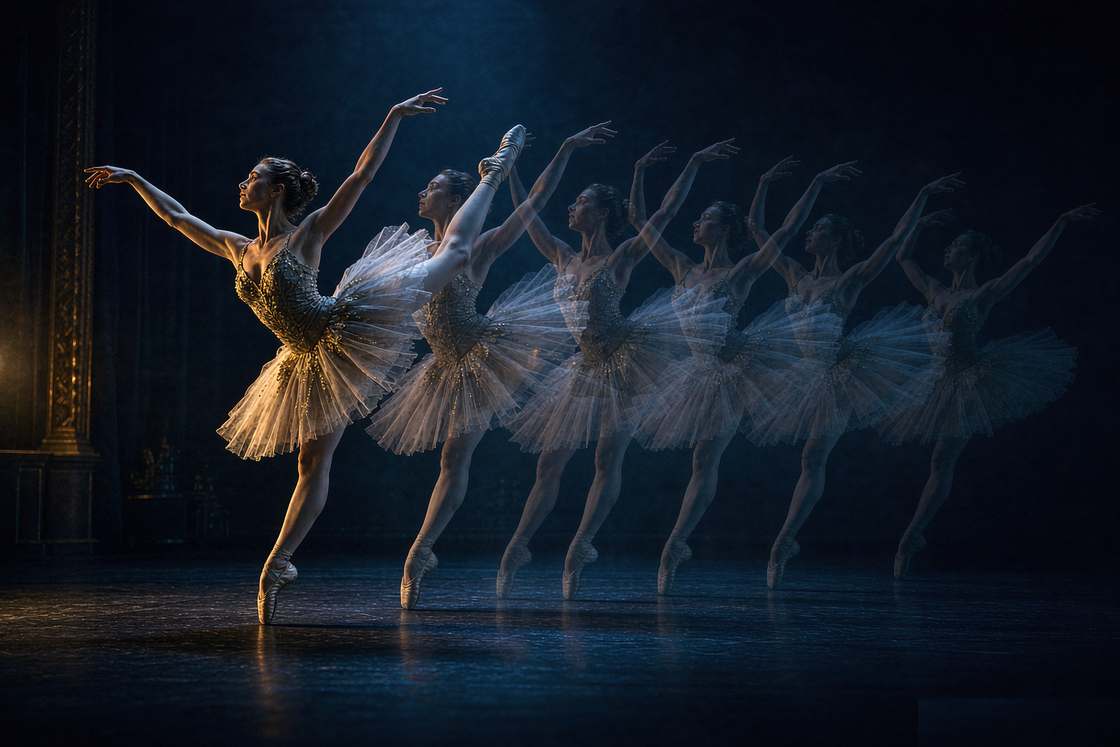
La generación de imágenes ha mejorado lo suficiente como para que la conversación avance. La nueva frontera, la que persiguen esta temporada las herramientas y los investigadores, es el video. En concreto, tomar una imagen fija y hacer que se mueva.
Eso parece un paso pequeño, pero es un problema técnico distinto. Un modelo de difusión de imágenes refina el ruido hasta convertirlo en un único fotograma coherente. El video implica cientos de fotogramas que deben mantenerse coherentes entre sí, con la física del sujeto y con la imagen original. Si sale mal, la cara del personaje se derrite a los tres segundos.
Aquí es donde se está concentrando la energía en 2026, y vale la pena entender qué es realmente posible ahora, porque la brecha entre la demo y la herramienta utilizable sigue siendo el centro de todo.
El problema de la física y por qué fue difícil
La manera más clara de ver por qué esto es difícil es observar lo que hace una buena herramienta de imagen a video cuando funciona.
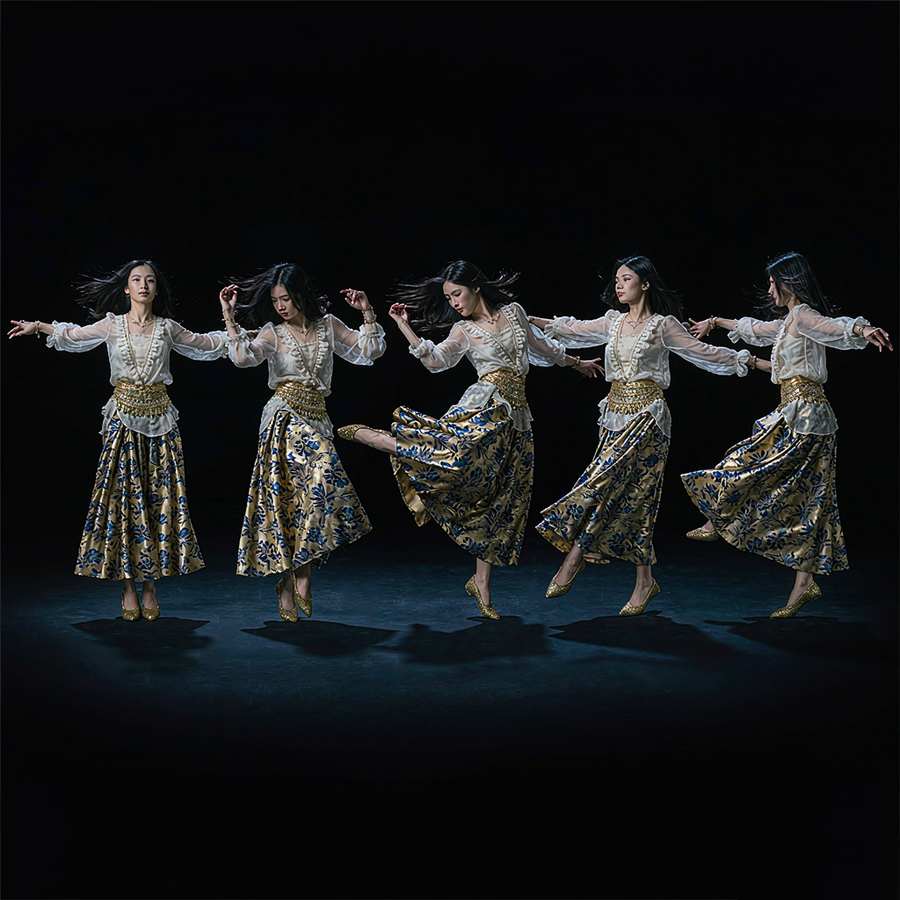
Tomemos un personaje. Una imagen fija de una persona es una pose congelada. Para animar a esa persona bailando, caminando o saludando, el modelo debe entender la geometría del cuerpo, no solo los píxeles. Si solo copia patrones visuales, las extremidades se deslizan, las proporciones se deforman y se obtiene ese movimiento derretido y de marioneta que definió a las primeras herramientas.
Viggle, la herramienta que se hizo famosa precisamente por esto, construyó su reputación con un enfoque distinto. Su modelo JST-1 es un modelo de física 3D, no un modelo de difusión puro. Funciona a partir de la comprensión de la geometría corporal, por eso las proporciones del personaje se mantienen durante coreografías rápidas y complejas en las que los generadores fotograma a fotograma tienden a desmoronarse. El modelo impulsa la animación de personajes a partir de una única imagen fija y se ha convertido en la opción por defecto para creadores de memes y de contenido corto que quieren que un personaje baile.
El lado del código abierto está despertando
El mundo del código abierto ha sido más lento aquí, porque entrenar generación de video es caro. Pero se está moviendo.
Viggle lanzó Viggle-Animate en Hugging Face en septiembre, un modelo de imagen a video orientado al reemplazo de personajes y la edición de video, destilado de MiniMax-H3. La destilación es el truco de entrenar un modelo más pequeño para que reproduzca el comportamiento de un modelo matriz más grande, lo que importa cuando el objetivo es una inferencia más rápida y menores costos de cómputo. El lanzamiento tiene un alcance limitado: intercambio de personajes y edición de metraje existente en lugar de generar clips desde cero, pero pone una herramienta creada específicamente para eso en manos de los desarrolladores sin una API cerrada.
Vale la pena seguir ese patrón. Todos los problemas difíciles de la IA acaban abriéndose, y la edición de video basada en personajes era uno de los más difíciles de mantener cerrado. El lanzamiento abierto es tosco y la licencia no es estándar, pero es una señal de que la pila de código abierto está alcanzando a las herramientas cerradas.
El panorama comercial
En el lado comercial, el campo se ha organizado en nichos.
Viggle domina la animación de personajes a partir de imágenes fijas. No es una herramienta de video de propósito general, y no maneja paisajes ni productos, pero para hacer que un personaje baile o pose a partir de una imagen no tiene un rival real. El plan gratuito ofrece cinco videos con marca de agua al día, y los planes de pago añaden resolución y eliminan la marca de agua.
PixVerse lidera en presupuesto. Convierte una única imagen fija en un clip corto estilizado, con control de fotograma inicial y final para guiar el movimiento entre dos fotogramas clave, y tiene un amplio catálogo de efectos virales de un toque. La desventaja son clips cortos y una coherencia narrativa más débil.
Runway y Kling se ubican en el extremo de producción para quienes necesitan control de múltiples escenas y trabajo de cámara. Y los propios creadores de modelos —OpenAI, Google y xAI— siguen impulsando sus modelos de video, con la capacidad de "imagen única a video" cada vez más integrada en las aplicaciones principales en lugar de venderse como algo separado.
Cómo usar realmente estas herramientas sin perder el tiempo
Las personas que están obteniendo valor real de imagen a video en este momento comparten algunos hábitos, y vale la pena copiarlos.
Empieza con una buena imagen fija. La animación no puede arreglar una imagen de origen deficiente. Si el personaje está borroso, descentrado o en una pose extraña, el video estará borroso, descentrado y en una pose extraña, en movimiento. Genera o elige primero una imagen fija limpia y bien iluminada, y la animación tendrá material con el que trabajar.
Diseña teniendo en cuenta el límite del clip. La mayoría de estas herramientas alcanzan un máximo de unos diez a quince segundos, y los mejores resultados se mantienen muy por debajo de eso. Planea un bucle, un gancho o un único momento en lugar de una escena. Intentar estirar una herramienta más allá de lo que hace es la manera de acabar con los fotogramas derretidos que todos hemos visto.
Usa fotogramas clave cuando la herramienta los ofrezca. PixVerse y otras te permiten definir un fotograma inicial y uno final, lo que le da al modelo dos anclas entre las cuales interpolar. Ese único hábito elimina la mayor parte de la deriva y hace que el movimiento se sienta deliberado en lugar de aleatorio.
Y sé honesto con el resultado. Estas herramientas son más potentes para contenido estilizado, basado en personajes o para giros de producto. Todavía no son un sustituto del metraje real cuando importan el realismo y la confianza. Para un meme, una publicación social o un bucle de producto, están listas. Para cualquier cosa que deba parecer grabada, no lo están.
Los creadores que prosperan con imagen a video son quienes lo tratan como un nuevo tipo de cámara, con sus propios límites, en lugar de una versión más barata de la anterior. Aprende los límites y graba dentro de ellos, y una única imagen fija se convierte en un lienzo sorprendentemente grande.
Qué es realmente utilizable hoy
La versión honesta es que imagen a video ha pasado de "demo" a "útil para clips cortos", pero no ha llegado a "lista para producción en formatos largos".
Para un bucle de diez segundos de un personaje bailando, una publicación social estilizada o un giro de producto para un anuncio, las herramientas son lo bastante buenas como para que el resultado valga el esfuerzo. Para cualquier cosa que necesite continuidad narrativa, trabajo de cámara consistente o un minuto completo de metraje coherente, las herramientas todavía se desmoronan.
Eso no es una crítica. Es simplemente dónde está la tecnología. Las personas que obtienen valor de imagen a video ahora mismo son las que respetan el límite de duración del clip y diseñan en torno a él, en lugar de luchar contra él.
Pero la frontera es real. La industria ha sido clara en que la generación 3D y la animación de video a partir de imágenes únicas son el siguiente gran paso, y se espera que maduren en el próximo año o dos. El hecho de que las herramientas abiertas y cerradas estén convergiendo ahora en la animación de personajes a partir de una única imagen fija significa que la pieza más difícil, la física del movimiento, por fin se está tratando como un problema de ingeniería solucionable y no como una curiosidad de investigación.
Artículos relacionados
El stack de imágenes de IA de código abierto se está reconstruyendo, un flujo de trabajo a la vez
Workflow1111 recrea AUTOMATIC1111 con 73 nodos y 11 pipelines. Qué significa la reconstrucción comunitaria para la generación local de imágenes.
Las cifras detrás de la generación de imágenes con IA: una caída del 99 % en el precio se comió la fotografía de stock
Tamaño del mercado, disrupción de la fotografía de stock, cifras de adopción y el flujo de trabajo híbrido, explicados a través de las estadísticas.
Cómo elegir herramientas de IA generadora de imágenes chinas en septiembre de 2026: comparativa de Jimeng, Tongyi Wanxia
Comparativa detallada de Jimeng, Tongyi Wanxiang, Kling, Doubao y LiblibAI: calidad de imagen, comprensión del chino, derechos de autor comerciales y cuota gratuita, para que elijas la herramienta adecuada según tus necesidades.
Flux 2 vs Stable Diffusion 3.5: La carrera de imágenes de código abierto tiene un líder claro
Flux 2 lidera en calidad, Stable Diffusion 3.5 conserva el ecosistema más profundo. Cómo elegir entre ellos en 2026.