
AIの次のフロンティアは、1枚の静止画を動くシーンへ変えること
画像生成は十分に良くなり、会話は先へ進んでいる。今シーズン、ツールと研究者が追いかけている新たなフロンティアは動画だ。具体的には、1枚の静止画を動かすことだ。
それは小さな一歩に聞こえるが、技術的には別の問題だ。拡散画像モデルはノイズを1枚の一貫性のあるフレームへと洗練させる。動画とは、互いに、被写体の物理法則と、元の画像と一貫性を保たなければならない何百ものフレームを意味する。間違えれば、キャラクターの顔は3秒で溶けてしまう。
ここが2026年にエネルギーが向かっている場所であり、今実際に何が可能なのかを理解する価値がある。デモと使えるツールの間のギャップが、依然としてすべての勝負だからだ。
物理の問題、そしてなぜ難しかったのか
これがなぜ難しいのかを最も明確に理解する方法は、優れた画像から動画へのツールが機能するときに何をするかを見ることだ。
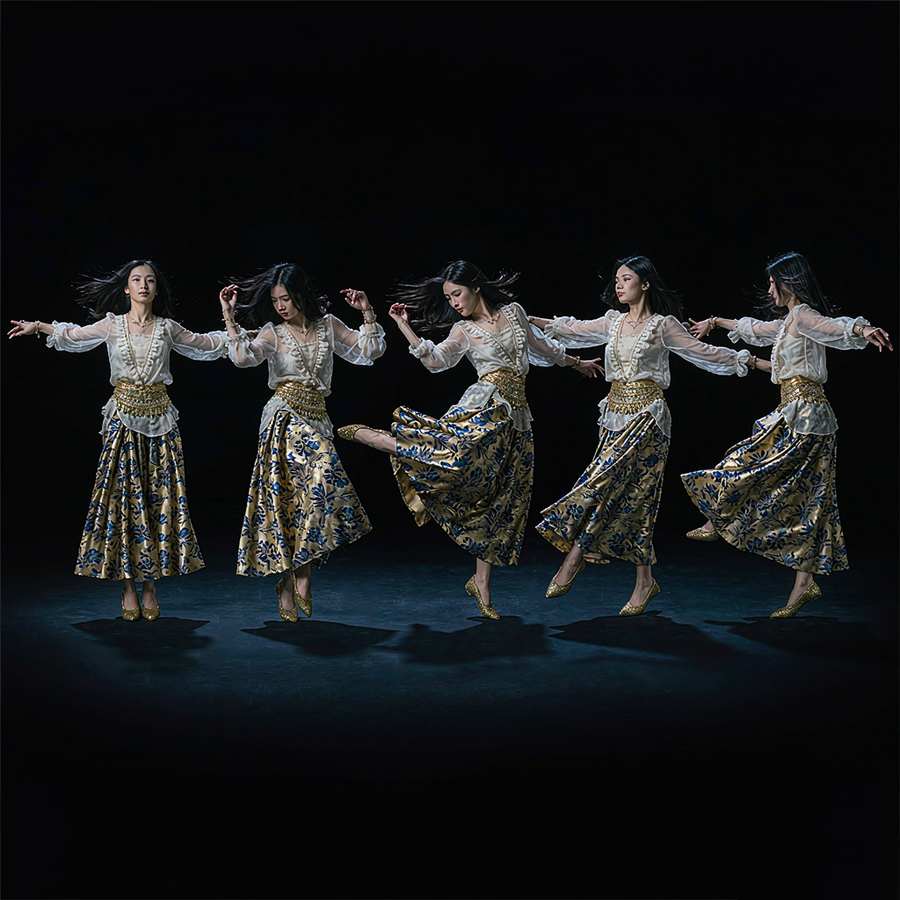
キャラクターを例に取ろう。人物の静止画は、凍りついた1つのポーズだ。その人物が踊ったり、歩いたり、手を振ったりするのをアニメーション化するには、モデルはピクセルだけでなく身体の幾何学を理解しなければならない。視覚パターンをコピーするだけでは、手足がずれ、プロポーションが歪み、初期のツールを特徴づけた溶けたような操り人形のような動きになってしまう。
まさにこれで有名になったツールViggleは、異なるアプローチで評判を築いた。そのJST-1モデルは純粋な拡散モデルではなく、3D物理モデルだ。身体の幾何学の理解に基づいて動作するため、フレームごとの生成器では崩れがちな速く複雑な振り付けでもキャラクターのプロポーションが保たれる。このモデルは1枚の静止画からのキャラクターアニメーションを支えており、キャラクターを踊らせたいミーム制作者やショート動画クリエイターにとってデフォルトの存在になっている。
オープンソース側も目を覚ましつつある
オープンソースの世界はここでは遅れていた。動画生成の学習にはコストがかかるからだ。しかし動き始めている。
Viggleは9月にHugging FaceでViggle-Animateを公開した。MiniMax-H3から蒸留された、キャラクター置換と動画編集を目的とした画像から動画へのモデルだ。蒸留とは、より大きな親モデルの挙動を再現するようにより小さなモデルを訓練する手法で、より高速な推論と低い計算コストが目標の場合に重要となる。今回のリリースはスコープが狭く、ゼロからクリップを生成するのではなく既存映像のキャラクター差し替えと編集に限られるが、クローズドなAPIなしで開発者の手に目的特化型ツールを届けるものだ。
このパターンは注目に値する。AIのあらゆる難しい問題は最終的にオープン化されるもので、キャラクター駆動の動画編集はクローズドに保つのが特に難しいものの1つだった。オープンリリースは粗削りでライセンスも非標準的だが、オープンソースのスタックがクローズドなツールに追いつきつつあるというシグナルだ。
商用ツールの状況
商用側では、この分野はニッチごとに棲み分けが進んでいる。
Viggleは静止画からのキャラクターアニメーションを独占している。汎用動画ツールではなく、風景や製品は扱えないが、1枚の画像からキャラクターを踊らせたりポーズを取らせたりすることに関しては、真のライバルがいない。無料枠では1日5本の透かし付き動画が作成でき、有料プランでは解像度が上がり透かしが除去される。
PixVerseは低価格帯をリードしている。1枚の静止画を短いスタイライズドクリップに変換し、開始フレームと終了フレームを制御できるため、2つのキーフレーム間の動きを誘導できる。ワンタップのバイラルエフェクトの豊富なカタログも持つ。トレードオフは、クリップが短く、物語の一貫性が弱いことだ。
RunwayとKlingは、マルチシーンの制御やカメラワークを必要とする人向けのプロダクション側に位置する。そしてモデルメーカー自身、OpenAI、Google、xAIも動画モデルを前進させ続けており、「1枚の画像から動画」機能は、別売りではなくメインアプリに統合される傾向が強まっている。
時間を無駄にせず実際にこれらのツールを使う方法
今、画像から動画で実際に価値を得ている人々には共通するいくつかの習慣があり、真似する価値がある。
良い静止画から始めること。アニメーションは質の悪い元画像を修正できない。キャラクターがぼやけていたり、中央からずれていたり、不自然なポーズだったりすれば、動画も動きの中でぼやけ、中央からずれ、不自然なポーズになる。まずクリーンで明るい静止画を生成または選べば、アニメーションに使える素材ができる。
クリップの長さ制限を前提に設計すること。これらのツールのほとんどは10〜15秒程度が上限で、最高の結果はその範囲内に十分収まる。シーンではなく、ループ、フック、または単一のビートを計画しよう。ツールの能力を超えて無理に引き伸ばそうとすると、誰もが見たことのある溶けたフレームに行き着く。
ツールがキーフレームを提供している場合は使うこと。PixVerseなどでは開始フレームと終了フレームを設定でき、モデルに補間すべき2つのアンカーを与えられる。この習慣だけでドリフトの大部分がなくなり、動きがランダムではなく意図的に感じられるようになる。
そして出力について正直になること。これらのツールは、スタイライズされた、キャラクター主導の、または製品スピン系のコンテンツに最も強い。リアリズムと信頼が重要な場合、実際の映像の代替にはまだなっていない。ミーム、ソーシャル投稿、製品ループには十分使える。実際に撮影されたように見えなければならないものには、まだ使えない。
画像から動画で成功しているクリエイターは、それを古いカメラの安価な代替ではなく、独自の限界を持つ新しい種類のカメラとして扱う人たちだ。限界を学び、その範囲内で撮影すれば、1枚の静止画は驚くほど大きなキャンバスになる。
今実際に使えるものは何か
正直なところ、画像から動画は「デモ」から「短いクリップには有用」へと越えたが、「長編向けに本番運用可能」へはまだ越えていない。
キャラクターが踊る10秒のループ、スタイライズドなソーシャル投稿、広告用の製品スピンであれば、ツールは努力に見合う結果を出せるほど十分に優れている。物語の連続性、一貫したカメラワーク、または1分間の首尾一貫した映像が必要なものでは、ツールは依然として崩れてしまう。
これは批判ではない。単にテクノロジーが今ある場所だ。現在、画像から動画で価値を得ている人々は、クリップの長さ制限を尊重し、それに逆らうのではなく、それに合わせて設計する人たちだ。
とはいえ、フロンティアは本物だ。業界は、3D生成と単一画像からの動画アニメーションが次の主要なステップであり、今後1〜2年で成熟すると明確にしている。オープンソースとクローズドなツールが現在、単一静止画からのキャラクターアニメーションに収束しつつあるという事実は、最も難しい部分である動きの物理が、ついに研究上の好奇心ではなく解決可能な工学的問題として扱われ始めていることを意味する。
関連記事
オープンソースAI画像スタックは、1つのワークフローずつ再構築されている
Workflow1111は73ノードと11パイプラインでAUTOMATIC1111を再現する。コミュニティによる再構築がローカル画像生成にとって意味するもの。
AI画像生成の裏にある数字:99%の価格下落がストックフォトを食い尽くした
市場規模、ストックフォトの破壊、導入件数、ハイブリッドなワークフローを、統計を通して解説する。
Flux 2 vs Stable Diffusion 3.5:オープンソース画像レースには明確なリーダーがいる
Flux 2は品質でリードし、Stable Diffusion 3.5は最も深いエコシステムを維持。2026年にどちらを選ぶべきか。
AI生成画像の所有者は誰か?著作権とFireflyの例外
ライセンス、補償、Adobe Fireflyの法的保護。2026年に安全に公開できるものとは。