
AI 的下一个前沿:把一张静态图片变成动态场景
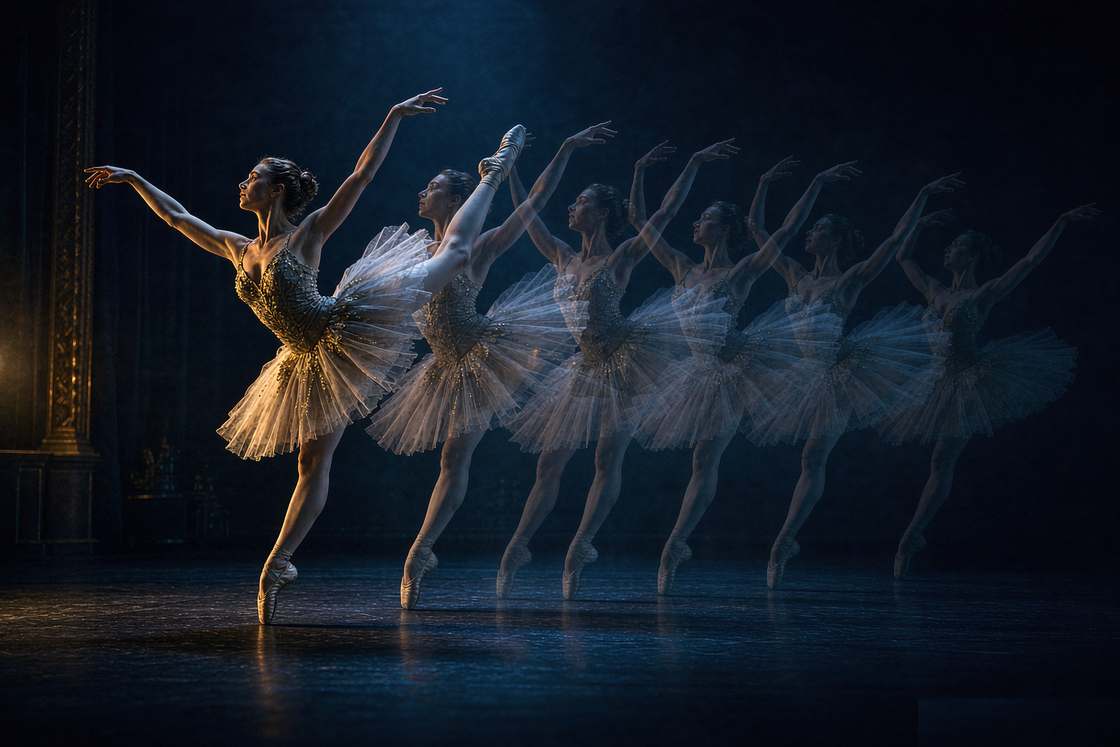
图像生成已经足够成熟,讨论正在转向下一个话题。这个季度,工具和研究者在追逐的新前沿是视频。具体来说,就是让一张静态图像动起来。
这听起来像是一小步,但它是一个不同的技术问题。扩散图像模型把噪声精炼成单个连贯帧。视频意味着成百上千帧必须彼此保持一致,与主体的物理规律保持一致,并与原始图像保持一致。一旦出错,角色的脸三秒后就会“融化”。
这就是 2026 年能量汇聚的方向,也值得弄清楚现在到底能做到什么,因为演示与可用工具之间的差距,仍然是决定成败的关键。
物理问题,以及它为什么难
要看清它为什么难,最直接的方法是观察一款优秀的图生视频工具在正常工作时做了什么。
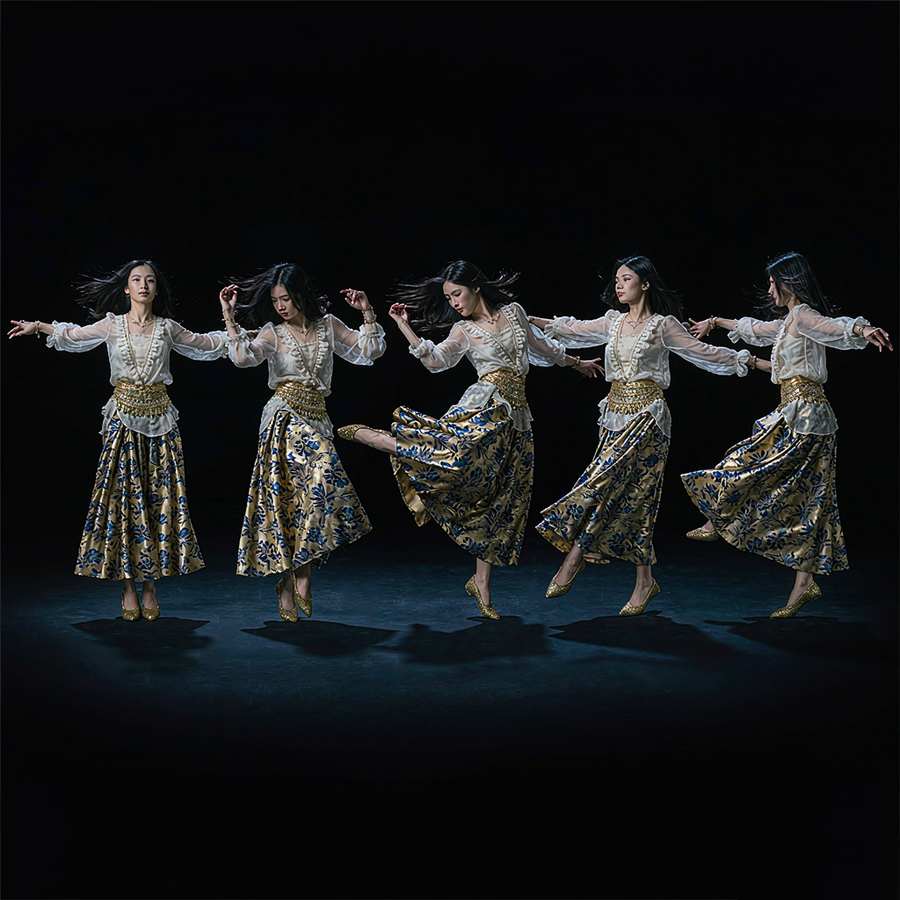
拿一个角色举例。一个人的静态图像只是一个被冻结的姿势。要让这个人跳舞、走路或挥手,模型必须理解身体几何结构,而不只是像素。如果它只复制视觉模式,四肢就会漂移,比例就会扭曲,得到早期工具标志性的“融化”、木偶般的动作。
Viggle 正是因此成名,它依靠另一种方法建立了口碑。它的 JST-1 模型是一个 3D 物理模型,而不是纯扩散模型。它从对身体几何结构的理解出发,因此在快速、复杂的编舞中,角色比例依然能够保持稳定,而逐帧生成器往往会在这里崩溃。该模型从单张静态图驱动角色动画,已经成为想让角色跳舞的表情包制作者和短视频创作者的首选。
开源一方正在苏醒
开源世界在这方面的进展较慢,因为视频生成的训练成本很高。但它正在行动。
Viggle 于 9 月在 Hugging Face 上发布了 Viggle-Animate,这是一个面向角色替换和视频编辑的图生视频模型,由 MiniMax-H3 蒸馏而来。蒸馏是一种训练较小模型来复现更大父模型行为的技巧,当目标是更快推理和更低算力成本时,这一点很重要。该版本的应用范围较窄,主要用于角色替换和编辑现有素材,而不是从零生成片段,但它把一个专用工具交到了开发者手中,无需封闭 API。
这种模式值得关注。AI 领域每一个难题最终都会被开放,而角色驱动的视频编辑正是最难保持封闭的领域之一。开源版本还很粗糙,许可证也非标准,但它释放出一个信号:开源技术栈正在追赶闭源工具。
商业格局
在商业化方面,这一领域已经分化出各自的细分市场。
Viggle 主导了静态图角色动画。它不是一款通用视频工具,也不擅长处理风景或产品,但要让一个角色从一张图像跳舞或摆姿势,它几乎没有真正的对手。免费层级每天提供五个带水印的视频,付费方案可提升分辨率并去除水印。
PixVerse 在性价比上领先。它能把单张静态图变成一段风格化短视频,并提供起始帧和结束帧控制,让你在两个关键帧之间引导运动,还拥有丰富的一键爆款特效库。代价是片段较短,叙事一致性较弱。
Runway 和 Kling 则位于制作端,面向需要多场景控制和镜头调度的人。而模型厂商本身——OpenAI、Google 和 xAI——也在持续推进各自的视频模型,“单图生成视频”能力正越来越多地整合进主应用,而不是作为独立功能出售。
如何真正使用这些工具而不浪费时间
现在真正从图生视频中获得价值的人都有一些共同习惯,值得借鉴。
从一张好的静态图开始。动画无法修复糟糕的源图。如果角色模糊、偏离中心或姿势别扭,视频就会在运动中也显得模糊、偏离中心和姿势别扭。先制作或挑选一张干净、光线充足的静态图,动画才有发挥的基础。
围绕片段时长限制来设计。这些工具大多上限在十到十五秒左右,最佳结果往往远低于这个时长。规划一个循环、一个钩子或单一节拍,而不是一整个场景。试图把某个工具拉伸到超出其能力范围,最终就会得到人人都见过的“融化帧”。
当工具提供关键帧时,一定要使用。PixVerse 等允许你设置起始帧和结束帧,这给了模型两个可插值的锚点。仅这一个习惯就能消除大部分漂移,让运动显得有意图,而不是随机。
对输出结果要有清醒认识。这些工具最擅长风格化、角色驱动或产品旋转展示类内容。当真实感和可信度很重要时,它们还不能替代实拍素材。对于表情包、社交媒体帖子或产品循环展示,它们已经可用。对于任何必须看起来像实拍的内容,它们还不行。
那些在图生视频上如鱼得水的创作者,都把它当作一种有自身局限的新型相机,而不是旧相机的廉价替代品。了解局限并在局限之内拍摄,单张静态图就会变成一块大得惊人的画布。
今天真正可用的是什么
诚实的说法是,图生视频已经从“演示”跨越到了“对短视频有用”,但还没有跨入“长视频制作就绪”的阶段。
对于十秒的角色舞蹈循环、风格化社媒帖子或广告中的产品旋转展示,这些工具已经足够好,结果值得投入精力。对于任何需要叙事连续性、一致镜头调度或整整一分钟连贯素材的内容,这些工具仍然会崩。
这不是贬低。这只是技术所处的阶段。现在从图生视频中获得价值的人,都是尊重片段时长限制并围绕它来设计,而不是与之对抗的人。
不过,这个前沿是真实的。行业已经明确表示,3D 生成和单图视频动画是下一个重大台阶,预计将在未来一两年内成熟。开源和闭源工具如今都在围绕单张静态图角色动画汇聚,这意味着最困难的部分——运动物理——终于被当作一个可解决的工程问题,而不是研究上的好奇心。
相关文章
开源 AI 图像技术栈正被重建,一次一个工作流
Workflow1111 用 73 个节点和 11 条流水线重建了 AUTOMATIC1111。社区重建对本地图像生成意味着什么。
AI 图像生成背后的数字:99% 的价格暴跌吞噬了图库摄影
通过统计数据解读市场规模、图库摄影冲击、采用数量以及混合工作流。
Flux 2 对比 Stable Diffusion 3.5:开源图像竞赛已有明显领先者
Flux 2 在质量上领先,Stable Diffusion 3.5 拥有最深厚的生态。2026 年如何在两者之间选择。
谁拥有 AI 生成图像?版权与 Firefly 漏洞
许可、赔偿以及 Adobe Firefly 的法律保障:2026 年你可以安全发布什么。