
차세대 AI 프런티어는 정지 이미지 한 장을 움직이는 장면으로 바꾸는 것이다
이미지 생성은 이미 충분히 좋아져서 대화의 초점이 다음 단계로 넘어가고 있다. 이번 시즌 도구들과 연구자들이 쫓는 새로운 프런티어는 비디오다. 구체적으로는 정지 이미지 한 장을 가져와 움직이게 만드는 것이다.
작은 한 걸음처럼 들리지만, 이는 전혀 다른 기술적 문제다. 확산 이미지 모델은 노이즈를 하나의 일관된 프레임으로 정제한다. 비디오는 서로 일관성을 유지해야 하고, 피사체의 물리 법칙과 원본 이미지와도 일관성을 유지해야 하는 수백 개의 프레임을 의미한다. 잘못 만들면 3초 만에 캐릭터의 얼굴이 녹아내린다.
2026년에는 이쪽으로 에너지가 쏠리고 있으며, 지금 실제로 무엇이 가능한지 이해할 가치가 있다. 데모와 실제 사용 가능한 도구 사이의 격차가 여전히 이 분야의 핵심이기 때문이다.
물리 문제, 그리고 그것이 어려웠던 이유
이것이 왜 어려운지 가장 명확하게 보려면, 좋은 이미지-비디오 도구가 제대로 작동할 때 무엇을 하는지 살펴보면 된다.
캐릭터를 예로 들어 보자. 사람의 정지 이미지는 하나의 얼어붙은 포즈다. 그 사람이 춤추거나, 걷거나, 손을 흔드는 모습을 애니메이션으로 만들려면 모델이 픽셀만이 아니라 신체 구조를 이해해야 한다. 시각적 패턴만 복사하면 팔다리가 흐트러지고 비율이 왜곡되며, 초기 도구를 특징지었던 녹아내리는 듯한 꼭두각시 같은 움직임이 나온다.
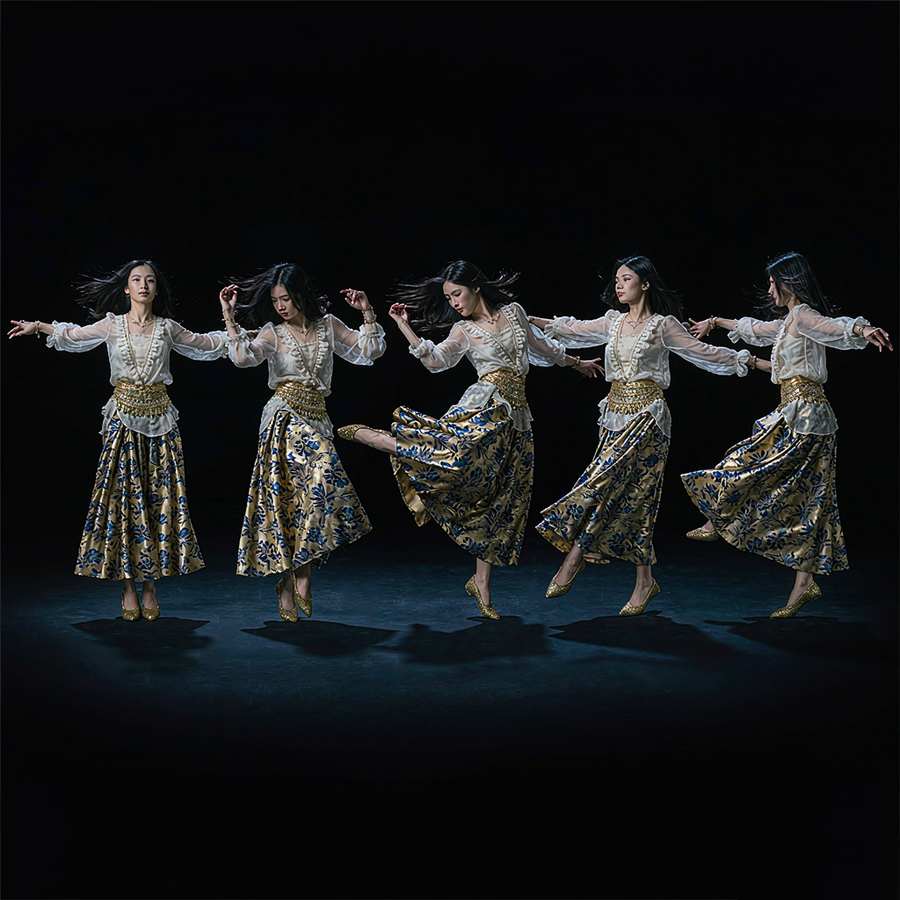
바로 이 문제로 유명해진 도구인 Viggle은 다른 접근 방식으로 명성을 쌓았다. JST-1 모델은 순수 확산 모델이 아니라 3D 물리 모델이다. 신체 구조에 대한 이해를 바탕으로 작동하며, 이것이 프레임별 생성기가 무너지기 쉬운 빠르고 복잡한 안무에서도 캐릭터 비율이 유지되는 이유다. 이 모델은 단일 정지 이미지에서 캐릭터 애니메이션을 구동하며, 캐릭터를 춤추게 만들고 싶어 하는 밈 제작자와 숏폼 크리에이터에게 기본 도구가 되었다.
오픈소스 진영이 깨어나고 있다
오픈소스 세계는 이 분야에서 더뎠다. 비디오 생성은 학습 비용이 비싸기 때문이다. 하지만 움직이고 있다.
Viggle은 9월에 Hugging Face에 Viggle-Animate를 공개했다. 이는 MiniMax-H3에서 증류한, 캐릭터 교체와 영상 편집을 목표로 하는 이미지-비디오 모델이다. 증류는 더 큰 원본 모델의 동작을 재현하도록 더 작은 모델을 학습시키는 기법으로, 더 빠른 추론과 더 낮은 컴퓨팅 비용이 목표일 때 중요하다. 이번 릴리스는 범위가 좁아서 처음부터 클립을 생성하기보다 기존 영상의 캐릭터 교체와 편집에 초점을 맞추지만, 폐쇄형 API 없이도 개발자 손에 목적에 맞는 도구를 쥐여 준다.
이 패턴은 주목할 만하다. AI의 모든 어려운 문제는 결국 개방되며, 캐릭터 중심 비디오 편집은 폐쇄적으로 유지하기 가장 어려운 문제 중 하나였다. 이번 오픈 릴리스는 아직 투박하고 라이선스도 비표준이지만, 오픈소스 스택이 폐쇄형 도구를 따라잡고 있다는 신호다.
상업 지형
상업 측면에서는 이 분야가 틈새 영역으로 나뉘었다.
Viggle은 정지 이미지에서 캐릭터 애니메이션을 만드는 영역을 지배한다. 범용 비디오 도구가 아니며 풍경이나 제품은 처리하지 못하지만, 이미지 한 장으로 캐릭터를 춤추게 하거나 포즈를 취하게 만드는 데는 실질적인 경쟁자가 없다. 무료 요금제는 하루에 워터마크가 있는 동영상 5개를 제공하고, 유료 요금제는 해상도를 높이고 워터마크를 제거한다.
PixVerse는 가성비 측면에서 앞선다. 단일 정지 이미지를 짧은 스타일화된 클립으로 바꾸며, 시작 프레임과 끝 프레임을 제어할 수 있어 두 키프레임 사이의 움직임을 안내할 수 있다. 또한 원탭 바이럴 효과 카탈로그도 방대하다. 단점은 클립이 짧고 내러티브 일관성이 약하다는 점이다.
Runway와 Kling은 다중 장면 제어와 카메라 워크가 필요한 사람들을 위한 프로덕션 쪽에 자리한다. 그리고 모델 제작사들인 OpenAI, Google, xAI는 계속해서 자사의 비디오 모델을 발전시키고 있으며, “단일 이미지를 비디오로” 기능은 별도 제품으로 판매되기보다 주요 앱에 점점 통합되고 있다.
시간 낭비하지 않고 이 도구들을 실제로 사용하는 방법
현재 이미지-비디오에서 실제 가치를 얻는 사람들은 몇 가지 공통 습관을 가지고 있으며, 따라 할 만하다.
좋은 정지 이미지에서 시작하라. 애니메이션은 나쁜 원본 이미지를 고칠 수 없다. 캐릭터가 흐릿하거나, 중심에서 벗어나 있거나, 어색한 포즈를 취하고 있다면, 비디오도 움직이는 상태에서 흐릿하고 중심이 어긋나고 어색한 포즈가 된다. 먼저 깨끗하고 조명이 좋은 정지 이미지를 생성하거나 고르면, 애니메이션이 활용할 재료가 생긴다.
클립 길이 제한을 염두에 두고 설계하라. 대부분의 도구는 약 10~15초에서 끊기며, 최상의 결과물은 그보다 훨씬 안쪽에 머문다. 장면보다는 루프, 훅, 또는 단일 비트를 계획하라. 도구가 할 수 있는 범위 이상으로 끌어당기려 하면 누구나 본 적 있는 녹아내린 프레임을 얻게 된다.
도구가 키프레임을 지원하면 활용하라. PixVerse 등에서는 시작 프레임과 끝 프레임을 설정할 수 있어 모델이 보간할 두 개의 기준점을 갖게 된다. 이 습관 하나만으로 대부분의 흔들림이 사라지고 움직임이 무작위가 아니라 의도된 것처럼 느껴진다.
그리고 결과물에 대해 솔직해져라. 이 도구들은 스타일화된, 캐릭터 중심의, 또는 제품 회전 콘텐츠에 가장 강하다. 사실성과 신뢰가 중요할 때는 아직 실제 촬영 영상을 대체하지 못한다. 밈, 소셜 게시물, 제품 루프에는 준비가 되어 있지만, 실제로 촬영된 것처럼 보여야 하는 모든 것에는 아직 아니다.
이미지-비디오로 성과를 내는 크리에이터는 그것을 기존 카메라의 저렴한 버전이 아니라, 고유한 한계를 가진 새로운 종류의 카메라로 대하는 사람들이다. 한계를 배우고 그 안에서 촬영하면, 단일 정지 이미지는 놀라울 만큼 넓은 캔버스가 된다.
오늘 실제로 사용할 수 있는 것
솔직히 말하면, 이미지-비디오는 “데모”에서 “짧은 클립에 유용한” 단계로 넘어왔지만, “롱폼 제작에 준비된” 단계로 넘어가지는 않았다.
캐릭터가 춤추는 10초 루프, 스타일화된 소셜 게시물, 광고용 제품 회전 영상에는 도구가 충분히 좋아서 노력을 들일 만한 결과가 나온다. 내러티브 연속성, 일관된 카메라 워크, 또는 1분 분량의 일관된 영상이 필요한 모든 것에는 여전히 한계를 드러낸다.
이것은 비판이 아니다. 그저 현재 기술의 위치일 뿐이다. 지금 이미지-비디오에서 가치를 얻는 사람들은 클립 길이 제한을 존중하고 그에 맞춰 설계하는 사람들이지, 그것과 싸우는 사람들이 아니다.
하지만 프런티어는 실제다. 업계는 단일 이미지에서 3D 생성과 비디오 애니메이션이 다음 주요 단계이며, 향후 1~2년 안에 성숙할 것으로 예상된다고 분명히 밝혀 왔다. 오픈소스와 폐쇄형 도구가 이제 단일 정지 이미지에서 캐릭터 애니메이션으로 수렴하고 있다는 사실은, 가장 어려운 부분인 움직임의 물리 문제가 마침내 연구적 호기심이 아니라 해결 가능한 공학 문제로 다뤄지고 있음을 의미한다.
관련 글
오픈소스 AI 이미지 스택이 워크플로 하나씩 재구축되고 있다
Workflow1111은 73개 노드와 11개 파이프라인으로 AUTOMATIC1111을 재현한다. 커뮤니티 재구축이 로컬 이미지 생성에 의미하는 바.
AI 이미지 생성의 이면에 있는 숫자들: 99% 가격 하락이 스톡 사진을 집어삼켰다
시장 규모, 스톡 사진 시장 파괴, 도입 수치와 하이브리드 워크플로를 통계로 설명한다.
Flux 2 vs Stable Diffusion 3.5: 오픈소스 이미지 경쟁, 이제 확실한 선두가 있다
Flux 2는 품질에서 앞서고, Stable Diffusion 3.5는 가장 깊은 생태계를 유지한다. 2026년에 둘 사이에서 선택하는 방법.
AI 생성 이미지의 소유권은 누구에게? 저작권, 그리고 Firefly 예외
라이선스, 면책, 그리고 Adobe Firefly의 법적 보호: 2026년에 안전하게 게시할 수 있는 것.