
NVIDIA 4,999 美元的 DGX Spark 64GB:把千万亿次算力搬上桌面,驱动常驻智能体
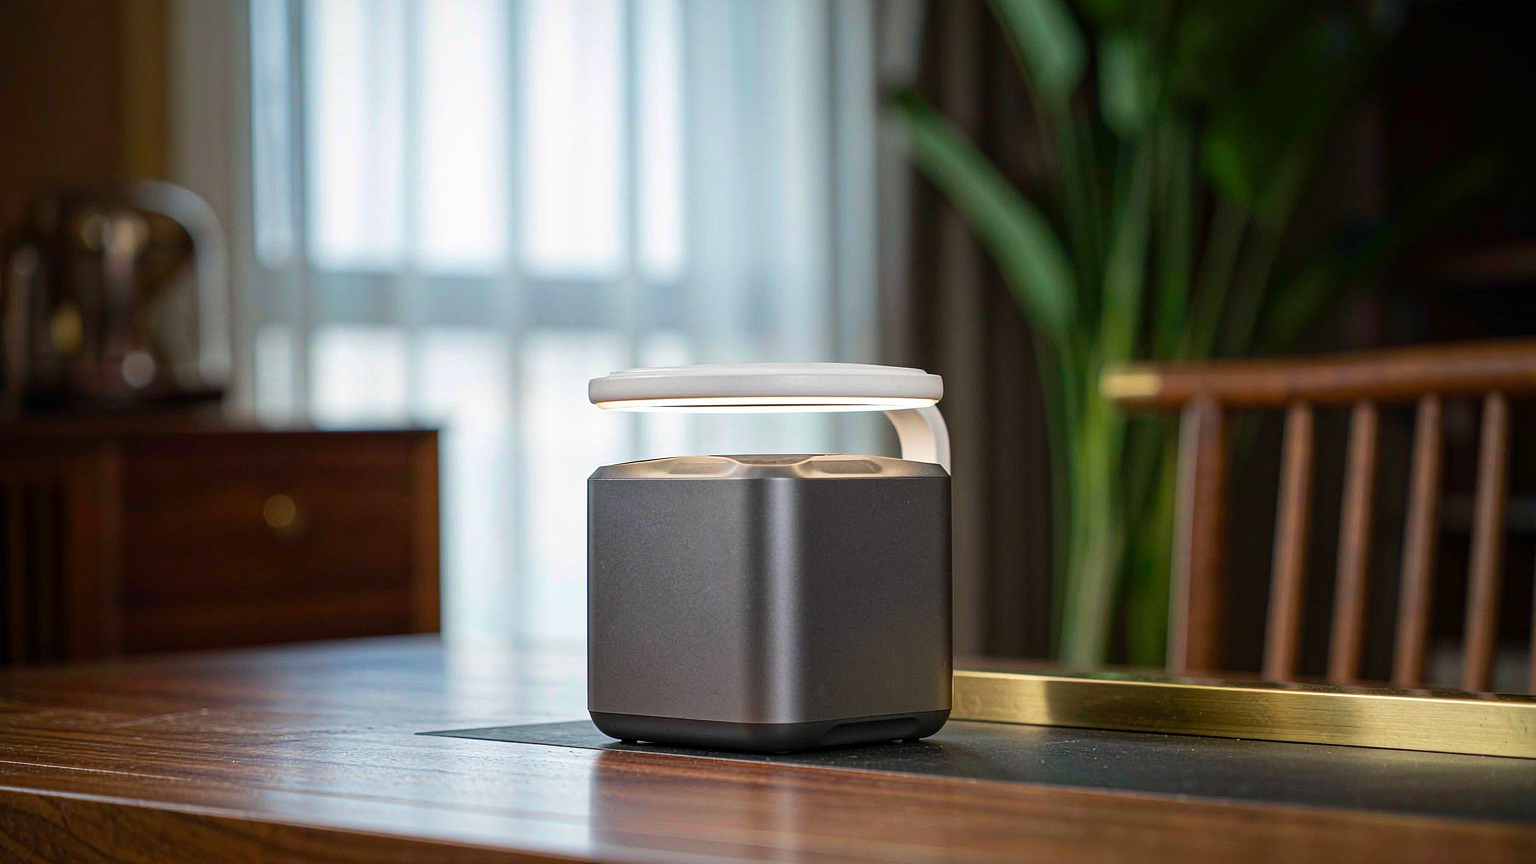
NVIDIA 已确认推出其 DGX Spark 桌面 AI 计算机的 64GB 版本,起售价 4,999 美元,将于 10 月 23 日通过宏碁、华硕、戴尔、技嘉、惠普、微星和新华三发售。128GB 型号继续以 6,950 美元销售。两者均基于 GB10 Grace Blackwell 超级芯片,该芯片将 Blackwell GPU 与 20 核 Arm CPU 封装在一起,并在两者之间共享单个 LPDDR5X 内存池。
架构是卖点。一致性统一内存意味着 CPU 和 GPU 看到相同的地址空间,因此无需在系统 RAM 和 VRAM 之间复制数据。在 64GB 机器上,约 8GB 用于操作系统,留下约 56GB 用于模型权重和随上下文长度增长的 KV 缓存。NVIDIA 将该芯片的 AI 算力标称为在 FP4 格式下最高可达 1 petaflop(千万亿次)。
64GB 实际能运行什么
NVIDIA 将 64GB 配置定位为 30B 至 35B 级别的模型:Qwen3.8-27B、Gemma 4 26B、Meta Muse Glimmer 和 Nemotron 3.5 Lightning。借助 NVFP4 量化——NVIDIA 称其能保持准确率——一台机器可处理最高约 100B 参数的模型。这正是这台机器的意义所在。一年前,这一级别的模型还需要服务器机架。现在,它们能装进一个午餐盒大小的盒子里。
代价是内存带宽。273GB/s 的 Spark 并非为向一百个并发用户提供聊天产品而构建。它是为长输入和短输出而构建的:读取一个代码仓库、一份日志转储或一摞文档,然后写出简短结果。这种形态非常适合智能体,因为智能体大部分时间都在读取上下文,只是偶尔产出答案。
这台机器背后的传承
Spark 并不是 NVIDIA 首次尝试把严肃计算放到桌下。128GB 版本已经以更高价格存在,而 64GB 型号是刻意向更低价位下探。保留相同的 GB10 芯片和相同的统一内存设计,同时将内存减半,降低了入门成本,却不改变机器的用途。这很重要,因为早先型号的定价是工作站级别的,而工作站价格限制了谁买得起。
64GB 配置现在而不是一年前才合理,还有第二个原因。能放进 56GB 的开源模型已经足够好,值得运行。一个 27B 模型配合量化权重和长上下文窗口,可以处理真实的编程和研究任务,而不是玩具提示。半年前,要在本地运行同等能力意味着更大的机器和更高的账单。硬件和模型同时到达了同一个临界点,这才让这次降价变得有意义,而不是装饰性的。
集群是一等功能
每台 DGX Spark 都配备一张最高运行在 200GbE 的 ConnectX-7 网卡,免费的 NVIDIA Sync 应用负责设置。其 Cluster Assistant 会配置网络,让你无需成为网络管理员就能最多连接四台设备。两台 64GB Spark 可合并为 128GB,NVIDIA 称这对组合的性能最高可达单台 128GB 型号的 1.7 倍,因为合并后的计算和带宽大约翻倍。一对设备可用直连电缆连接;四台设备则需要交换机。
实际效果是一种滑动扩展。从一台盒子开始实验,为真实工作负载添加第二台,然后继续扩展,直到工作负载超出本地硬件。扩展时,首个 token 的时间改善最明显,而这对于在行动前读取长输入的智能体来说至关重要。
软件层才是智能体故事所在
Spark 预装 DGX OS、CUDA 堆栈以及常见工具:PyTorch、Jupyter、Ollama,还有针对 vLLM 和 llama.cpp 的调优支持。NVIDIA 声称,借助其优化,本地智能体推理最高可快 1.9 倍。它还捆绑了 OpenShell,这是 NVIDIA Agent Toolkit 的一部分,可对智能体能做什么设置基于策略的边界。
最后这一点与更广泛的趋势相关。随着智能体从演示走向日常使用,瓶颈不再是模型,而是可靠性。一台整夜运行智能体的本地机器需要正确调用工具、从故障中恢复,并且不越界。NVIDIA 正是押注于此:Spark 面向的是常驻智能体,而不是一次性提示。
Perplexity 已经适配了该硬件,推出了一款优化的便携式计算机智能体,可在设备本地运行 118B 模型。这是一个值得注意的信号,因为 Perplexity 是一家云优先公司。如果它在为本地硬件构建产品,那它预期存在一个希望模型运行在自己机器上的用户市场。
适合谁,不适合谁
4,999 美元的价格将 Spark 置于专业领域,而非消费级。受益者是研究人员、独立开发者和小团队,他们运行智能体的频率足够高,以至于按 token 计费的 API 费用会累积起来,或者他们处理的数据不能离开自己的硬件。在私有代码仓库上微调编码模型、对新开源模型进行首日评估,或同时常驻多个模型,这些工作都适合统一内存设计。
对其他人来说,这笔账就没那么清楚了。如果你每天只用几次 AI,云 API 更便宜也更简单。当你的使用量很高、数据敏感,或工作负载持续运行时,Spark 才有意义。64GB 型号降低了入门价格,但并未改变这一逻辑。
有一个细节值得任何做预算的人注意。56GB 可用内存必须同时覆盖权重和 KV 缓存。长上下文会消耗缓存,而智能体工作负载天生就长。一个技术上能放下的量化模型,一旦上下文增长,仍可能撞墙,这就是为什么 NVIDIA 指出,较大模型的 17GB 量化版本比其 55GB 全精度版本更实用。装得下模型和能在长任务上运行良好,是两种不同的测试。
更大的信号
这次发布的有趣之处不是降价。而是一个 27B 或 30B 模型在桌面上运行,现在已经接近几个月前的前沿行为,足以值得围绕这台机器构建产品。硬件和开源模型在同一处汇合:桌下的一个盒子,运行着一个在你睡觉时仍在工作的智能体,而数据从未离开这栋楼。
NVIDIA 正在押注,有足够多的开发者想要这个,从而支撑一条产品线。出货 Spark 的 OEM 名单表明,它认为答案是肯定的,并且未来几年的 AI 工作不会全部发生在数据中心。