
El DGX Spark de 64 GB de NVIDIA, por 4999 dólares, pone un petaflop en el escritorio para agentes siempre activos
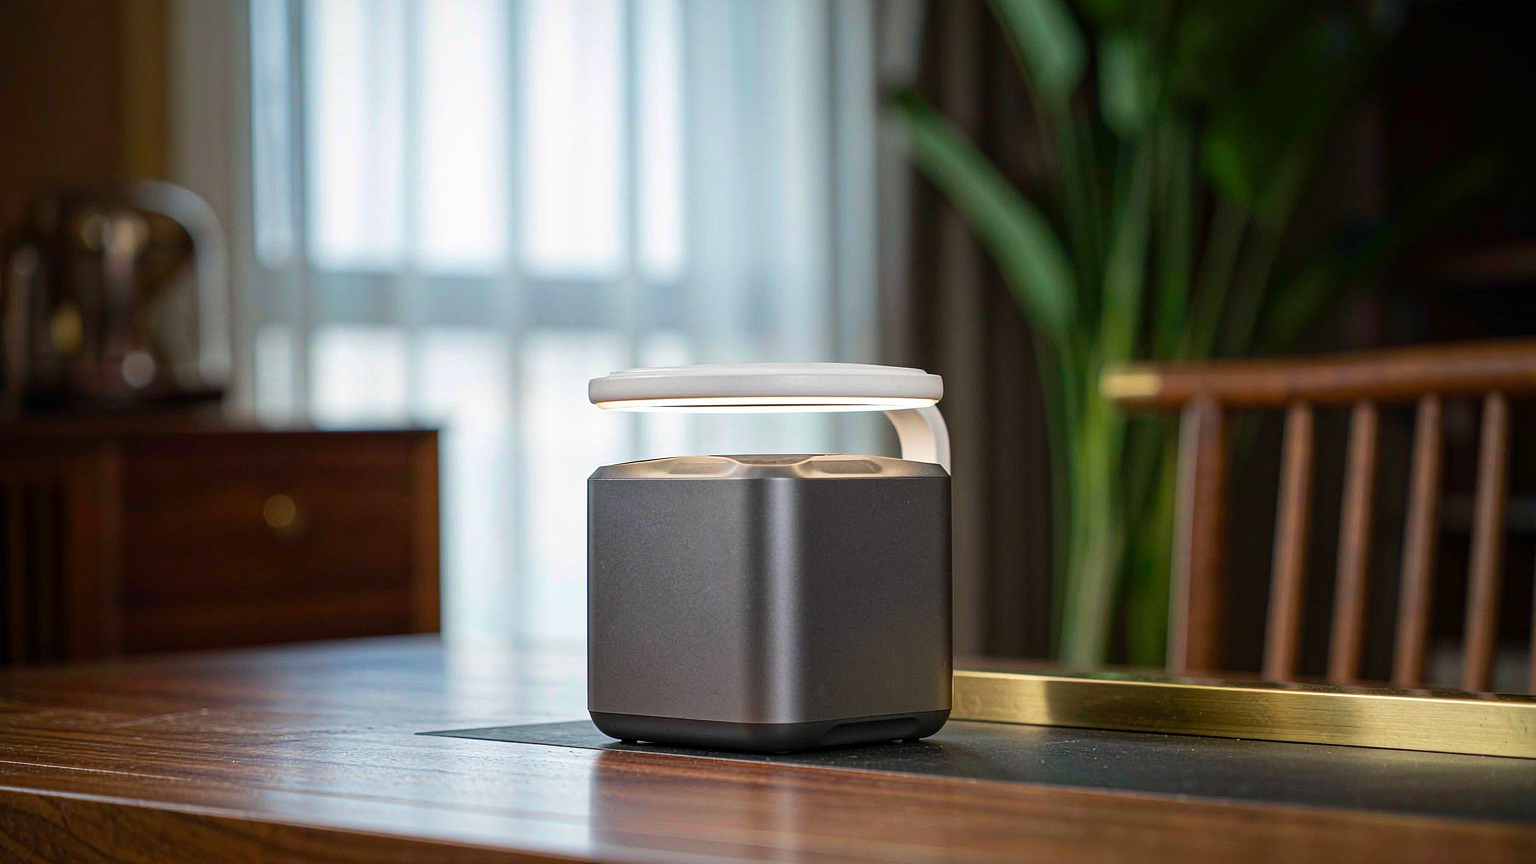
NVIDIA ha confirmado una versión de 64 GB de su computadora de escritorio de IA DGX Spark, con un precio desde 4999 dólares y envíos a partir del 23 de octubre a través de Acer, Asus, Dell, Gigabyte, HP, MSI y H3C. El modelo de 128 GB sigue a la venta por 6950 dólares. Ambos se basan en el superchip GB10 Grace Blackwell, que combina una GPU Blackwell con una CPU Arm de 20 núcleos en un solo encapsulado y comparte un único grupo de memoria LPDDR5X entre ambos.
La arquitectura es el argumento de venta. La memoria unificada coherente hace que la CPU y la GPU vean el mismo espacio de direcciones, por lo que dejas de copiar datos entre la RAM del sistema y la VRAM. En un equipo de 64 GB, aproximadamente 8 GB se destinan al sistema operativo, lo que deja unos 56 GB para los pesos del modelo y la caché KV, que crece con la longitud del contexto. NVIDIA califica el chip con hasta un petaflop de cómputo de IA en formato FP4.
Qué ejecuta realmente 64 GB
NVIDIA posiciona la configuración de 64 GB para modelos de la clase de 30B a 35B: Qwen3.8-27B, Gemma 4 26B, Meta Muse Glimmer y Nemotron 3.5 Lightning. Con la cuantización NVFP4, que según NVIDIA mantiene la precisión, un solo equipo puede manejar modelos de hasta aproximadamente 100B parámetros. Ese es el objetivo de la máquina. Hace un año, los modelos de ese nivel necesitaban un rack de servidores. Ahora caben en una caja del tamaño de una lonchera grande.
La contrapartida es el ancho de banda de memoria. Con 273 GB/s, el Spark no está diseñado para servir un producto de chat a cien usuarios concurrentes. Está diseñado para entradas largas y salidas cortas: leer un repositorio, un volcado de registros o una pila de documentos y escribir un resultado breve. Esa forma encaja bien con los agentes, porque un agente pasa la mayor parte del tiempo leyendo contexto y solo ocasionalmente produce una respuesta.
El linaje detrás del equipo
El Spark no es el primer intento de NVIDIA de poner cómputo serio debajo de un escritorio. La versión de 128 GB ya existía a un precio más alto, y el modelo de 64 GB es un movimiento deliberado hacia un segmento inferior. Mantener el mismo chip GB10 y el mismo diseño de memoria unificada mientras se reduce la memoria a la mitad baja el costo de entrada sin cambiar el propósito de la máquina. Eso importa porque el modelo anterior tenía precio de estación de trabajo, y un precio de estación de trabajo limita quién puede comprar una.
Hay una segunda razón por la que la configuración de 64 GB tiene sentido ahora y no hace un año. Los modelos abiertos que caben en 56 GB son lo suficientemente buenos como para valer la pena ejecutarlos. Un modelo de 27B con pesos cuantizados y una ventana de contexto larga puede manejar tareas reales de programación e investigación en lugar de prompts de juguete. Hace seis meses, ejecutar la capacidad equivalente de forma local implicaba un equipo más grande y una factura más alta. El hardware y los modelos llegaron al mismo umbral, y eso es lo que hace que la reducción de precio sea significativa en lugar de decorativa.
La formación de clústeres es una función de primer nivel
Cada DGX Spark incluye una tarjeta de red ConnectX-7 que funciona a hasta 200 GbE, y la aplicación gratuita NVIDIA Sync se encarga de la configuración. Su Cluster Assistant configura la red para que puedas unir hasta cuatro unidades sin ser administrador de red. Dos Spark de 64 GB se combinan para sumar 128 GB, y NVIDIA afirma que ese par ofrece hasta 1,7 veces el rendimiento de un único modelo de 128 GB, porque el cómputo y el ancho de banda combinados se duplican aproximadamente. Un cable directo conecta un par; cuatro unidades necesitan un conmutador.
La capa de software es donde vive la historia de los agentes
El Spark viene con DGX OS, la pila CUDA y las herramientas habituales: PyTorch, Jupyter, Ollama, además de soporte optimizado para vLLM y llama.cpp. NVIDIA afirma que sus optimizaciones logran una inferencia local de agentes hasta 1,9 veces más rápida. También incluye OpenShell, parte del NVIDIA Agent Toolkit, que establece límites basados en políticas sobre lo que puede hacer un agente.
Esa última pieza conecta con una tendencia más amplia. A medida que los agentes pasan de la demostración al uso diario, el cuello de botella deja de ser el modelo y pasa a ser la fiabilidad. Una máquina local que ejecuta un agente durante la noche necesita hacer llamadas a herramientas correctamente, recuperarse de fallos y no salirse de su alcance. NVIDIA se apoya precisamente en esto: el Spark está dirigido a agentes siempre activos, no a prompts puntuales.
Perplexity ya se ha adaptado al hardware, lanzando un agente informático portátil optimizado que puede ejecutar un modelo de 118B localmente en el dispositivo. Es una señal notable, porque Perplexity es una empresa centrada en la nube. Si está desarrollando para hardware local, espera un mercado de usuarios que quieren el modelo en su propia máquina.
Para quién es esto, y para quién no
El precio de 4999 dólares sitúa al Spark en territorio profesional, no de consumo. Quienes se benefician son investigadores, desarrolladores independientes y equipos pequeños que ejecutan agentes con la suficiente frecuencia como para que las tarifas de API por token se acumulen, o que trabajan con datos que no pueden salir de su propio hardware. El ajuste fino de un modelo de programación en un repositorio privado, ejecutar una evaluación desde el primer día en un nuevo modelo abierto o mantener varios modelos residentes a la vez son tareas que encajan con el diseño de memoria unificada.
Para todos los demás, el cálculo es menos claro. Si usas IA unas pocas veces al día, las API en la nube son más baratas y sencillas. El Spark tiene sentido cuando tu uso es alto, tus datos son sensibles o tu carga de trabajo se ejecuta de forma continua. El modelo de 64 GB baja el precio de entrada, pero no cambia esa lógica.
Hay un detalle que vale la pena señalar para quien esté haciendo presupuesto. Los 56 GB de memoria utilizable tienen que cubrir juntos los pesos y la caché KV. Un contexto largo consume caché, y las cargas de trabajo de los agentes son largas por naturaleza. Un modelo cuantizado que técnicamente cabe puede seguir chocando con el límite una vez que el contexto crece, por lo que NVIDIA señala la versión cuantizada de 17 GB de un modelo más grande como la opción práctica frente a su versión de precisión completa de 55 GB. Que un modelo quepa y que funcione bien en una tarea larga son dos pruebas diferentes.
La señal más importante
La parte interesante de este lanzamiento no es la rebaja de precio. Es que un modelo de 27B o 30B ejecutándose en un escritorio está ahora lo suficientemente cerca del comportamiento de frontera de hace unos meses como para que valga la pena construir un producto en torno a la máquina. El hardware y los modelos abiertos han convergido en el mismo punto: una caja debajo de un escritorio, ejecutando un agente que trabaja mientras duermes, con los datos sin salir nunca del edificio.
NVIDIA apuesta a que suficientes desarrolladores quieren eso como para justificar una línea de productos. La lista de fabricantes OEM que envían el Spark sugiere que cree que la respuesta es sí, y que los próximos años de trabajo en IA no ocurrirán todos en un centro de datos.
Artículos relacionados
Las imágenes de producto con IA chocan con un muro de cumplimiento que nadie incluyó en el cálculo
El coste siempre se cotizó por generación. El coste real se cotiza por activo que sobrevive a la revisión.
Los robots pueden realizar el 74 % del trabajo físico, y casi nada de ello es rentable
La capacidad está en gran medida ahí. La economía no. Cuarenta años hasta el diez por ciento no es un pronóstico que justifique el pánico.
Un modelo agéntico de pesos abiertos de 744B llega bajo una licencia MIT
La licencia es el marketing. Un modelo de 744B que cualquiera puede descargar reinicia el cálculo de comprar versus construir.
Los modelos chinos de video con IA llegan a Hollywood: 73 planos en los efectos visuales de la serie de Amazon
Lo que cruza fronteras no son las series, sino las herramientas para hacerlas.