
Il DGX Spark 64GB da 4.999 $ di NVIDIA mette un petaflop sulla scrivania per agenti sempre attivi
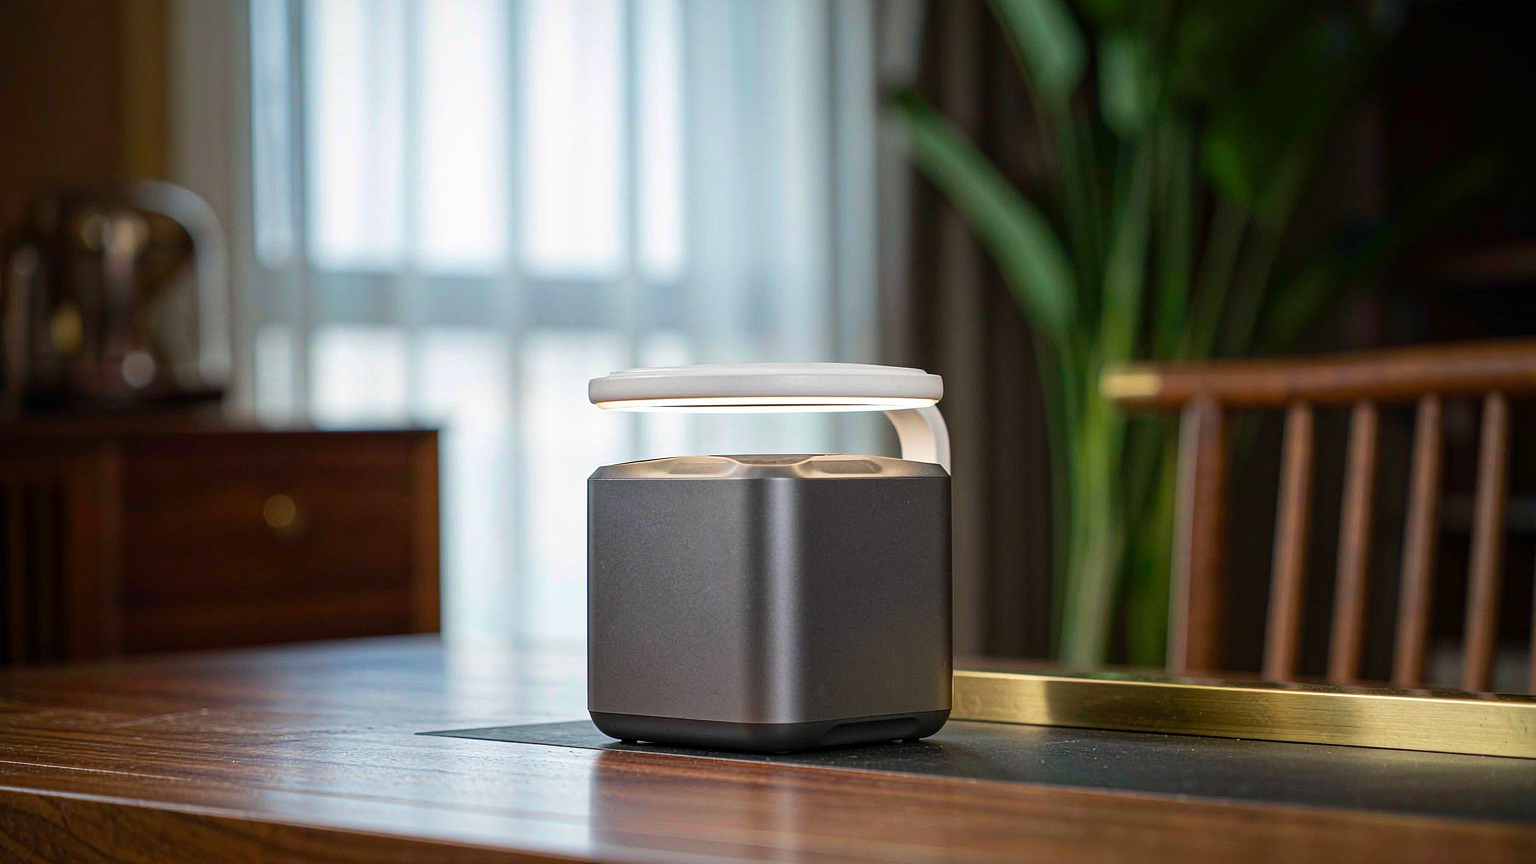
NVIDIA ha confermato una versione da 64 GB del suo computer desktop per AI DGX Spark, con prezzo a partire da 4.999 dollari e spedizioni dal 23 ottobre tramite Acer, Asus, Dell, Gigabyte, HP, MSI e H3C. Il modello da 128 GB resta in vendita a 6.950 dollari. Entrambi si basano sul superchip GB10 Grace Blackwell, che abbina una GPU Blackwell a una CPU Arm a 20 core in un unico package e condivide tra loro un singolo pool di memoria LPDDR5X.
L'architettura è il punto di forza. La memoria unificata coerente significa che CPU e GPU vedono lo stesso spazio di indirizzamento, quindi si smette di copiare dati tra RAM di sistema e VRAM. Su una macchina da 64 GB, circa 8 GB vanno al sistema operativo, lasciandone circa 56 GB per i pesi del modello e la cache KV che cresce con la lunghezza del contesto. NVIDIA dichiara per il chip fino a un petaflop di potenza di calcolo AI nel formato FP4.
Cosa esegue davvero una macchina da 64 GB
NVIDIA posiziona la configurazione da 64 GB per modelli della classe 30B-35B: Qwen3.8-27B, Gemma 4 26B, Meta Muse Glimmer e Nemotron 3.5 Lightning. Con la quantizzazione NVFP4, che secondo NVIDIA mantiene l'accuratezza, una singola macchina può gestire modelli fino a circa 100 miliardi di parametri. È esattamente il senso della macchina. Un anno fa, modelli di quel livello richiedevano un rack di server. Ora entrano in una scatola grande quanto un pranzo al sacco.
Il compromesso è la larghezza di banda della memoria. A 273 GB/s, lo Spark non è progettato per servire un prodotto di chat a cento utenti simultanei. È costruito per input lunghi e output brevi: leggere un repository, un dump di log o una pila di documenti e scrivere un breve risultato. Questa forma si adatta bene agli agenti, perché un agente passa la maggior parte del tempo a leggere contesto e solo occasionalmente produce una risposta.
L'eredità dietro la macchina
Lo Spark non è il primo tentativo di NVIDIA di mettere potenza di calcolo seria sotto una scrivania. La versione da 128 GB esisteva già a un prezzo più alto, e il modello da 64 GB è una deliberata mossa verso il mercato di fascia inferiore. Mantenere lo stesso chip GB10 e lo stesso design di memoria unificata dimezzando la memoria abbassa il costo d'ingresso senza cambiare lo scopo della macchina. Questo conta perché il modello precedente aveva un prezzo da workstation, e un prezzo da workstation limita chi può comprarlo.
C'è una seconda ragione per cui la configurazione da 64 GB ha senso ora anziché un anno fa. I modelli aperti che entrano in 56 GB sono abbastanza buoni da valere la pena di essere eseguiti. Un modello da 27B con pesi quantizzati e una lunga finestra di contesto può gestire compiti reali di programmazione e ricerca, non solo prompt giocattolo. Sei mesi fa, eseguire localmente la capacità equivalente significava una macchina più grande e un conto più salato. L'hardware e i modelli sono arrivati alla stessa soglia, ed è questo che rende il taglio di prezzo significativo e non decorativo.
Il clustering è una funzionalità di primo livello
Ogni DGX Spark viene fornito con una scheda di rete ConnectX-7 che funziona fino a 200GbE, e l'app gratuita NVIDIA Sync gestisce la configurazione. Il suo Cluster Assistant configura la rete in modo da poter unire fino a quattro unità senza essere un amministratore di rete. Due Spark da 64 GB si uniscono per arrivare a 128 GB, e NVIDIA afferma che la coppia offre fino a 1,7 volte le prestazioni di una singola macchina da 128 GB, perché la potenza di calcolo e la larghezza di banda combinate sono all'incirca raddoppiate. Un cavo diretto collega una coppia; quattro unità richiedono uno switch.
Il livello software è dove vive la storia degli agenti
Lo Spark viene fornito con DGX OS, lo stack CUDA e i soliti strumenti: PyTorch, Jupyter, Ollama, più il supporto ottimizzato per vLLM e llama.cpp. NVIDIA dichiara un'inferenza locale degli agenti fino a 1,9 volte più veloce grazie alle sue ottimizzazioni. Include anche OpenShell, parte dell'NVIDIA Agent Toolkit, che imposta confini basati su policy su ciò che un agente può fare.
Quest'ultimo elemento si collega a una tendenza più ampia. Man mano che gli agenti passano dalla demo all'uso quotidiano, il collo di bottiglia smette di essere il modello e diventa l'affidabilità. Una macchina locale che esegue un agente tutta la notte deve effettuare correttamente le chiamate agli strumenti, riprendersi dagli errori e non uscire dal proprio ambito. NVIDIA punta esattamente su questo: lo Spark è pensato per agenti sempre attivi, non per prompt una tantum.
Perplexity si è già adattata all'hardware, rilasciando un agente ottimizzato per computer portatili che può eseguire localmente sul dispositivo un modello da 118B. È un segnale notevole, perché Perplexity è un'azienda cloud-first. Se sta costruendo per l'hardware locale, si aspetta un mercato di utenti che vogliono il modello sulla propria macchina.
Per chi è, e per chi non lo è
Il prezzo di 4.999 dollari colloca lo Spark in territorio professionale, non consumer. Le persone che ne traggono vantaggio sono ricercatori, sviluppatori indipendenti e piccoli team che eseguono agenti abbastanza spesso da far sommare le tariffe API per token, o che lavorano con dati che non possono lasciare il loro hardware. Fare fine-tuning di un modello di programmazione su un repository privato, eseguire una valutazione day-one su un nuovo modello aperto, o mantenere diversi modelli residenti contemporaneamente sono tutti lavori che si adattano al design a memoria unificata.
Per tutti gli altri, il calcolo è meno chiaro. Se usi l'AI qualche volta al giorno, le API cloud sono più economiche e semplici. Lo Spark ha senso quando il tuo utilizzo è elevato, i tuoi dati sono sensibili o il tuo carico di lavoro viene eseguito in modo continuo. Il modello da 64 GB abbassa il prezzo d'ingresso ma non cambia quella logica.
Un dettaglio vale la pena segnalare per chi fa un budget. I 56 GB di memoria utilizzabile devono coprire insieme i pesi e la cache KV. Un contesto lungo consuma cache, e i carichi di lavoro degli agenti sono lunghi per natura. Un modello quantizzato che tecnicamente entra può comunque sbattere contro il muro quando il contesto cresce, ed è per questo che NVIDIA indica la build quantizzata da 17 GB di un modello più grande come scelta pratica rispetto alla sua versione a piena precisione da 55 GB. Far entrare un modello ed eseguirlo bene su un compito lungo sono due test diversi.
Il segnale più ampio
La parte interessante di questo lancio non è il taglio di prezzo. È che un modello da 27B o 30B in esecuzione su un desktop è ormai abbastanza vicino al comportamento di frontiera di qualche mese fa da rendere la macchina degna di costruirci sopra un prodotto. L'hardware e i modelli aperti sono convergiti nello stesso punto: una scatola sotto una scrivania, che esegue un agente che lavora mentre dormi, con i dati che non lasciano mai l'edificio.
NVIDIA scommette che siano abbastanza gli sviluppatori a volerlo da giustificare una linea di prodotti. L'elenco degli OEM che distribuiscono lo Spark suggerisce che pensa che la risposta sia sì, e che i prossimi anni di lavoro sull'AI non si svolgeranno tutti in un data center.
Articoli correlati
ServiceNow trasforma i fallimenti degli agenti in dati di addestramento
La generazione senza verifica è rumore. I cancelli sono il prodotto.
Un unico framework per linguaggio e visione: il modello aperto da 1,6 miliardi di Horizon
Una scommessa sul fatto che i ponti tra linguaggio e visione non siano mai stati necessari.
Il muro fotonico della memoria è la scommessa da 88 milioni di dollari che Volantis ha appena fatto
Il compromesso con cui tutti hanno imparato a convivere è la cosa che sta cercando di eliminare.
Alibaba apre il codice di un modello multimodale 30B: 3 miliardi di parametri attivi, sfida diretta a GPT-5-Mini
3 miliardi di parametri attivi per prestazioni multimodali vicine a quelle di un flagship.