
NVIDIA의 4,999달러 DGX Spark 64GB, 상시 구동 에이전트를 위해 책상 위에 페타플롭을 올리다
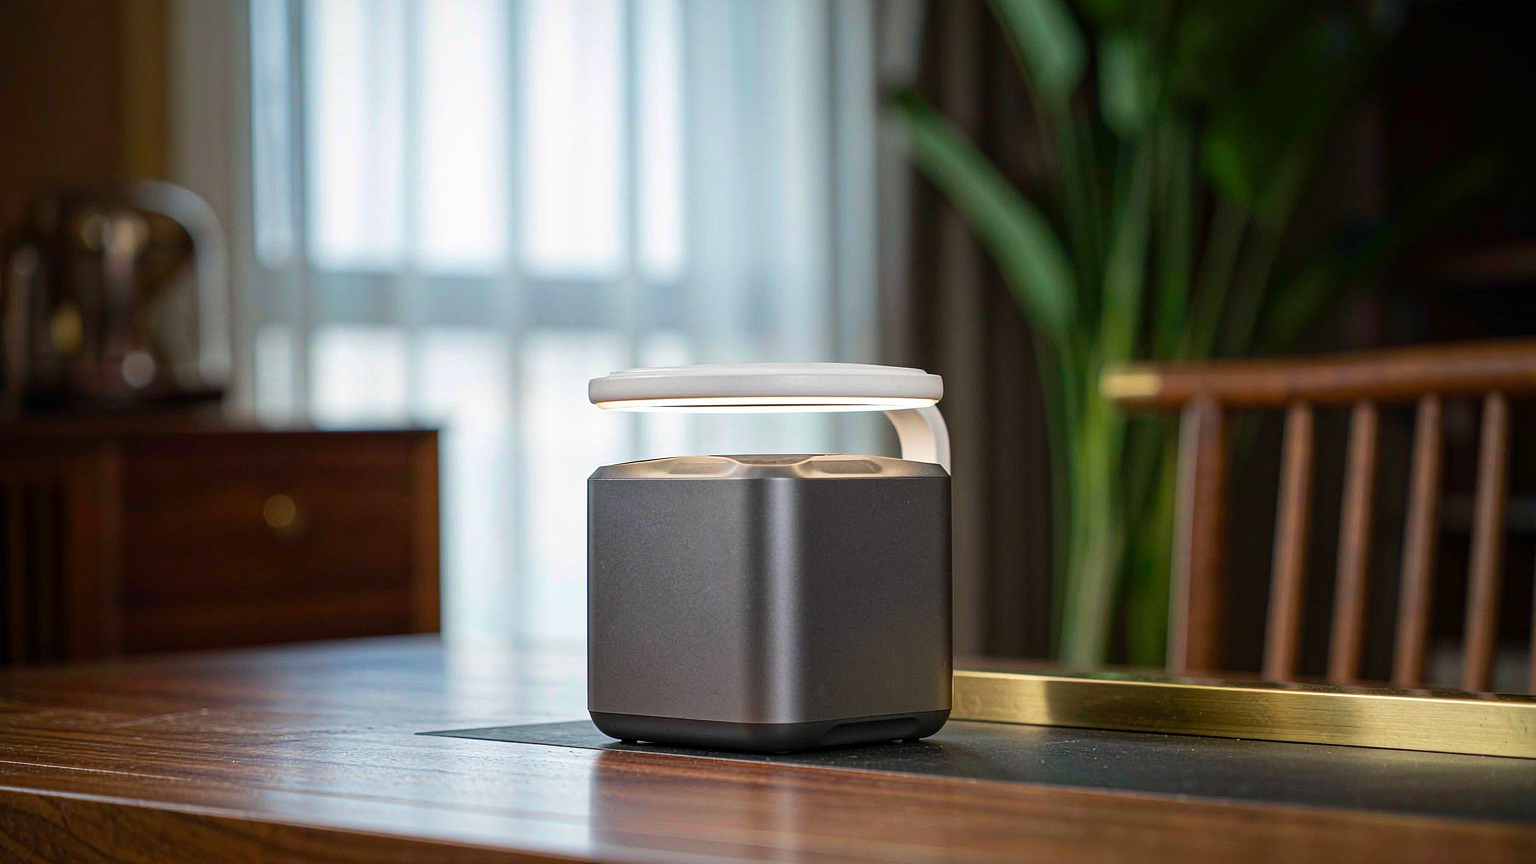
NVIDIA가 자사의 데스크톱 AI 컴퓨터인 DGX Spark의 64GB 버전을 확정했다. 가격은 4,999달러부터 시작하며 10월 23일 Acer, Asus, Dell, Gigabyte, HP, MSI, H3C를 통해 출시된다. 128GB 모델은 6,950달러에 계속 판매된다. 두 모델 모두 GB10 Grace Blackwell 슈퍼칩 기반으로, Blackwell GPU와 20코어 Arm CPU를 하나의 패키지에 결합하고 둘 사이에 단일 LPDDR5X 메모리 풀을 공유한다.
아키텍처가 핵심 판매 포인트다. 일관성 있는 통합 메모리는 CPU와 GPU가 동일한 주소 공간을 보게 해주므로 시스템 RAM과 VRAM 사이에서 데이터를 복사할 필요가 없다. 64GB 박스에서는 약 8GB가 운영체제로 가고, 약 56GB가 모델 가중치와 컨텍스트 길이에 따라 커지는 KV 캐시를 위해 남는다. NVIDIA는 이 칩의 AI 연산 성능을 FP4 형식 기준 최대 1페타플롭으로 평가한다.
64GB로 실제로 실행할 수 있는 것
NVIDIA는 64GB 구성을 30B~35B급 모델, 즉 Qwen3.8-27B, Gemma 4 26B, Meta Muse Glimmer, Nemotron 3.5 Lightning에 맞춰 포지셔닝한다. NVIDIA에 따르면 정확도를 유지하는 NVFP4 양자화를 사용하면 한 대의 박스로 최대 약 100B 파라미터 모델까지 처리할 수 있다. 이것이 이 머신의 존재 이유다. 1년 전만 해도 그 수준의 모델은 서버 랙이 필요했다. 이제는 큰 도시락 크기의 박스에 들어간다.
트레이드오프는 메모리 대역폭이다. 273GB/s에서 Spark는 100명의 동시 사용자에게 채팅 제품을 제공하도록 만들어진 것이 아니다. 긴 입력과 짧은 출력, 즉 저장소나 로그 덤프, 문서 더미를 읽고 짧은 결과를 쓰는 데 적합하다. 이러한 형태는 에이전트와 잘 맞는데, 에이전트는 대부분의 시간을 컨텍스트를 읽는 데 보내고 가끔씩만 답을 생성하기 때문이다.
이 박스의 계보
Spark는 NVIDIA가 책상 아래에 본격적인 컴퓨팅 성능을 두려 한 첫 시도가 아니다. 128GB 버전은 이미 더 높은 가격에 존재했고, 64GB 모델은 의도적으로 더 낮은 시장을 겨냥한 움직임이다. 동일한 GB10 칩과 동일한 통합 메모리 설계를 유지하면서 메모리를 절반으로 줄여, 머신의 용도는 바꾸지 않고 진입 비용을 낮춘다. 이는 중요한데, 이전 모델은 워크스테이션 가격으로 책정되었고 워크스테이션 가격은 구매할 수 있는 사람을 제한하기 때문이다.
64GB 구성이 1년 전이 아니라 지금 타당한 두 번째 이유가 있다. 56GB에 들어가는 오픈 모델들이 실행할 가치가 있을 만큼 좋아졌다. 양자화된 가중치와 긴 컨텍스트 창을 갖춘 27B 모델은 장난감 같은 프롬프트가 아니라 실제 코딩 및 리서치 작업을 처리할 수 있다. 6개월 전만 해도 동등한 역량을 로컬에서 실행하려면 더 큰 박스와 더 큰 비용이 필요했다. 하드웨어와 모델이 같은 임계점에 도달했고, 그것이 이번 가격 인하를 장식이 아니라 의미 있게 만든다.
클러스터링은 일급 기능이다
모든 DGX Spark에는 최대 200GbE로 동작하는 ConnectX-7 네트워크 카드가 함께 제공되며, 무료 NVIDIA Sync 앱이 설정을 처리한다. 이 앱의 Cluster Assistant가 네트워킹을 구성하므로 네트워크 관리자가 아니어도 최대 4대를 연결할 수 있다. 64GB Spark 두 대를 묶으면 128GB가 되며, NVIDIA는 이 조합이 단일 128GB 모델보다 최대 1.7배 성능을 낸다고 말한다. 결합된 컴퓨팅 성능과 대역폭이 대략 두 배가 되기 때문이다. 한 쌍은 직접 케이블로 연결하고, 4대는 스위치가 필요하다.
실용적인 효과는 탄력적인 확장이다. 실험용으로 한 대로 시작하고, 실제 워크로드가 생기면 두 번째를 추가하고, 워크로드가 로컬 하드웨어를 넘어설 때까지 계속 늘릴 수 있다. 확장할 때 첫 토큰까지 걸리는 시간이 가장 크게 개선되는데, 이는 긴 입력을 읽은 뒤 행동하는 에이전트에 중요하다.
에이전트 이야기는 소프트웨어 계층에 있다
Spark에는 DGX OS, CUDA 스택, 그리고 일반적인 도구인 PyTorch, Jupyter, Ollama가 함께 제공되며 vLLM과 llama.cpp를 위한 튜닝된 지원도 포함된다. NVIDIA는 자사 최적화로 로컬 에이전트 추론이 최대 1.9배 빨라진다고 주장한다. 또한 NVIDIA Agent Toolkit의 일부인 OpenShell을 번들로 제공하는데, 이는 에이전트가 할 수 있는 일에 정책 기반 경계를 설정한다.
마지막 요소는 더 넓은 트렌드와 연결된다. 에이전트가 데모에서 일상 사용으로 이동하면서 병목은 모델이 아니라 신뢰성이 된다. 밤새 에이전트를 실행하는 로컬 머신은 도구 호출을 올바르게 수행하고, 실패에서 복구하며, 범위를 벗어나지 않아야 한다. NVIDIA는 바로 이 점을 강조한다. Spark는 일회성 프롬프트가 아니라 상시 구동 에이전트를 겨냥한다.
Perplexity는 이미 이 하드웨어에 적응해, 기기에서 로컬로 118B 모델을 실행할 수 있는 최적화된 휴대용 컴퓨터 에이전트를 출시했다. 이는 주목할 만한 신호인데, Perplexity는 클라우드 우선 기업이기 때문이다. 로컬 하드웨어를 위해 제품을 만들고 있다면, 모델을 자신의 머신에서 실행하기를 원하는 사용자 시장이 있다고 보는 것이다.
누구를 위한 것인가, 그리고 누구를 위한 것이 아닌가
4,999달러라는 가격은 Spark를 소비자용이 아니라 전문가 영역에 둔다. 혜택을 보는 사람은 에이전트를 충분히 자주 실행해 토큰당 API 요금이 쌓이는 연구자, 독립 개발자, 소규모 팀이거나 자체 하드웨어를 떠날 수 없는 데이터를 다루는 사람들이다. 비공개 저장소에서 코딩 모델을 파인튜닝하거나, 새 오픈 모델에 대한 출시 첫날 평가를 실행하거나, 여러 모델을 동시에 상주시키는 일은 모두 통합 메모리 설계에 맞는 작업이다.
그 외의 사람들에게는 계산이 덜 명확하다. 하루에 AI를 몇 번 사용한다면 클라우드 API가 더 저렴하고 간단하다. Spark는 사용량이 많거나, 데이터가 민감하거나, 워크로드가 지속적으로 실행될 때 타당하다. 64GB 모델은 진입 가격을 낮추지만 그 논리를 바꾸지는 않는다.
예산을 계획하는 사람이라면 한 가지 세부 사항을 짚어둘 가치가 있다. 사용 가능한 56GB 메모리는 가중치와 KV 캐시를 함께 감당해야 한다. 긴 컨텍스트는 캐시를 잡아먹고, 에이전트 워크로드는 본질적으로 길다. 기술적으로 들어가더라도 양자화된 모델은 컨텍스트가 커지면 한계에 부딪힐 수 있다. NVIDIA가 더 큰 모델의 55GB 전체 정밀도 버전보다 17GB 양자화 빌드를 실용적인 선택으로 가리키는 이유다. 모델을 맞추는 것과 긴 작업에서 잘 실행하는 것은 서로 다른 시험이다.
더 큰 신호
이번 출시에서 흥미로운 부분은 가격 인하가 아니다. 27B나 30B 모델이 데스크톱에서 실행되는 것이 이제 몇 달 전의 최전선 동작에 충분히 가까워져, 이 머신을 중심으로 제품을 만들 가치가 있다는 점이다. 하드웨어와 오픈 모델이 같은 지점에서 수렴했다. 책상 아래의 박스가 당신이 잠든 동안에도 작동하는 에이전트를 실행하고, 데이터는 건물 밖으로 나가지 않는다.
NVIDIA는 충분히 많은 개발자가 이를 원해 제품 라인을 정당화할 것이라고 베팅한다. Spark를 출시하는 OEM 목록은 답이 '그렇다'라고 생각하며, 향후 몇 년간의 AI 작업이 모두 데이터 센터에서 일어나지는 않을 것이라고 보는 듯하다.
관련 글
Agility Digit 5, 단순한 스펙 시트가 아닌 안전성 입증 자료와 함께 출시되다
창고 현장은 실험실이 아니다. 관문은 인증이지 데모가 아니다.
프론티어 에이전트가 연구 워크플로의 30퍼센트를 완료했다. 그 숫자가 핵심이다.
에이전트는 연구를 운영할 수 있다. 절차를 새로 고안하는 일은 아직 요원하다.
Figure AI, 판매할 제품도 없이 35억 달러어치 컴퓨팅을 확보하다
베팅의 핵심은 일반화가 컴퓨팅 문제라는 것이다. 업계는 아직 결론을 내리지 못했다.
OpenAI, 마침내 이미지 API에 투명 배경 추가
파이프라인에서 한 단계를 통째로 없애는 작은 기능.