
DGX Spark 64GB da NVIDIA, por US$ 4.999, coloca um petaflop na mesa para agentes sempre ativos
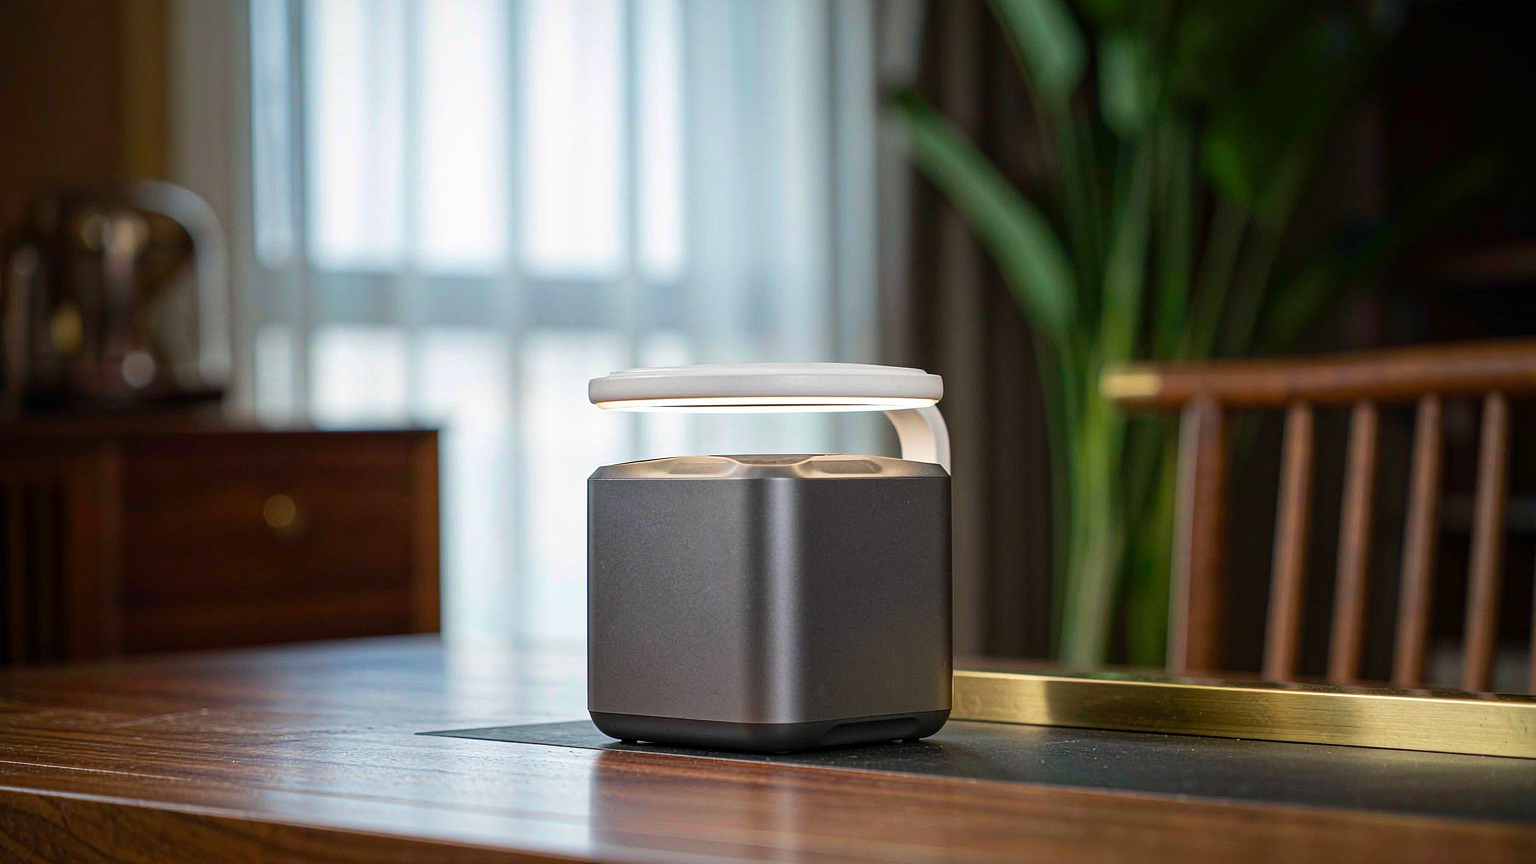
A NVIDIA confirmou uma versão de 64 GB do seu computador de desktop para IA DGX Spark, com preço a partir de US$ 4.999 e envio em 23 de outubro por meio da Acer, Asus, Dell, Gigabyte, HP, MSI e H3C. O modelo de 128 GB continua à venda por US$ 6.950. Ambos são baseados no superchip GB10 Grace Blackwell, que combina uma GPU Blackwell com uma CPU Arm de 20 núcleos em um único encapsulamento e compartilha um único pool de memória LPDDR5X entre eles.
A arquitetura é o principal atrativo. A memória unificada coerente significa que a CPU e a GPU enxergam o mesmo espaço de endereçamento, então você deixa de copiar dados entre a RAM do sistema e a VRAM. Em uma máquina de 64 GB, cerca de 8 GB vão para o sistema operacional, deixando aproximadamente 56 GB para os pesos do modelo e o cache KV, que cresce com o comprimento do contexto. A NVIDIA classifica o chip em até um petaflop de computação de IA no formato FP4.
O que 64 GB realmente executa
A NVIDIA posiciona a configuração de 64 GB para modelos na classe de 30B a 35B: Qwen3.8-27B, Gemma 4 26B, Meta Muse Glimmer e Nemotron 3.5 Lightning. Com a quantização NVFP4, que, segundo a NVIDIA, preserva a precisão, uma máquina consegue lidar com modelos de até aproximadamente 100B parâmetros. É exatamente esse o propósito da máquina. Um ano atrás, modelos nesse nível precisavam de um rack de servidor. Agora eles cabem em uma caixa do tamanho de uma marmita grande.
O trade-off é a largura de banda de memória. Com 273 GB/s, o Spark não foi feito para atender um produto de chat para cem usuários simultâneos. Ele foi feito para entradas longas e saídas curtas: ler um repositório, um despejo de logs ou uma pilha de documentos e escrever um resultado curto. Esse formato se encaixa bem em agentes, porque um agente passa a maior parte do tempo lendo contexto e só ocasionalmente produz uma resposta.
A linhagem por trás da máquina
O Spark não é a primeira tentativa da NVIDIA de colocar computação séria debaixo de uma mesa. A versão de 128 GB já existia com um preço mais alto, e o modelo de 64 GB é um movimento deliberado para o mercado de entrada. Manter o mesmo chip GB10 e o mesmo design de memória unificada enquanto se corta a memória pela metade reduz o custo de entrada sem mudar para que a máquina serve. Isso importa porque o modelo anterior tinha preço de workstation, e um preço de workstation limita quem pode comprar um.
Há um segundo motivo para a configuração de 64 GB fazer sentido agora, e não um ano atrás. Os modelos abertos que cabem em 56 GB são bons o suficiente para valer a pena executar. Um modelo de 27B com pesos quantizados e uma janela de contexto longa consegue lidar com tarefas reais de programação e pesquisa, em vez de prompts de brinquedo. Seis meses atrás, executar a capacidade equivalente localmente significava uma máquina maior e uma conta maior. O hardware e os modelos chegaram ao mesmo limiar, e é isso que torna o corte de preço significativo, e não decorativo.
Clustering é um recurso de primeira classe
Cada DGX Spark vem com uma placa de rede ConnectX-7 operando a até 200GbE, e o aplicativo gratuito NVIDIA Sync cuida da configuração. Seu Cluster Assistant configura a rede para que você possa unir até quatro unidades sem ser um administrador de rede. Dois Sparks de 64 GB somam 128 GB, e a NVIDIA diz que esse par entrega até 1,7 vezes o desempenho de um único modelo de 128 GB, porque a computação e a largura de banda combinadas são aproximadamente dobradas. Um cabo direto conecta um par; quatro unidades precisam de um switch.
O efeito prático é uma escala móvel. Comece com uma máquina para experimentar, adicione uma segunda para uma carga de trabalho real e continue até que a carga supere o hardware local. O tempo até o primeiro token melhora mais quando você escala, e é isso que importa para agentes que leem entradas longas antes de agir.
A camada de software é onde vive a história dos agentes
O Spark vem com DGX OS, a pilha CUDA e as ferramentas de sempre: PyTorch, Jupyter, Ollama, além de suporte ajustado para vLLM e llama.cpp. A NVIDIA afirma que suas otimizações tornam a inferência local de agentes até 1,9 vezes mais rápida. Ele também inclui o OpenShell, parte do NVIDIA Agent Toolkit, que define limites baseados em políticas para o que um agente pode fazer.
Essa última peça se conecta a uma tendência mais ampla. À medida que os agentes passam da demonstração para o uso diário, o gargalo deixa de ser o modelo e passa a ser a confiabilidade. Uma máquina local que executa um agente durante a noite precisa fazer chamadas de ferramentas corretamente, recuperar-se de falhas e não sair do seu escopo. A NVIDIA está apostando exatamente nisso: o Spark é voltado para agentes sempre ativos, não para prompts pontuais.
A Perplexity já se adaptou ao hardware, lançando um agente de computador portátil otimizado que consegue executar um modelo de 118B localmente no dispositivo. Esse é um sinal notável, porque a Perplexity é uma empresa que prioriza a nuvem. Se ela está desenvolvendo para hardware local, espera um mercado de usuários que querem o modelo na própria máquina.
Para quem é isso, e para quem não é
O preço de US$ 4.999 coloca o Spark em território profissional, não de consumidor. As pessoas que se beneficiam são pesquisadores, desenvolvedores independentes e pequenas equipes que executam agentes com frequência suficiente para que as taxas de API por token se acumulem, ou que trabalham com dados que não podem sair do próprio hardware. Fazer ajuste fino de um modelo de programação em um repositório privado, fazer uma avaliação no primeiro dia de um novo modelo aberto ou manter vários modelos residentes ao mesmo tempo são tarefas que se encaixam no design de memória unificada.
Para todo o resto, o cálculo é menos claro. Se você usa IA algumas vezes por dia, as APIs de nuvem são mais baratas e mais simples. O Spark faz sentido quando seu uso é intenso, seus dados são sensíveis ou sua carga de trabalho roda continuamente. O modelo de 64 GB reduz o preço de entrada, mas não muda essa lógica.
Um detalhe vale a pena destacar para quem está planejando o orçamento. Os 56 GB de memória utilizável precisam cobrir os pesos e o cache KV juntos. Contexto longo consome cache, e cargas de trabalho de agentes são longas por natureza. Um modelo quantizado que tecnicamente cabe ainda pode bater no limite quando o contexto cresce, e é por isso que a NVIDIA aponta a versão quantizada de 17 GB de um modelo maior como a escolha prática em vez de sua versão de precisão total de 55 GB. Caber um modelo e executá-lo bem em uma tarefa longa são dois testes diferentes.
O sinal maior
A parte interessante deste lançamento não é o corte de preço. É que um modelo de 27B ou 30B rodando em um desktop agora está próximo o suficiente do comportamento de fronteira de alguns meses atrás para que valha a pena construir um produto em torno da máquina. O hardware e os modelos abertos convergiram no mesmo ponto: uma caixa embaixo de uma mesa, executando um agente que trabalha enquanto você dorme, com os dados nunca saindo do prédio.
A NVIDIA está apostando que desenvolvedores suficientes querem isso a ponto de justificar uma linha de produtos. A lista de OEMs que enviarão o Spark sugere que ela acha que a resposta é sim, e que os próximos anos de trabalho em IA não acontecerão todos em um data center.
Artigos relacionados
Agentes de fronteira concluíram 30% de um workflow de pesquisa. Esse é o número.
Agentes conseguem executar pesquisa. Inventar o procedimento ainda está fora de alcance.
Figure AI garantiu US$ 3,5 bilhões em capacidade de computação antes mesmo de ter um produto para vender
A aposta é que a generalização é um problema de computação. O setor ainda não decidiu isso.
OpenAI finalmente coloca fundos transparentes na API de imagens
Um recurso pequeno que elimina uma etapa inteira do pipeline.
Dolphin AI transforma um roteiro em vídeo de vários planos sem perder o figurino
A continuidade entre cortes é a parte em que a maioria dos modelos de vídeo ainda falha.