
NVIDIA 的 4,999 美元 DGX Spark 64GB 把 Petaflop 級算力帶上桌面,為常駐 AI 代理而生
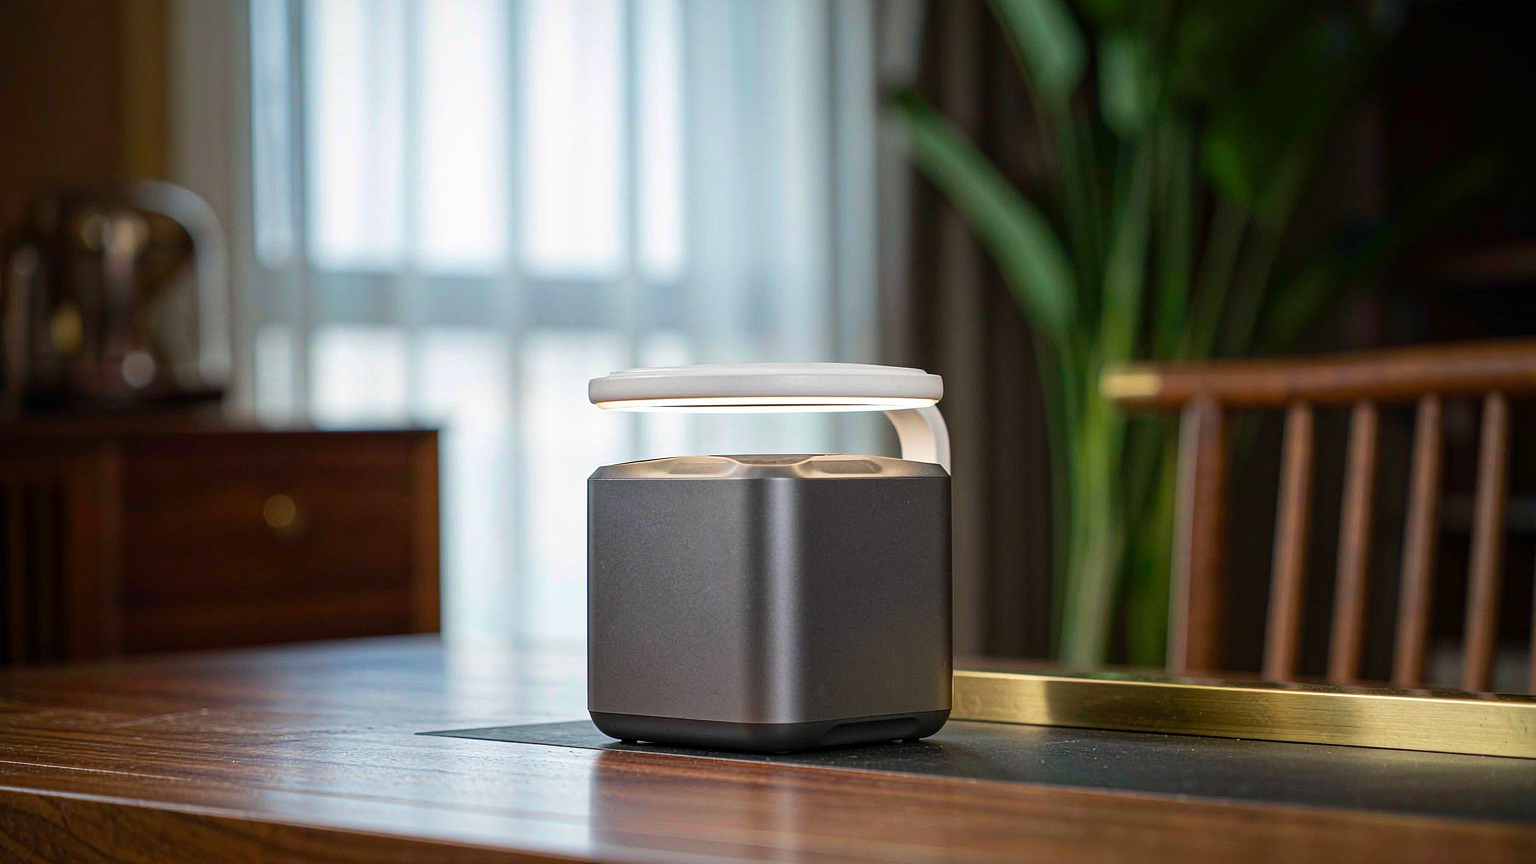
NVIDIA 已確認推出 DGX Spark 桌上型 AI 電腦的 64GB 版本,售價自 4,999 美元起,並將於 10 月 23 日透過宏碁、華碩、戴爾、技嘉、HP、微星與 H3C 出貨。128GB 機型仍以 6,950 美元持續販售。兩者皆採用 GB10 Grace Blackwell 超級晶片,將 Blackwell GPU 與 20 核心 Arm CPU 封裝在一起,並讓兩者共用單一 LPDDR5X 記憶體池。
其架構正是賣點。一致性統一記憶體意味著 CPU 與 GPU 看到相同的位址空間,因此不必再於系統 RAM 與 VRAM 之間複製資料。在 64GB 機型上,約 8GB 用於作業系統,剩下約 56GB 可供模型權重,以及會隨上下文長度增長的 KV 快取使用。NVIDIA 將該晶片在 FP4 格式下的 AI 運算效能標示為最高 1 Petaflop。
64GB 實際能跑什麼
NVIDIA 將 64GB 配置定位於 30B 至 35B 級別的模型:Qwen3.8-27B、Gemma 4 26B、Meta Muse Glimmer 與 Nemotron 3.5 Lightning。透過 NVFP4 量化,NVIDIA 表示能維持準確度,單一機器可處理最高約 100B 參數的模型。這正是這台機器的重點。一年前,這種等級的模型還需要伺服器機櫃。如今它們能放進一個大型便當盒大小的盒子裡。
取捨在於記憶體頻寬。Spark 的頻寬為 273GB/s,並非為了同時服務上百位使用者的聊天產品而打造。它是為了長輸入、短輸出而生:讀取一個程式碼儲存庫、一份日誌傾印或一疊文件,然後寫出簡短的結果。這種型態非常適合代理,因為代理大部分時間都在讀取上下文,只偶爾產出答案。
這台機器背後的傳承
Spark 並非 NVIDIA 首次嘗試把嚴肅運算放到辦公桌下。128GB 版本早已以更高價格存在,而 64GB 機型是刻意向下市場推進。保留相同的 GB10 晶片與相同的統一記憶體設計,同時把記憶體減半,能在不改變機器用途的前提下降低入門成本。這點很重要,因為先前的機型是以工作站等級定價,而工作站價格會限制購買族群。
64GB 配置之所以在現在而非一年前變得合理,還有第二個原因。能放進 56GB 的開源模型已經好到值得實際運行。一個 27B 模型搭配量化權重與長上下文視窗,可以處理真正的程式開發與研究任務,而不只是玩具提示。六個月前,若要在本機運行同等能力,得靠更大的機器與更高的帳單。硬體與模型同時抵達同一個門檻,這正是這次降價具有實質意義、而非只是裝飾的原因。
叢集是一級功能
每一台 DGX Spark 都隨附一張最高可跑 200GbE 的 ConnectX-7 網路卡,並由免費的 NVIDIA Sync 應用程式負責設定。其 Cluster Assistant 會配置網路,讓你最多串接四台裝置,而不必成為網路管理員。兩台 64GB Spark 可合併為 128GB,NVIDIA 表示這對組合能帶來最高達單台 128GB 機型 1.7 倍的效能,因為合併後的運算與頻寬大致翻倍。一對裝置可用直接線材連接;四台則需要一台交換器。
其實際效果是可擴充的規模。先從一台機器開始實驗,為實際工作負載再加一台,持續擴充直到工作負載超出本機硬體能力。擴充時,首個 Token 的產生時間改善最明顯,這對會先讀取長輸入再採取行動的代理來說至關重要。
軟體層才是代理故事的所在
Spark 隨附 DGX OS、CUDA 堆疊,以及常見工具:PyTorch、Jupyter、Ollama,並針對 vLLM 與 llama.cpp 提供調校支援。NVIDIA 宣稱其最佳化可讓本機代理推論最高快上 1.9 倍。它也內建 OpenShell,這是 NVIDIA Agent Toolkit 的一部分,可為代理能做的事設定以政策為基礎的界線。
最後這點與更大的趨勢相連。隨著代理從展示走向日常使用,瓶頸不再是模型,而是可靠性。一台在本機整夜運行代理的機器,必須正確發出工具呼叫、從失敗中復原,並且不會偏離其範圍。NVIDIA 正是押注於此:Spark 瞄準的是常駐代理,而非一次性的提示。
Perplexity 已經針對這款硬體進行調適,推出最佳化的可攜式電腦代理,能在裝置本機運行 118B 模型。這是個值得注意的訊號,因為 Perplexity 是一家雲端優先的公司。如果它正在為本機硬體打造產品,就代表它預期有一群想把模型放在自己機器上的使用者市場。
適合誰,又不適合誰
4,999 美元的價格讓 Spark 落在專業領域,而非消費市場。受益者是研究人員、獨立開發者與小型團隊,他們運行代理的頻率高到按 Token 計費的 API 費用會累積起來,或者他們處理的資料不能離開自己的硬體。在私有程式碼儲存庫上微調程式開發模型、對新開源模型進行首日評估,或同時常駐多個模型,都屬於適合統一記憶體設計的工作。
對其他人來說,這筆帳就沒那麼清楚了。如果你一天只用幾次 AI,雲端 API 更便宜也更簡單。當你的使用量很高、資料敏感,或工作負載持續運行時,Spark 才說得通。64GB 機型降低了入門價格,但並未改變這套邏輯。
有一個細節值得提醒任何在做預算的人。56GB 的可用記憶體必須同時容納權重與 KV 快取。長上下文會吃掉快取,而代理工作負載本質上就是長上下文。一個技術上塞得下的量化模型,仍可能在上下文增長後撞牆,這正是為什麼 NVIDIA 會指出,較大模型的 17GB 量化版本,比其 55GB 全精度版本更實用。能塞進模型,與能在長任務中跑得好,是兩項不同的測試。
更大的訊號
這次發布有趣的部分不是降價。而是 27B 或 30B 模型在桌面上運行,如今已足夠接近幾個月前的前沿表現,讓這台機器值得圍繞它打造產品。硬體與開源模型已在同一點上交會:一個放在桌下的盒子,運行著在你睡覺時工作的代理,而資料從不離開這棟建築。
NVIDIA 押注有足夠的開發者想要這件事,足以支撐一條產品線。出貨 Spark 的 OEM 名單顯示,它認為答案是肯定的,也認為未來幾年的 AI 工作不會全都發生在資料中心裡。