
六千筆中文參考資料,被做成「選人、選衣、選姿勢」三張牌
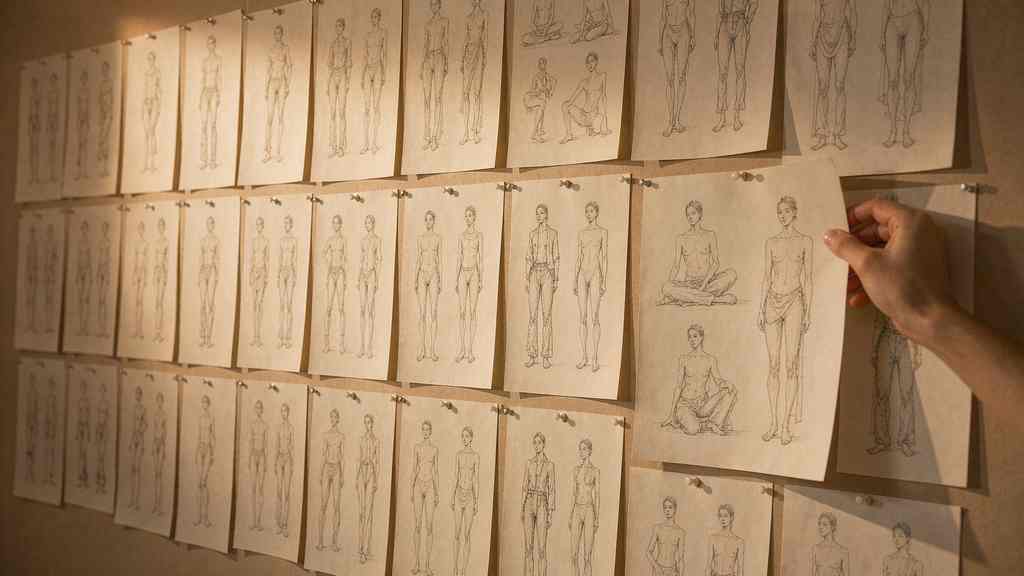
先說結論:這個倉庫會紅,不是因為它圖多。圖多這件事,雲端硬碟裡到處都是。它會紅,是因為它把「挑一張參考圖」拆成三個可以各自替換的零件——人、衣服、姿勢——然後讓你把這三樣拼成一份配方,直接丟給模型。
專案叫 ai-pose-gallery-zh,作者是 Anhao。README 第一段就把帳算得很清楚:1439 張素體白模,搭配 1439 張深度圖;服裝 3224 套;人像 1499 位;合計 6162 筆中文參考資料,本機高解析圖 12022 張,另外還有 1760 張來自來源網站的參考圖。資料不是它自己拍的,而是鏡像了三位作者公開的圖庫——姿勢與服裝的原站作者是 ギア(@giaaibusi),440 套二次元服裝來自 たき AI 的 CharaDB。它做的事是翻譯、合併,再加上一層工具。
真正被解決的是檢索,不是畫質
用過參考圖庫的人都知道卡在哪裡。你想讓模特兒靠牆、手插口袋、身體斜四十五度,腦子裡有畫面,但翻圖庫只能一頁一頁看縮圖,翻個二十頁才找到一張七成相似的,還得自己描述。原站的中繼資料是日文,動作分類、髮型細分、服裝款式全是日文標籤,中文使用者要嘛看不懂,要嘛看懂了也拼不出提示詞。
這個倉庫把 6162 筆中繼資料全譯成中文,而且拆到可以自動組裝的粒度——髮長、51 種細分髮型、姿勢分類、穿搭標籤。它宣稱拼出來的提示詞「純淨無日文干擾」。這句話聽起來像行銷話術,但對生圖來說確實是個真問題:提示詞混了兩種語言,模型的穩定性會掉。
三合一是關鍵,不是功能列表長
它的 Web Studio 讓你從三個庫各挑一個:一個人像、一套衣服、一個姿勢。素體白模和深度圖可以一鍵切換。選完之後還能拖曳、貼上,或輸入網址加入自己的參考圖。配方會存進 IndexedDB,關掉瀏覽器再打開還在。這套互動不算新鮮,新鮮的是它把「參考圖」從單張圖片變成結構化輸入。
然後是那五路直連:Google Gemini、OpenAI GPT Image、阿里雲百鍊的 Qwen、火山方舟的 Doubao、本機 ComfyUI。前四個填 key 就能跑,第五個需要你的機器上有顯卡。它沒有自己做模型,也沒打算做——它賭的是「同一份配方,換模型重跑」會變成常規操作。
ComfyUI 外掛是更實用的一半
專案本身就是一個 ComfyUI 外掛,git clone 到 custom_nodes/ 就能用,四個節點:姿勢、服裝、人像、三合一配方。姿勢和配方節點內建 use_depth 開關,可以直接接 ControlNet Depth。這個設計很懂人:白模給你結構,深度圖給你空間關係,出圖時哪張更管用,取決於你要的是姿態準確還是透視準確。
我更喜歡的是它把 6162 筆資料做成一個視覺化的彈窗選圖器。在 ComfyUI 畫布上點開、選好、回來連線。這比在資料夾裡翻圖再拖進節點,省下的不只是零碎時間。
三個必須說清楚的邊界
第一,素材版權不在它手上。姿勢、服裝、人像的圖來自原作者公開網站,專案只做中文整理與工程存檔,README 裡明確寫了「禁止打包轉售」。你要商用,得回頭去看原作者的授權。
第二,圖庫包含 18+ 的人體素體與內衣參考,預設開啟 SFW 安全模式。這不是小事,作者把它寫在免責聲明的第一條後面,而不是藏在小字裡。
第三,也是最要緊的:它反覆強調禁止未經授權的真人換臉。這份謹慎是有原因的——一個把「人像+服裝+姿勢」三件套拆得這麼乾淨的庫,天生就是換臉流水線的上游。工具中性,用法不中性。
為什麼這類專案會持續出現
過去一年,生圖的門檻從「會不會寫提示詞」下移到「有沒有好參考」。模型這邊的變化也在配合:Seedream 5.5 這類新模型開始原生輸出帶透明通道的分層素材,GPT Image 2.6 把局部標記編輯下放到 API,都在減少「生成之後再修」的返工。當生成變便宜、變穩定,稀缺的就變成輸入端的組織能力。
6162 筆參考真正的意義在這裡。它不是圖庫,而是把「我想要那種感覺」翻譯成機器能執行的三段式座標。你可以說它只是把三份日文資料整理成中文,但「整理」這件事,恰恰是大多數人卡住的地方。
如果你只是想試試看,打開線上演示就能用,手機也行。如果你想把它接進生產流程,先想清楚兩件事:你的素材授權到哪一步,以及你打算把這套配方交給誰用。前者決定你能不能商用,後者決定你會不會在某個凌晨收到一封律師函。