
6,162건의 중국어 참고 데이터가 '사람·옷·포즈' 세 장의 카드가 되기까지
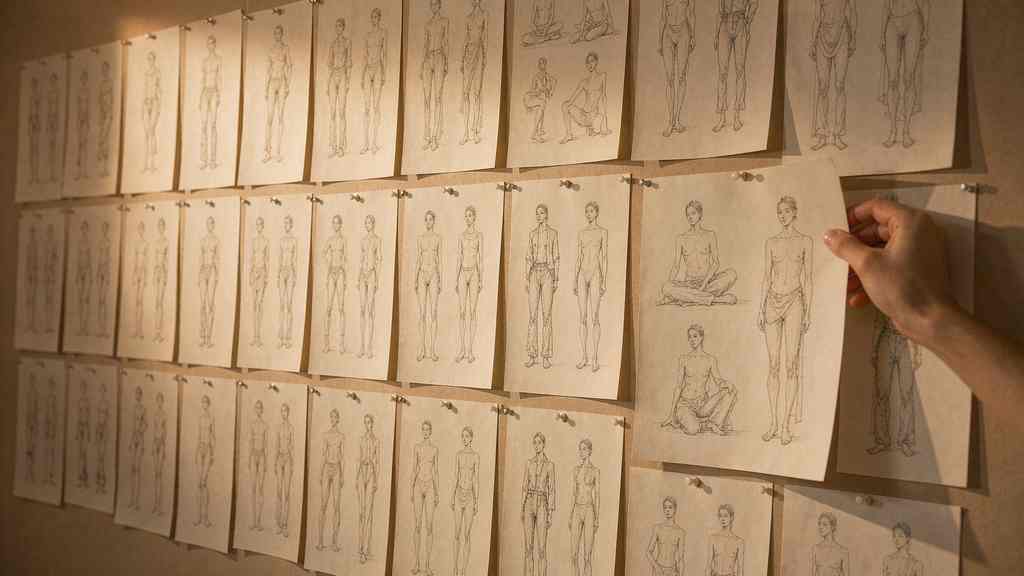
먼저 결론부터 말씀드리겠습니다. 이 저장소가 화제가 된 이유는 이미지가 많아서가 아닙니다. 이미지가 많은 건 클라우드 드라이브 어디에나 있습니다. 이 저장소가 주목받은 건 '참고 이미지 한 장 고르기'라는 작업을 사람, 옷, 포즈라는 서로 교체 가능한 세 부품으로 쪼개고, 이 셋을 하나의 레시피로 조립해 모델에 그대로 넘길 수 있게 했기 때문입니다.
저장소 이름은 ai-pose-gallery-zh이고, 만든 사람은 Anhao입니다. README 첫 문단부터 숫자를 아주 명확하게 정리해 두었습니다. 기본 체형 백모델 1,439장에 각각 대응하는 깊이 맵 1,439장, 의상 3,224벌, 인물 1,499명, 합계 6,162건의 중국어 참고 데이터입니다. 로컬 고화질 이미지는 12,022장이고, 별도로 원본 사이트에서 가져온 참고 이미지가 1,760장 있습니다. 데이터를 직접 촬영한 건 아니고, 세 작가가 공개한 이미지 라이브러리를 미러링한 것입니다. 포즈와 의상 원본 사이트의 운영자는 ギア(@giaaibusi)이고, 2차원 의상 440벌은 たき AI의 CharaDB에서 왔습니다. 이 저장소가 한 일은 번역하고, 합치고, 도구 층을 얹은 것입니다.
실제로 해결된 것은 검색이지, 화질이 아닙니다
참고 이미지 라이브러리를 써 본 분들은 그 막히는 지점을 아실 겁니다. 모델이 벽에 기대고, 손을 주머니에 넣고, 몸을 45도로 기울이길 원합니다. 머릿속에는 그림이 있는데, 라이브러리에서는 썸네일을 한 페이지씩 넘겨야 합니다. 스무 페이지를 넘겨 겨우 칠십 퍼센트쯤 비슷한 이미지를 찾아도, 설명은 직접 써야 합니다. 원본 사이트의 메타데이터는 일본어입니다. 동작 분류, 헤어스타일 세분화, 의상 스타일이 전부 일본어 태그라서 중국어 사용자는 읽지 못하거나, 읽어도 프롬프트로 조합하지 못합니다.
이 저장소는 6,162건의 메타데이터를 전부 중국어로 번역했고, 자동 조립이 가능한 수준까지 세분화했습니다. 머리 길이, 51가지 세부 헤어스타일, 포즈 분류, 코디 태그까지요. 조합된 프롬프트가 '일본어 간섭이 없는 깨끗한 상태'라고 주장합니다. 마케팅 문구처럼 들리지만, 이미지 생성에서는 실제로 문제가 됩니다. 두 언어가 섞인 프롬프트를 주면 모델의 안정성이 떨어지니까요.
핵심은 삼합일이지, 기능 목록의 길이가 아닙니다
웹 스튜디오에서는 세 개의 라이브러리에서 각각 하나씩 고릅니다. 인물 하나, 의상 한 벌, 포즈 하나입니다. 기본 백모델과 깊이 맵은 클릭 한 번으로 전환됩니다. 고른 뒤에는 드래그하거나, 붙여넣거나, URL을 입력해 직접 참고 이미지를 더할 수도 있습니다. 레시피는 IndexedDB에 저장되어 브라우저를 닫았다 열어도 남아 있습니다. 이 상호작용 자체는 새롭지 않습니다. 새로운 건 '참고 이미지'를 낱장 이미지에서 구조화된 입력으로 바꿔 놓았다는 점입니다.
다음은 다섯 갈래 직결입니다. Google Gemini, OpenAI GPT Image, Alibaba Cloud Bailian의 Qwen, Volcano Ark의 Doubao, 로컬 ComfyUI입니다. 앞의 네 개는 키만 넣으면 돌아가고, 다섯 번째는 GPU가 있는 머신이 필요합니다. 자체 모델을 만들지 않았고, 만들 생각도 없습니다. '같은 레시피를 다른 모델로 다시 돌린다'는 행위가 일상이 될 것이라는 데 걸고 있습니다.
ComfyUI 플러그인이 더 실용적인 절반입니다
저장소 자체가 ComfyUI 플러그인이라서 git clone으로 custom_nodes/에 넣으면 바로 쓸 수 있습니다. 노드는 네 개입니다. 포즈, 의상, 인물, 삼합일 레시피입니다. 포즈와 레시피 노드에는 use_depth 스위치가 내장되어 있어 ControlNet Depth에 바로 연결됩니다. 사람을 잘 아는 설계입니다. 백모델은 구조를, 깊이 맵은 공간 관계를 줍니다. 출력할 때 어느 쪽이 더 유용한지는 자세의 정확도가 필요한지, 원근의 정확도가 필요한지에 따라 달라집니다.
제가 더 마음에 든 건 6,162건의 데이터를 시각적 팝업 선택기로 만들었다는 점입니다. ComfyUI 캔버스에서 열고, 고르고, 돌아와서 연결하면 됩니다. 폴더에서 이미지를 찾아 노드로 끌어다 놓는 것과 비교하면 아끼는 시간이 한두 푼이 아닙니다.
반드시 짚어야 할 세 가지 경계
첫째, 소재의 저작권은 이 저장소에 없습니다. 포즈, 의상, 인물 이미지는 원작자가 공개한 사이트에서 왔고, 저장소는 중국어 정리와 엔지니어링 아카이브일 뿐입니다. README에는 '묶음으로 재판매하는 것을 금지한다'고 명시되어 있습니다. 상업적으로 쓰려면 원작자의 허가 조건을 다시 확인해야 합니다.
둘째, 라이브러리에 18+ 인체 백모델과 속옷 참고 자료가 포함되어 있어서 기본적으로 SFW 안전 모드가 켜져 있습니다. 작은 일이 아닙니다. 저자는 이 내용을 면책 조항 첫 번째 뒤에 적어 두었지, 작은 글씨로 숨기지 않았습니다.
셋째, 그리고 가장 중요한 부분입니다. 이 저장소는 허가 없는 실존 인물 얼굴 교체를 거듭 금지합니다. 이 신중함에는 이유가 있습니다. '인물 + 의상 + 포즈' 세트를 이렇게 깔끔하게 분해한 라이브러리는 구조적으로 얼굴 교체 파이프라인의 상류입니다. 도구는 중립적이지만, 쓰임새는 중립적이지 않습니다.
이런 프로젝트가 계속 나오는 이유
지난 1년 동안 이미지 생성의 문턱은 '프롬프트를 쓸 줄 아는가'에서 '좋은 참고 자료가 있는가'로 내려왔습니다. 모델 쪽 변화도 여기에 맞춰 움직입니다. Seedream 5.5 같은 새 모델은 투명 채널이 있는 레이어 소재를 기본으로 출력하기 시작했고, GPT Image 2.6은 부분 마킹 편집을 API까지 내려보냈습니다. 둘 다 '생성한 다음에 다시 고치는' 재작업을 줄이는 방향입니다. 생성이 싸지고 안정될수록 희소해지는 것은 입력을 조직하는 능력입니다.
6,162건의 참고 자료가 갖는 진짜 의미가 여기에 있습니다. 이건 이미지 라이브러리가 아니라, '저런 느낌이었으면 좋겠다'를 기계가 실행할 수 있는 3단 좌표로 번역하는 도구입니다. 그냥 일본어 자료 세 개를 중국어로 정리한 것뿐이라고 말할 수도 있습니다. 하지만 그 '정리'가 바로 대부분의 사람이 막히는 지점입니다.
그냥 한번 써 보고 싶다면 온라인 데모를 열면 됩니다. 휴대폰에서도 됩니다. 실제 운영에 붙이려면 두 가지를 먼저 정리해 두셔야 합니다. 소재 라이선스가 어디까지인지, 그리고 이 레시피를 누구에게 쓰게 할 것인지입니다. 전자는 상업적 이용 가능 여부를, 후자는 어느 새벽에 변호사 서신을 받을지를 결정합니다.