
6162 Referenzdaten, sortiert nach Person, Kleidung und Pose
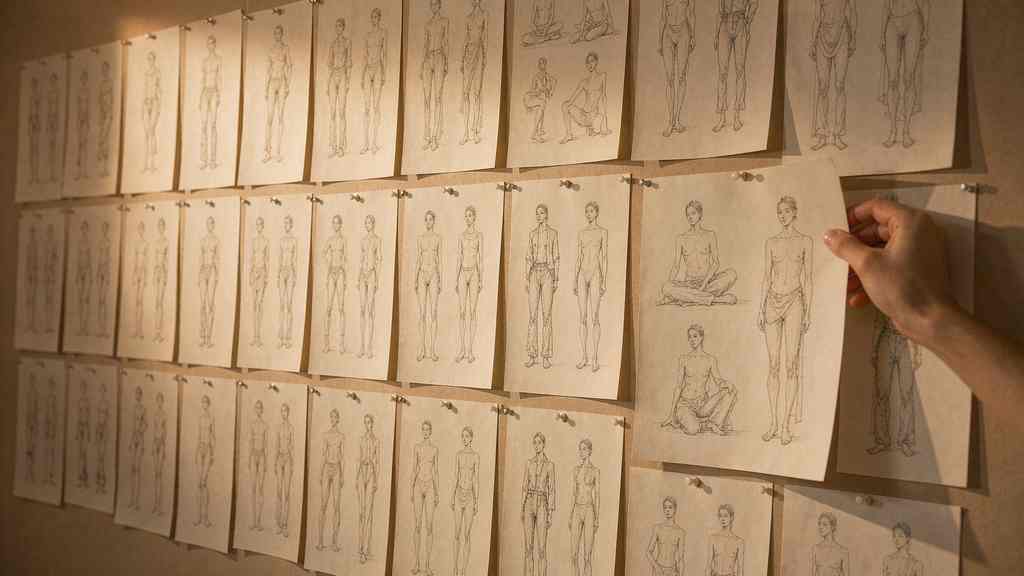
Zuerst das Ergebnis: Dieses Repository wurde nicht beliebt, weil es so viele Bilder enthält. Bilder in großen Mengen liegen in jedem Cloud-Ordner, und niemand öffnet deswegen ein weiteres. Es wurde beliebt, weil es die Aufgabe „eine Referenz auswählen“ in drei Teile zerlegt, die sich einzeln austauschen lassen – Person, Kleidung, Pose – und weil man diese drei Teile zu einem Rezept zusammenstecken und direkt an ein Modell schicken kann. Wer eine andere Pose will, tauscht die Pose. Wer eine andere Jacke will, tauscht die Jacke. Der Rest bleibt stehen.
Das Repository heißt ai-pose-gallery-zh, der Autor ist Anhao. Schon der erste Absatz der README rechnet sauber vor: 1439 weiße Grundkörper, dazu 1439 Tiefenkarten; 3224 Outfits; 1499 Porträts; in Summe 6162 chinesischsprachige Referenzdatensätze, 12022 lokale Bilder in hoher Auflösung und zusätzlich 1760 Referenzbilder von den Quellseiten. Die Daten sind nicht selbst fotografiert, sondern spiegeln die öffentlichen Galerien von drei Autorinnen und Autoren – die Originalseite für Posen und Kleidung stammt von ギア (@giaaibusi), die 440 Anime-Outfits kommen aus たき AIs CharaDB. Die eigentliche Leistung liegt also nicht im Fotografieren. Sie liegt im Übersetzen, im Zusammenführen und in einer Werkzeugschicht, die aus drei getrennten Archiven eine einzige Oberfläche macht.
Wirklich gelöst wird das Suchen, nicht die Bildqualität
Wer je mit Referenzbibliotheken gearbeitet hat, kennt den Engpass. Das Model soll an der Wand lehnen, die Hände in den Taschen, den Körper im 45-Grad-Winkel – das Bild ist im Kopf vollständig da, aber die Bibliothek zeigt nur Vorschaubilder, Seite um Seite. Nach zwanzig Seiten findet man etwas, das zu siebzig Prozent passt, und muss den Rest trotzdem selbst beschreiben, weil das Bild die Haltung nicht erklärt. Die Metadaten der Originalseite sind japanisch: Aktionskategorien, Frisur-Feinteilung, Schnittformen, alles japanische Tags. Chinesische Nutzer verstehen sie nicht, oder sie verstehen sie und können daraus trotzdem keinen Prompt bauen, weil zwischen dem Tag und dem Satz, den ein Modell lesen kann, noch ein Schritt fehlt.
Dieses Repository übersetzt alle 6162 Metadatensätze ins Chinesische und schneidet sie so fein, dass sie sich automatisch zusammensetzen lassen: Haarlänge, 51 Frisurvarianten, Posenskategorien, Outfit-Tags. Der zusammengesetzte Prompt sei, so die Behauptung, „frei von japanischen Störungen“. Das klingt nach Marketing, ist für die Bildgenerierung aber ein echtes Problem: Bei Prompts, die zwei Sprachen mischen, verliert das Modell an Stabilität. Ein Prompt, der zur Hälfte aus Tags besteht, die das Modell nur schwach kennt, ist kein Prompt, sondern eine Wette.
Die Drei-in-Eins-Kombination ist der Punkt, nicht die lange Funktionsliste
Im Web Studio wählt man aus drei Bibliotheken je ein Element: ein Porträt, ein Outfit, eine Pose. Zwischen weißem Grundkörper und Tiefenkarte lässt sich mit einem Klick umschalten, man sieht also sofort, ob das Modell die Silhouette oder die räumliche Anordnung zu sehen bekommt. Danach kann man eigene Referenzen per Drag-and-drop, Einfügen oder URL ergänzen. Das Rezept landet in IndexedDB und ist nach dem Schließen des Browsers noch da, was banal klingt und in der Praxis der Unterschied zwischen einem Spielzeug und einem Werkzeug ist.
Dazu kommen fünf direkte Anbindungen: Google Gemini, OpenAI GPT Image, Qwen über Alibaba Cloud Bailian, Doubao über Volcano Ark und ein lokales ComfyUI. Die ersten vier laufen, sobald ein Key eingetragen ist, die fünfte braucht eine Grafikkarte im Rechner. Ein eigenes Modell hat das Projekt nicht gebaut und will es auch nicht – die Wette lautet, dass „dasselbe Rezept, anderes Modell“ zur Routine wird und dass der Wert dann nicht im Generator liegt, sondern in der Zutat.
Das ComfyUI-Plugin ist die praktischere Hälfte
Das Repository ist selbst ein ComfyUI-Plugin: mit git clone nach custom_nodes/, und es läuft. Vier Nodes – Pose, Kleidung, Porträt, Drei-in-Eins-Rezept. Die Pose- und die Rezept-Node haben einen Schalter use_depth und lassen sich direkt an ControlNet Depth hängen. Das ist gut gedacht: Der weiße Grundkörper liefert die Struktur, die Tiefenkarte die räumlichen Verhältnisse. Welche der beiden beim Rendern mehr hilft, hängt davon ab, ob die Haltung oder die Perspektive stimmen muss – und das ist eine Entscheidung, die man pro Bild trifft und nicht pro Projekt.
Besser gefällt mir, dass die 6162 Datensätze als visueller Auswahldialog im Canvas liegen. Aufmachen, auswählen, zurückgehen, verbinden. Wer das schon einmal über den Dateimanager gemacht hat, weiß, wie viel Zeit zwischen Suchen, Ziehen und Neuverbinden verschwindet. Hier fällt der Umweg weg, und der Workflow bleibt an einer Stelle stehen. Für alle, die täglich mehrere Figuren in derselben Szene bauen, ist das der eigentliche Gewinn des ganzen Projekts.
Drei Grenzen, die klar benannt gehören
Erstens: Die Rechte am Material liegen nicht beim Autor. Posen, Outfits und Porträts stammen von den öffentlichen Seiten der ursprünglichen Urheber; das Repository ist chinesische Aufbereitung und technische Archivierung. In der README steht ausdrücklich, dass Paketierung und Weiterverkauf untersagt sind. Wer kommerziell arbeiten will, muss bei den Originalrechteinhabern nachfragen und nicht beim Mirror.
Zweitens: Die Bibliothek enthält 18+-Grundkörper und Unterwäsche-Referenzen. Der SFW-Modus ist standardmäßig aktiv. Das ist keine Kleinigkeit – der Hinweis steht direkt hinter dem ersten Punkt des Disclaimers und nicht in kleiner Schrift am Ende, was für die Ernsthaftigkeit des Autors spricht.
Drittens, und das ist der wichtigste Punkt: Das Projekt betont mehrfach, dass Face-Swaps mit realen Personen ohne deren Einwilligung untersagt sind. Diese Vorsicht hat einen Grund. Eine Bibliothek, die „Porträt plus Outfit plus Pose“ so sauber zerlegt, ist naturgemäß die vorgelagerte Stufe einer Face-Swap-Pipeline. Man muss dafür nichts Böses wollen; es reicht, dass die Bausteine sauber getrennt sind. Das Werkzeug ist neutral, die Verwendung nicht.
Warum solche Projekte immer wieder auftauchen
Im vergangenen Jahr ist die Hürde bei der Bildgenerierung von „kannst du Prompts schreiben“ zu „hast du brauchbare Referenzen“ gerutscht. Die Modelle ziehen mit: Neue Systeme wie Seedream 5.5 geben von sich aus Ebenen mit transparentem Kanal aus, GPT Image 2.6 legt Markierungs-Bearbeitung als API offen – beides verringert die Nacharbeit nach der Generierung. Wenn Erzeugen billig und stabil wird, wird die Organisation des Inputs zur knappen Ressource. Nicht die Frage, ob ein Modell ein Gesicht zeichnen kann, sondern ob es dieses Gesicht in dieser Jacke in dieser Haltung zeichnet.
Darin liegt die eigentliche Bedeutung der 6162 Datensätze. Es ist keine Bildbibliothek, sondern eine Übersetzung von „ich will diese Stimmung“ in drei Koordinaten, die eine Maschine ausführen kann. Man kann sagen, dass hier nur drei japanische Quellen ins Chinesische übertragen wurden – aber genau diese Aufbereitung ist der Punkt, an dem die meisten hängen bleiben. Die Bilder waren immer da. Der Weg dorthin war es nicht.
Wer nur testen will, öffnet die Online-Demo; das funktioniert auch am Telefon. Wer es in die Produktion nehmen will, sollte vorher zwei Dinge klären: wie weit die Lizenz des Materials reicht und wem man dieses Rezept in die Hand gibt. Das erste entscheidet über kommerzielle Nutzung, das zweite darüber, ob irgendwann um drei Uhr morgens ein Brief einer Kanzlei im Postfach liegt.
Verwandte Artikel
Eine community-gepflegte Tabelle von Taps, die Werbung in chinesischen Android-Builds abschaltet
Es fasst das System nicht an, entsperrt nichts, flasht nichts. Es legt nur die Schalter um, die die Hersteller ohnehin vorgesehen haben. Der Preis ist eine Liste, die jemand weiterführen muss.
GPT Image 2.6 hielt den Tokenpreis und erhöhte die Rechnung
GPT Image 2.6 übernimmt jeden Tokenpreis von 2.5 und kostet pro Bild dennoch mehr, weil ein größerer Teil der Arbeit in Ausgabe-Token landet. Elf Tage nach dem Start sagt die Preisstruktur mehr als jede Rangliste.
Jemand hat IDM von außen nachgebaut und aufgeschrieben, was er nicht angefasst hat
Eine Rust-Neuimplementierung von Internet Download Manager verspricht 5x Tempo und 86 Sprachen. Das interessantere Dokument ist der Absatz, der erklärt, wie sie ohne jede Kopie entstanden ist.
Rune ist ein Rust-UI-Framework, das gebaut wurde, damit ein Agent seine eigene Arbeit prüfen kann
Rune rendert headless, gibt seinen Elementbaum aus und nimmt geskriptete Eingaben an. Damit bekommt ein Coding-Agent ein Signal zum Diffen, das ein Screenshot nie liefert. Das Framework ist Pre-Release und nimmt keine Pull Requests an.