
Seis mil referências em chinês viraram três baralhos: gente, roupa e pose
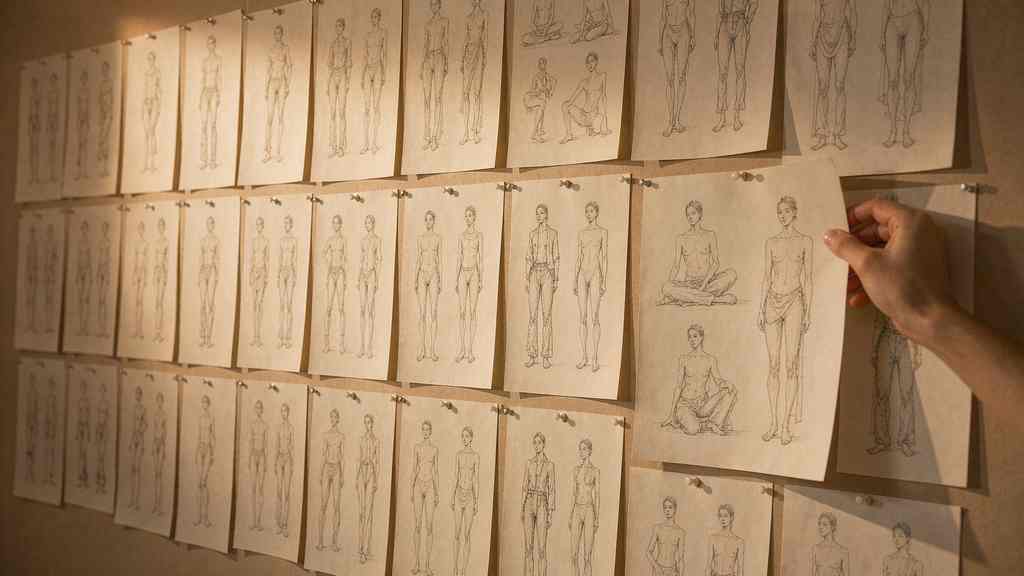
Comecemos pelo fim: este repositório não viralizou por ter muitas imagens. Imagem demais existe em qualquer pasta de drive. Ele viralizou porque pegou a tarefa de «escolher uma referência» e a quebrou em três peças substituíveis de forma independente — pessoa, roupa e pose — e depois deixou você montar as três numa receita e mandar tudo direto para o modelo. A diferença parece pequena e muda o modo de trabalhar: em vez de caçar a imagem perfeita, você declara três escolhas e deixa o sistema escrever a descrição por você.
O repositório se chama ai-pose-gallery-zh e o autor é Anhao. O primeiro parágrafo do README já fecha a conta: 1439 manequins base em branco, cada um com o seu mapa de profundidade, 3224 conjuntos de roupa, 1499 retratos, num total de 6162 registros de referência em chinês, 12022 imagens locais em alta resolução e mais 1760 imagens vindas dos sites originais. Os dados não foram fotografados por ele: são um espelho de galerias públicas de três autores — poses e roupas vêm do site de ギア (@giaaibusi), e as 440 roupas de anime vêm do CharaDB de たき AI. O que o projeto faz é traduzir, consolidar e colocar uma camada de ferramentas em cima disso. Três tarefas pouco glamorosas que, juntas, decidem se um acervo é consultável ou apenas um monte de arquivos com nomes incompreensíveis.
O que foi resolvido de verdade é a busca, não a qualidade da imagem
Quem já usou uma galeria de referências conhece o travamento. Você quer a modelo encostada na parede, mão no bolso, corpo inclinado a quarenta e cinco graus. A imagem está na sua cabeça, mas navegar pela galeria significa passar página por página de miniaturas, achar na vigésima página algo setenta por cento parecido e ainda descrever tudo com as próprias palavras. Os metadados do site original estão em japonês: categoria de movimento, subdivisão de penteado, estilo de roupa, tudo em etiquetas japonesas. Quem lê chinês ou não entende nada, ou entende e mesmo assim não consegue montar o prompt. O resultado é sempre o mesmo: a pessoa desiste no meio do caminho e escreve um prompt genérico, que é exatamente o que produz imagem genérica.
Este repositório traduz os 6162 registros para o chinês e os decompõe até um nível que permite montagem automática — comprimento do cabelo, 51 subcategorias de penteado, classificação de pose, etiquetas de composição. Ele afirma que o prompt montado sai «limpo, sem interferência de japonês». Parece frase de marketing, mas para geração de imagem é um problema real: quando o prompt mistura dois idiomas, a estabilidade do modelo cai.
O trio é o ponto, não o tamanho da lista de recursos
O Web Studio deixa você escolher um item de cada um dos três acervos: um retrato, uma roupa, uma pose. Manequim em branco e mapa de profundidade alternam com um clique. Depois de escolher, dá para arrastar, colar ou informar uma URL para incluir sua própria referência. A receita fica salva no IndexedDB: feche o navegador, abra de novo, ela continua lá. A interação não tem nada de novo; o novo é transformar «imagem de referência» de um arquivo solto em entrada estruturada. Uma foto deixa de ser um exemplo a ser imitado e passa a ser um campo preenchido, do mesmo jeito que um formulário.
Depois vêm as cinco conexões diretas: Google Gemini, OpenAI GPT Image, Qwen do Alibaba Cloud Bailian, Doubao do Volcano Ark e ComfyUI local. As quatro primeiras rodam assim que você preenche a chave; a quinta exige uma GPU na sua máquina. O projeto não treinou modelo próprio e não pretende — a aposta é que «mesma receita, outro modelo» vai virar operação de rotina.
O plugin de ComfyUI é a metade mais útil
O repositório em si é um plugin de ComfyUI: basta um git clone para custom_nodes/ e ele funciona, com quatro nós — pose, roupa, retrato e receita combinada. Os nós de pose e de receita trazem um interruptor use_depth embutido e conectam direto no ControlNet Depth. É um desenho que entende quem usa: o manequim entrega a estrutura, o mapa de profundidade entrega a relação espacial, e qual dos dois ajuda mais na hora de gerar depende de você precisar de pose exata ou de perspectiva exata.
O que eu gostei mais é a transformação dos 6162 registros num seletor visual em janela pop-up. Você abre na tela do ComfyUI, escolhe, volta e liga os fios. Comparado a procurar a imagem numa pasta e arrastar para o nó, a economia de tempo não é pequena. E como tudo roda na sua própria máquina, não há conta em serviço nenhum para abrir antes.
Três limites que precisam ficar claros
Primeiro: o direito sobre o material não está com ele. As imagens de pose, roupa e retrato vêm dos sites públicos dos autores originais; o repositório faz organização em chinês e arquivamento técnico, e o README diz explicitamente «proibido empacotar e revender». Para uso comercial, é preciso voltar à licença do autor original.
Segundo: o acervo inclui corpos e referências de roupa íntima com conteúdo 18+, e o modo seguro SFW vem ligado por padrão. Não é detalhe: o autor coloca o aviso logo depois do primeiro item do disclaimer, em vez de escondê-lo em letra miúda. Quem trabalha com esse tipo de material sabe que a diferença entre um aviso visível e um aviso enterrado no rodapé costuma aparecer só depois do problema.
Terceiro, e o mais importante: o projeto repete à exaustão que é proibido fazer troca de rosto em pessoas reais sem autorização. Essa cautela tem motivo — uma biblioteca que separa tão limpidamente «retrato + roupa + pose» é, por natureza, a montante de qualquer linha de produção de deepfake. A ferramenta é neutra; o uso não é.
Por que projetos assim não param de aparecer
No último ano, a barreira para gerar imagem desceu de «saber escrever prompt» para «ter uma boa referência». O lado dos modelos acompanha: modelos novos como o Seedream 5.5 começaram a entregar camadas com canal alfa nativo, e o GPT Image 2.6 levou a edição por marcação regional para a API. Os dois reduzem o retrabalho de «gerar e depois consertar». Quando gerar fica barato e estável, o que se torna escasso é a capacidade de organizar a entrada. O gargalo migra de dentro do modelo para a mesa de quem encomenda.
É aí que os 6162 registros fazem sentido. Não é uma galeria: é a tradução de «quero aquele clima» para coordenadas de três eixos que a máquina consegue executar. Dá para dizer que ele apenas organizou três acervos japoneses em chinês, mas organizar é exatamente onde a maioria trava.
Se você só quer testar, abra a demonstração online — funciona no celular. Se quer levar para produção, pense em duas coisas antes: até onde vai a licença do seu material e para quem você vai entregar essa receita. A primeira define se você pode usar comercialmente; a segunda define se vai receber uma notificação de advogado às três da manhã.
Artigos relacionados
O conselho criou um comitê de exportação na mesma semana do balanço
Só o resultado virou notícia. O comitê de controle de exportação é o que pode mudar de fato como a empresa opera.
A Nvidia nunca formou um banco de sucessores. Essa é a descoberta.
A empresa passou trinta e três anos decidindo, sem dizer, que a pergunta sobre quem vem depois não era urgente.
A AMD ganhou 19% só por ser a outra opção
O dinheiro não saiu de IA. Saiu do único nome com problema de governança e foi para os dois que não tinham.
Dez rebaixamentos em quatro sessões e nenhum número novo
Ninguém publicou dado novo sobre o livro de pedidos. O que mudou foi a largura da faixa, não o ponto do meio.