
Seimila riferimenti cinesi ridotti a tre carte: persona, abito, posa
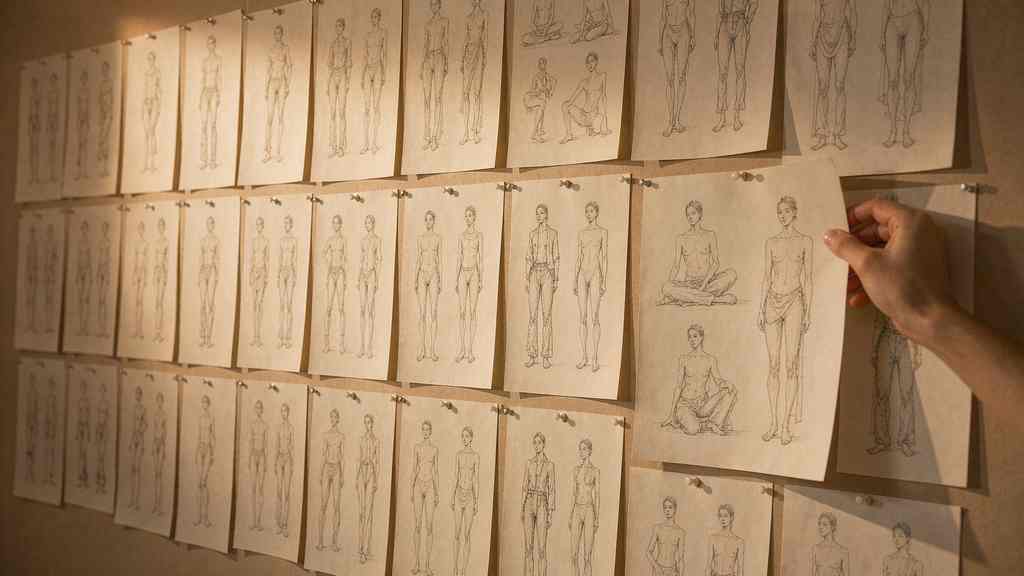
Partiamo dalla conclusione: questo repository è diventato popolare non perché ha tante immagini. Di immagini ce ne sono ovunque, nei cloud drive. È diventato popolare perché ha scomposto «scegliere un'immagine di riferimento» in tre parti sostituibili una per una — persona, vestiti, posa — e poi ti lascia montare queste tre cose in una ricetta da dare in pasto al modello. Nessun modello nuovo, nessun trucco: solo un modo diverso di organizzare l'input.
Il repository si chiama ai-pose-gallery-zh, autore Anhao. Il primo paragrafo del README fa i conti con precisione: 1439 modelli di base bianchi, abbinati a 1439 mappe di profondità; 3224 set di abiti; 1499 ritratti; in totale 6162 voci di riferimento in cinese, 12022 immagini locali in alta risoluzione, più altre 1760 immagini di riferimento provenienti dai siti di origine. I dati non li ha scattati lui: sono lo specchio delle gallerie pubbliche di tre autori. Il sito originale di pose e abiti è di ギア (@giaaibusi), mentre i 440 set di abiti anime arrivano da CharaDB di たき AI. Il suo lavoro è tradurre, unire, aggiungere uno strato di strumenti. È un lavoro poco appariscente e molto lungo, del tipo che non finisce in nessun post di lancio.
Il vero problema risolto è la ricerca, non la qualità dell'immagine
Chiunque abbia usato una galleria di riferimenti conosce quel blocco. Vuoi la modella appoggiata al muro, le mani in tasca, il corpo inclinato di quarantacinque gradi: hai l'immagine in testa, ma sfogliare la galleria significa guardare miniature una pagina dopo l'altra, arrivare alla ventesima per trovarne una somigliante al settanta per cento, e poi doverla comunque descrivere da solo. A quel punto capisci che il collo di bottiglia non era il modello: era il catalogo. I metadati del sito originale sono in giapponese: categorie di movimento, sottogeneri di acconciatura, stili di abbigliamento, tutto etichettato in giapponese. Un utente cinese o non capisce, o capisce ma non riesce a mettere insieme il prompt.
Questo repository traduce tutti i 6162 metadati in cinese e li scompone a un livello di granularità che permette l'assemblaggio automatico: lunghezza dei capelli, 51 sottotipi di acconciatura, categorie di posa, tag di outfit. Sostiene che il prompt così composto sia «pulito, senza interferenze giapponesi». Sembra marketing, ma per la generazione di immagini è un problema reale: con prompt che mescolano due lingue, la stabilità del modello cala.
Il punto è la combinazione a tre, non la lunghezza della lista di funzioni
Il suo Web Studio ti fa scegliere un elemento da ciascuna delle tre librerie: un ritratto, un abito, una posa. Si passa dal modello bianco alla mappa di profondità con un clic. Dopo la selezione puoi trascinare, incollare o inserire un URL per aggiungere i tuoi riferimenti. La ricetta viene salvata in IndexedDB e resta lì anche dopo aver chiuso il browser. L'interazione non è nuova; la novità è che trasforma l'«immagine di riferimento» da singolo file in un input strutturato.
Poi ci sono i cinque collegamenti diretti: Google Gemini, OpenAI GPT Image, Qwen di Alibaba Cloud Bailian, Doubao di Volcano Ark, ComfyUI in locale. I primi quattro funzionano inserendo la chiave, il quinto richiede una GPU sulla tua macchina. Non ha creato un modello proprio e non ha intenzione di farlo: punta sul fatto che «stessa ricetta, modello diverso, si rilancia» diventi un'operazione normale. Cinque strade diverse verso lo stesso output, ed è proprio questo il punto.
Il plugin per ComfyUI è la metà più utile
Il repository è già di per sé un plugin ComfyUI: basta un git clone dentro custom_nodes/. Quattro nodi: posa, abito, ritratto e ricetta combinata. I nodi posa e ricetta hanno un interruttore use_depth integrato che si collega direttamente a ControlNet Depth. Il design capisce come lavorano le persone: il modello bianco dà la struttura, la mappa di profondità dà le relazioni spaziali, e quale delle due funziona meglio dipende se ti serve precisione nella posa o nella prospettiva. Chi passa le giornate sui nodi sa che la differenza tra un flusso usabile e uno inutilizzabile sta quasi sempre in dettagli di questo tipo.
Quello che mi piace di più è che le 6162 voci diventano un selettore visuale a finestra dentro ComfyUI. Lo apri sulla tela, scegli, torni e colleghi i fili. Rispetto a frugare nelle cartelle e trascinare i file nei nodi, il tempo risparmiato non è poco.
Tre limiti da mettere in chiaro
Primo: il copyright dei materiali non è suo. Le immagini di pose, abiti e ritratti vengono dai siti pubblici degli autori originali; il repository fa solo riordino in cinese e archiviazione tecnica, e il README scrive esplicitamente «vietato impacchettare e rivendere». Per un uso commerciale devi tornare alle licenze degli autori.
Secondo: la galleria contiene modelli anatomici e riferimenti di biancheria intima 18+, con la modalità di sicurezza SFW attiva per impostazione predefinita. Non è un dettaglio: l'autore lo mette subito dopo il primo punto del disclaimer, non nascosto in caratteri piccoli.
Terzo, e il più importante: ribadisce più volte che è vietato il face swap su persone reali senza autorizzazione. La cautela ha una ragione: una libreria che separa così nettamente «ritratto + abito + posa» è per natura a monte di una catena di face swap. Lo strumento è neutro, l'uso non lo è, e vale la pena ripeterlo ogni volta che una libreria così diventa popolare.
Perché progetti così continueranno a uscire
Nell'ultimo anno la soglia per generare immagini si è abbassata: non è più «sai scrivere un prompt», è «hai un buon riferimento». Anche i modelli si muovono nella stessa direzione: nuovi modelli come Seedream 5.5 iniziano a produrre nativamente livelli con canale alfa, GPT Image 2.6 porta la modifica con marcatori locali nelle API, e entrambi riducono il lavoro di rifacimento dopo la generazione. Quando generare diventa economico e stabile, la scarsità si sposta sulla capacità di organizzare l'input.
È qui il vero significato dei 6162 riferimenti. Non è una galleria: è la traduzione di «voglio quella sensazione lì» in coordinate a tre segmenti che la macchina può eseguire. Puoi dire che si limita a riordinare in cinese tre archivi giapponesi, ma il riordino è esattamente il punto in cui la maggior parte delle persone si blocca.
Se vuoi solo provarlo, apri la demo online: funziona anche da telefono. Se vuoi portarlo in produzione, chiarisci prima due cose: fino a che punto arriva la licenza dei tuoi materiali, e a chi intendi affidare l'uso di queste ricette. La prima decide se puoi usarle commercialmente, la seconda se riceverai una lettera di un avvocato alle tre di notte. Nessuna delle due risposte è difficile da trovare, ma entrambe servono prima di aprire l'editor.
Articoli correlati
Un foglio di calcolo comunitario di tocchi che spegne la pubblicità negli Android cinesi
Non tocca il sistema, non sblocca niente, non flasha niente. Ribalta solo gli interruttori che i produttori hanno già previsto. Il prezzo è una lista che qualcuno deve continuare a scrivere.
GPT Image 2.6 ha tenuto il prezzo dei token e alzato la fattura
GPT Image 2.6 conserva ogni tariffa per token di 2.5 e costa comunque di più per immagine, perché buona parte del lavoro passa ora nei token di output. Undici giorni dopo il lancio, la struttura dei prezzi dice più della classifica.
Qualcuno ha ricostruito IDM dall'esterno e ha scritto cosa non ha toccato
Una reimplementazione in Rust di Internet Download Manager promette 5 volte la velocità e 86 lingue. Il documento più interessante è il paragrafo che spiega come è stata costruita senza copiare nulla.
Rune è un framework UI per Rust costruito perché un agente possa verificare il proprio lavoro
Rune renderizza headless, esporta il suo albero di elementi e accetta input scriptato, dando a un agente di coding un segnale diffabile che nessuno screenshot può offrire. Il framework è in pre-release e non accetta pull request.