
Seis mil referencias en chino, ordenadas en tres barajas: persona, ropa y pose
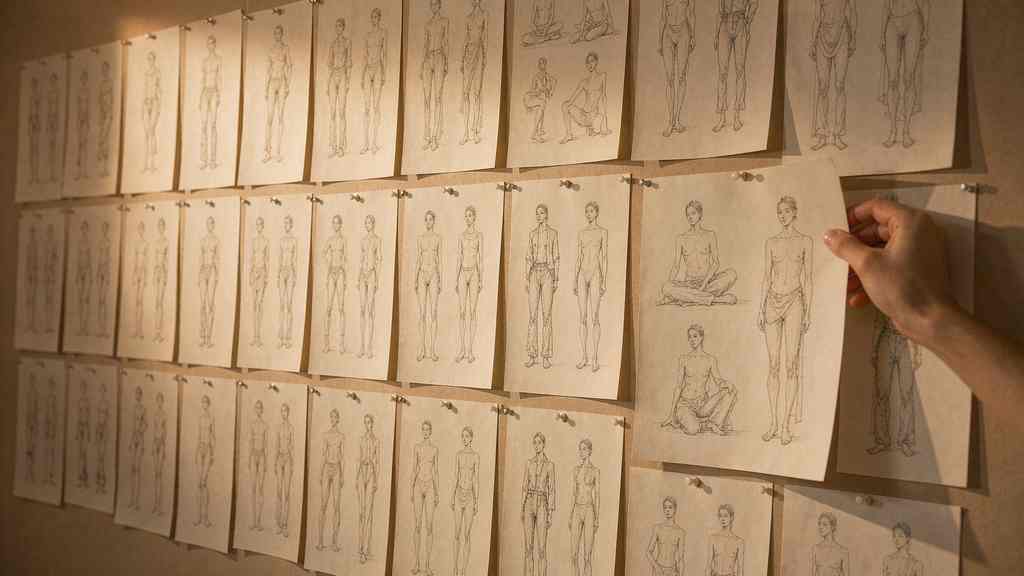
Empecemos por la conclusión: este repositorio se hizo popular, pero no por la cantidad de imágenes. Imágenes hay en cualquier servicio de almacenamiento en la nube. Lo que lo catapultó fue haber desarmado «elegir una imagen de referencia» en tres piezas que se pueden sustituir por separado —persona, ropa y pose— y permitir que las combines en una receta que luego lanzas directamente al modelo.
El repositorio se llama ai-pose-gallery-zh y su autor es Anhao. El primer párrafo del README hace las cuentas con claridad: 1439 modelos base en blanco, cada uno con su mapa de profundidad; 3224 conjuntos de ropa; 1499 retratos; en total 6162 registros de referencia en chino, 12022 imágenes locales en alta definición y otras 1760 tomadas de los sitios de origen. Los datos no los fotografió él: son un espejo de las galerías públicas de tres autores. El sitio original de poses y ropa pertenece a ギア (@giaaibusi), y los 440 conjuntos de ropa anime vienen de CharaDB, de たき AI. No hay escaneos propios ni sesiones de estudio; el trabajo está en la curaduría. Lo que hizo fue traducir, fusionar y añadir una capa de herramientas encima de material que ya existía y que, hasta ahora, solo era utilizable por quien leía japonés.
Lo que se resuelve es la búsqueda, no la calidad de imagen
Quien haya usado una galería de referencias conoce el punto de fricción. Quieres a la modelo apoyada en la pared, con las manos en los bolsillos, el cuerpo inclinado a cuarenta y cinco grados. Tienes la imagen en la cabeza, pero en la galería solo puedes pasar miniaturas página tras página; tras veinte páginas encuentras una que se parece al setenta por ciento, y encima tienes que describirla tú. No es que falte material: es que el material no está indexado para la pregunta que traes. Los metadatos del sitio original están en japonés: categorías de movimiento, subtipos de peinado, estilos de ropa, todo con etiquetas en japonés. Un usuario chino o no las entiende, o las entiende pero no logra armar el prompt.
Este repositorio traduce los 6162 metadatos al chino y los descompone hasta un nivel que permite el ensamblaje automático: largo del cabello, 51 subtipos de peinado, clasificación de poses, etiquetas de conjunto. Promete que el prompt resultante es «puro, sin interferencia del japonés». Suena a mercadotecnia, pero para generar imágenes es un problema real: cuando un prompt mezcla dos idiomas, la estabilidad del modelo cae.
Lo clave es la combinación de tres, no una lista larga de funciones
Su Web Studio te deja elegir uno de cada biblioteca: un retrato, un conjunto de ropa y una pose. Puedes alternar entre el modelo en blanco y el mapa de profundidad con un clic. Después puedes arrastrar, pegar o introducir una URL para añadir tus propias referencias. La receta se guarda en IndexedDB: cierras el navegador, lo vuelves a abrir y sigue ahí. La interacción no es novedosa; lo novedoso es que convierte la «imagen de referencia» en una entrada estructurada en lugar de una imagen suelta.
Luego están las cinco conexiones directas: Google Gemini, GPT Image de OpenAI, Qwen de Alibaba Cloud Bailian, Doubao de Volcano Ark y ComfyUI en local. Las cuatro primeras funcionan con solo introducir una clave; la quinta exige una tarjeta gráfica en tu máquina. No creó un modelo propio ni pretende hacerlo: apuesta a que «la misma receta, otro modelo» se volverá una operación habitual.
El plugin de ComfyUI es la mitad más práctica
El repositorio es en sí un plugin de ComfyUI: basta con hacer git clone en custom_nodes/ para usarlo. Trae cuatro nodos: pose, ropa, retrato y receta combinada. Cada uno tiene su propia salida y se conecta como cualquier otro nodo del grafo. Los nodos de pose y de receta incluyen un interruptor use_depth que se conecta directamente a ControlNet Depth. El diseño entiende bien al usuario: el modelo en blanco da la estructura y el mapa de profundidad da la relación espacial; cuál funciona mejor al generar depende de si buscas exactitud de postura o exactitud de perspectiva.
Lo que más me gusta es que convirtió los 6162 datos en un selector visual emergente. Lo abres sobre el lienzo de ComfyUI, eliges y vuelves a conectar. Comparado con buscar en carpetas y arrastrar la imagen al nodo, el tiempo que ahorra no es menor.
Tres límites que hay que dejar claros
Primero, los derechos del material no están en sus manos. Las imágenes de pose, ropa y retrato vienen de los sitios públicos de los autores originales; el repositorio solo ordena y archiva en chino, y el README dice expresamente «prohibida la reventa empaquetada». Si quieres uso comercial, tienes que volver a la licencia del autor original.
Segundo, la galería incluye cuerpos base y referencias de ropa interior para mayores de 18 años, con el modo seguro SFW activado por defecto. No es un detalle menor: el autor lo pone justo después del primer punto del aviso legal, no escondido en letra pequeña.
Tercero, y lo más importante: insiste una y otra vez en que está prohibido el cambio de rostro de personas reales sin autorización. Esa cautela tiene motivo: una biblioteca que separa con tanta limpieza el trío «retrato + ropa + pose» es, por naturaleza, la parte de arriba de una cadena de producción de deepfakes. La herramienta es neutra; el uso no.
Por qué proyectos así no dejan de aparecer
En el último año, el umbral para generar imágenes bajó de «saber escribir prompts» a «tener buenas referencias». El lado de los modelos acompaña el cambio: modelos nuevos como Seedream 5.5 ya entregan de forma nativa material por capas con canal alfa, y GPT Image 2.6 llevó la edición por marcas locales a la API; ambos reducen el retrabajo de «generar y luego corregir». Cuando generar se vuelve barato y estable, lo escaso pasa a ser la capacidad de organizar la entrada.
Ahí está el verdadero sentido de las 6162 referencias. No es una galería, es una forma de traducir «quiero esa sensación» a coordenadas de tres partes que la máquina puede ejecutar. Puedes decir que solo ordenó en chino tres archivos japoneses, pero ordenar es justamente donde se atasca la mayoría.
Si solo quieres probar, abre la demostración en línea; funciona incluso en el móvil. Si quieres llevarlo a producción, aclara antes dos cosas: hasta dónde llega la licencia de tu material y a quién vas a darle acceso a esta receta. Lo primero decide si puedes usarlo comercialmente; lo segundo, si algún día a las tres de la mañana recibes una carta de un abogado.
Artículos relacionados
Una hoja de cálculo comunitaria de toques que apaga la publicidad de los Android chinos
No toca el sistema, no desbloquea nada, no flashea nada. Solo mueve los interruptores que los fabricantes ya dejaron a la vista. El precio es una lista que alguien tiene que seguir escribiendo.
GPT Image 2.6 mantuvo el precio por token y subió la factura
GPT Image 2.6 mantiene cada tarifa por token de 2.5 y aun así cuesta más por imagen, porque buena parte del trabajo ocurre ahora en tokens de salida. Once días después del lanzamiento, la estructura de precios dice más que el ranking.
Alguien reconstruyó IDM desde fuera y anotó lo que no tocó
Una reimplementación en Rust de Internet Download Manager promete 5 veces la velocidad y 86 idiomas. El documento más interesante es el párrafo que explica cómo se construyó sin copiar nada.
Rune es un framework de UI en Rust creado para que un agente pueda comprobar su propio trabajo
Rune renderiza sin interfaz, vuelca su árbol de elementos y acepta entrada programada, lo que da a un agente de código una señal diffeable que una captura nunca ofrece. El framework está en prelanzamiento y no acepta pull requests.