
LocalAI:在任何硬體上運行 LLM、圖像與影片,無需 GPU
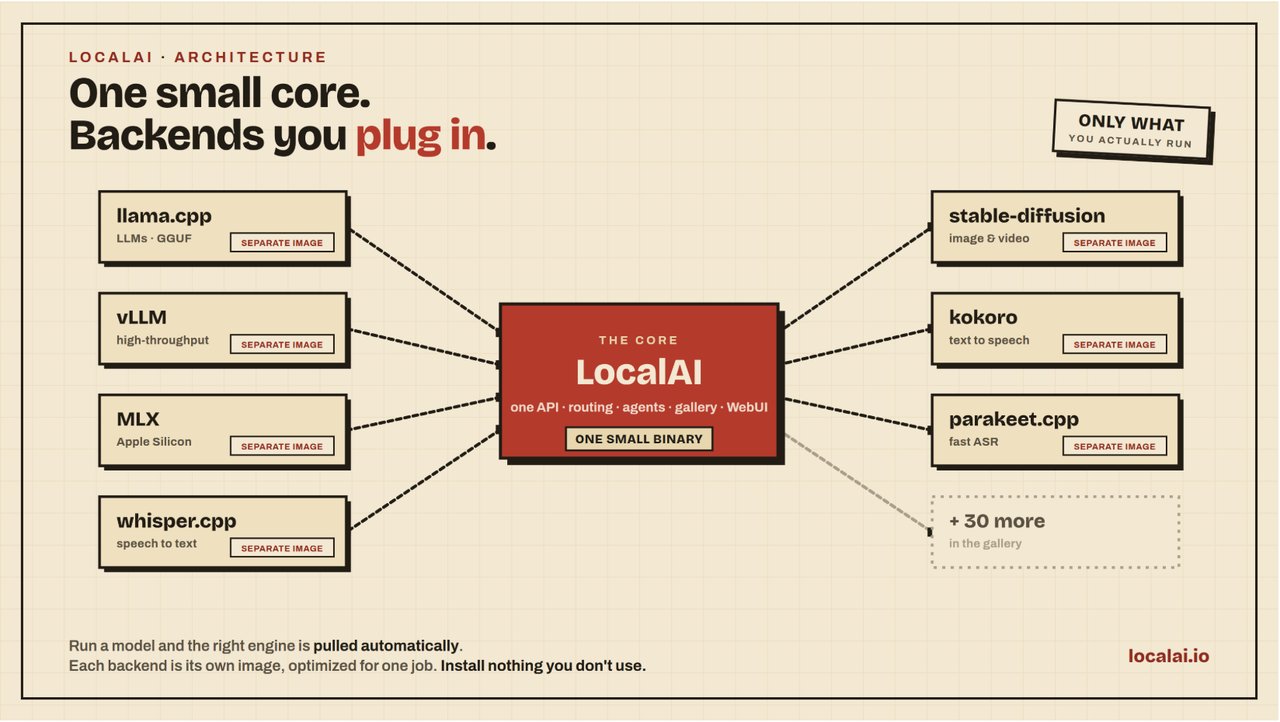
說真的,2026 年讓我們大家都在想,運行 AI 是否代表要賣掉一顆腎臟,才能擁有資料中心 GPU。接著,像 LocalAI 這樣的開源專案出現了,徹底扭轉局勢。LocalAI 是一款自架、開源的 AI 引擎,可以運行 LLM、圖像生成、影片模型、語音辨識、文字轉語音,以及更多功能——就在你自己的機器上,不需 GPU,而且完全保有隱私。如果你一直在尋找逃離 API 鎖定的方法,這就是你的入場券。
LocalAI 有何不同?
這個專案形容自己是「一個小型核心,而非一套組合包」。LocalAI 並非把所有可能的依賴項目放入單一巨型二進位檔,而是設計成可組合的:每個後端都會將 llama.cpp、vLLM、whisper.cpp、stable-diffusion 或 MLX 等成熟的引擎包在自己的容器映像中。該後端只有在模型真正需要時才會被拉取。這表示你不必安裝一座你用不到的軟體大山,而且可以用任何語言,透過自訂後端擴充 LocalAI。
LocalAI 也可以直接取代你已經熟悉的 API。它在所有模式中都與 OpenAI API、Anthropic API 和 ElevenLabs 音訊 API 相容。所以,如果你已有為託管 API 撰寫的程式碼,並決定改在本機執行,通常只需要改端點 URL 就好。
無 GPU 的魔法
大多數熱門模型在 CPU 上也能正常執行,只是較慢;而當你擁有硬體加速時,LocalAI 支援 NVIDIA(CUDA 12/13)、AMD(ROCm)、Intel(oneAPI)、Apple Silicon(Metal)、Vulkan,甚至 NVIDIA Jetson 裝置。你可以從一台純 CPU 筆電開始,日後再移到 GPU,不需要變更工作流程。LocalAI 也會自動偵測你的 GPU 能力,然後抓取正確的後端,因此你不必與一大堆環境變數奮戰。
十秒安裝
開始使用 LocalAI 真的毫不費力。最快的路徑是 Docker。如果只需要 CPU,執行這行指令:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
有 NVIDIA GPU 嗎?選用相符的 CUDA 映像檔,並加上 --gpus all:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
AMD 使用者可以使用 HIPBLAS 映像檔,並搭配幾個裝置旗標;Intel 和 Vulkan 使用者也有專屬映像檔。如果你偏好原生應用程式,也有官方的 macOS DMG——只要記得安裝後移除 quarantine 屬性即可,因為 Apple 尚未簽署它。確切指令可以在專案的 README 中找到。
載入模型:一個指令,無限選擇
載入模型最簡單的方式是使用內建的指令列工具。LocalAI 提供了一個「統治一切」的指令:
local-ai run llama-3.2-1b-instruct:q4_k_m
這條指令會從 LocalAI 的模型庫中取得模型。但你不會被限制在那個模型庫中。你可以直接從 Hugging Face、Ollama 的登錄庫,或任何標準的 OCI 登錄庫拉取模型:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
你甚至可以把 LocalAI 指向 YAML 設定檔,完整按照你想要的方式,定義模型的設定與上下文長度。
與你的終端機代理聊天
一旦模型載入完成,你會看到一個實驗性但非常酷的內建終端機代理。它不會只是進入普通的 REPL,它還可以讀取檔案、回答問題,並在你的機器上執行指令。它會在任何變更前先請求允許,讓你隨時保持主控權。在終端機中啟動伺服器:
local-ai run llama-3.2-1b-instruct:q4_k_m
接著開啟另一個 shell,跟它對話:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
聊天時,你可以輸入 /models 查看已安裝的模型,或輸入 /model <name> 在對話中切換模型。這很酷;但如果你還沒準備好讓 AI 碰你的終端機,在連接埠 8080 上也有普通的 OpenAI 相容聊天伺服器,你可以用任何自己喜歡的用戶端。
LocalAI 究竟能做什麼?
LocalAI 的功能清單真的會讓人眼花撩亂。在文字方面,你可以使用文字生成、嵌入(embeddings)、重排序器(rerankers)、Vision API,以及 OpenAI 相容工具。在語音方面,有音訊轉文字、文字轉音訊、使用 WebRTC 的即時語音對語音、語音活動偵測,甚至說話者分離。圖像生成、影片生成、物體偵測和深度估計也都在支援之列。如果你需要結構化輸出,它支援受限語法和 JSON Schema。
後端庫包含超過 60 個後端。有些是 LocalAI 團隊以 C++/GGML 打造的原生引擎,例如用於轉錄的 parakeet.cpp、用於說話者辨識的 voice-detect.cpp,以及 free-splatter.cpp——它可以在沒有 GPU、也沒有相機姿態資訊的情況下,把少數幾張照片變成 3D 高斯。這些不只是包裝;它們是從零開始的 C++ 實作,執行階段完全不靠 Python 推論,這在可攜性上是相當了不起的成就。
近期的版本加入了具 VRAM 感知路由與自動擴展的分散式模式、MCP(Model Context Protocol)支援、多使用者配額管理,以及直接在 UI 中進行的微調。換句話說,它不再只是個模型執行器,而是能服務個人與團隊的完整平台。
隱私優先的 AI 終於可行
LocalAI README 裡有一句話總結了全部吸引力:「你的資料永遠不會離開你的基礎架構。」當你執行 LocalAI 時,每個 API 請求都留在你自己的機器上。不會有提示詞外洩,不會有資料去訓練他人的模型,也不會因為法規遵循而頭痛。搭配它對微調與量化的支援,你可以打造一個完全私密、同時仍然遵循開放標準的 AI 技術堆疊。
這個專案以 MIT 授權釋出,由 Ettore Di Giacinto 和活躍的社群維護。你可以在 LocalAI 模型庫瀏覽模型,或是直接參考 GitHub上的快速入門。一旦深入使用,你很可能會同意:LocalAI 是目前最接近我們理想中,能依自己的方式運行 AI 的通用、開放、道德健全方案。
相關文章
Deep-Live-Cam 2.1.6:一張照片即可即時換臉
探索 Deep-Live-Cam,這款開源工具只需一張圖片就能即時換臉。了解如何安裝並負責任地使用它。
Hermes Agent:從每項任務中學習的自我改進AI
Hermes Agent是來自Nous Research的開源AI代理,它會隨著時間學習技能、記住你的上下文,並能在手機、筆記型電腦或5美元VPS上執行。
Humanizer:讓 AI 寫作聽起來像真人撰寫的開源工具
Humanizer 使用維基百科「Signs of AI writing」(AI 寫作跡象)中的 35 種模式,將 AI 味文字改寫成自然、如真人撰寫的散文。了解運作原理、前後對比範例與安裝步驟。
認識 VoiceStudio:免費、本機優先的語音複製,支援 646 種語言
VoiceStudio 將免費、開源、本機優先的語音工作室帶到你的桌面——從 3 秒音訊複製任何聲音,並可生成 646 種語言,完全不需花費一毛錢。