
Le DGX Spark 64 Go de NVIDIA à 4 999 $ met un pétaflop sur le bureau pour des agents toujours actifs
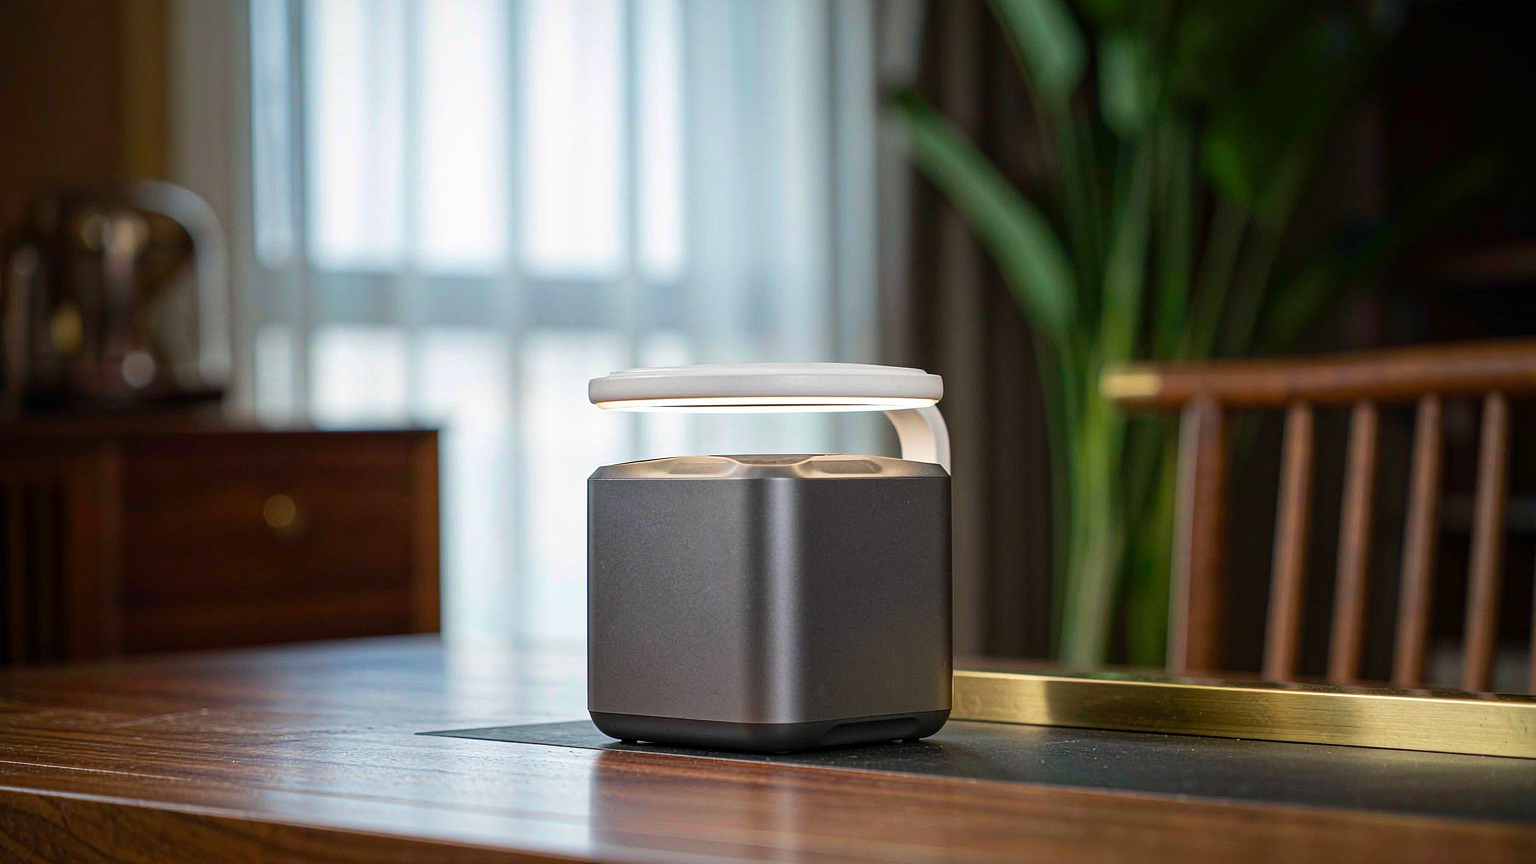
NVIDIA a confirmé une version 64 Go de son ordinateur de bureau IA DGX Spark, à partir de 4 999 $, expédiée le 23 octobre via Acer, Asus, Dell, Gigabyte, HP, MSI et H3C. Le modèle 128 Go reste en vente à 6 950 $. Les deux sont construits sur la superpuce GB10 Grace Blackwell, qui associe un GPU Blackwell à un CPU Arm 20 cœurs dans un seul package et partage un unique pool de mémoire LPDDR5X entre eux.
L'architecture est l'argument de vente. La mémoire unifiée cohérente signifie que le CPU et le GPU voient le même espace d'adressage, ce qui vous évite de copier des données entre la RAM système et la VRAM. Sur une machine de 64 Go, environ 8 Go sont alloués au système d'exploitation, laissant environ 56 Go pour les poids du modèle et le cache KV qui croît avec la longueur du contexte. NVIDIA évalue la puce à jusqu'à un pétaflop de calcul IA au format FP4.
Ce que 64 Go exécute réellement
NVIDIA positionne la configuration 64 Go pour les modèles de la classe 30B à 35B : Qwen3.8-27B, Gemma 4 26B, Meta Muse Glimmer et Nemotron 3.5 Lightning. Avec la quantification NVFP4, dont NVIDIA affirme qu'elle préserve la précision, une seule machine peut gérer des modèles allant jusqu'à environ 100 milliards de paramètres. C'est tout l'intérêt de cette machine. Il y a un an, des modèles de ce niveau nécessitaient une baie de serveurs. Aujourd'hui, ils tiennent dans un boîtier de la taille d'un grand panier-repas.
Le compromis est la bande passante mémoire. À 273 Go/s, le Spark n'est pas conçu pour servir un produit de chat à une centaine d'utilisateurs simultanés. Il est conçu pour des entrées longues et des sorties courtes : lire un dépôt, un vidage de logs ou une pile de documents et écrire un résultat court. Cette forme convient bien aux agents, car un agent passe la plupart de son temps à lire du contexte et ne produit qu'occasionnellement une réponse.
La lignée derrière le boîtier
Le Spark n'est pas la première tentative de NVIDIA pour mettre du calcul sérieux sous un bureau. La version 128 Go existait déjà à un prix plus élevé, et le modèle 64 Go est un mouvement délibéré vers le bas de gamme. Conserver la même puce GB10 et la même conception de mémoire unifiée tout en réduisant la mémoire de moitié abaisse le coût d'entrée sans changer la vocation de la machine. C'est important, car le modèle précédent était tarifé comme une station de travail, et un prix de station de travail limite qui peut en acheter une.
Il y a une seconde raison pour laquelle la configuration 64 Go a du sens aujourd'hui plutôt qu'il y a un an. Les modèles ouverts qui tiennent dans 56 Go sont suffisamment bons pour valoir la peine d'être exécutés. Un modèle 27B avec des poids quantifiés et une longue fenêtre de contexte peut gérer de véritables tâches de codage et de recherche plutôt que des prompts jouets. Il y a six mois, exécuter la capacité équivalente en local nécessitait une machine plus grosse et une facture plus élevée. Le matériel et les modèles sont arrivés au même seuil, et c'est ce qui rend la baisse de prix significative plutôt que décorative.
Le clustering est une fonctionnalité de premier ordre
Chaque DGX Spark est livré avec une carte réseau ConnectX-7 fonctionnant jusqu'à 200 GbE, et l'application gratuite NVIDIA Sync gère l'installation. Son Assistant de cluster configure le réseau afin que vous puissiez joindre jusqu'à quatre unités sans être administrateur réseau. Deux Sparks de 64 Go se regroupent pour atteindre 128 Go, et NVIDIA affirme que cette paire offre jusqu'à 1,7 fois les performances d'un seul modèle 128 Go, car la puissance de calcul et la bande passante combinées sont à peu près doublées. Un câble direct relie une paire ; quatre unités nécessitent un commutateur.
L'effet pratique est une échelle progressive. Commencez avec une machine pour expérimenter, ajoutez-en une seconde pour une charge de travail réelle, et continuez jusqu'à ce que la charge dépasse le matériel local. Le temps jusqu'au premier token s'améliore surtout lorsque vous montez en puissance, ce qui compte pour les agents qui lisent de longues entrées avant d'agir.
La couche logicielle, là où vit l'histoire des agents
Le Spark est livré avec DGX OS, la pile CUDA et les outils habituels : PyTorch, Jupyter, Ollama, ainsi qu'un support optimisé pour vLLM et llama.cpp. NVIDIA revendique une inférence locale d'agents jusqu'à 1,9 fois plus rapide grâce à ses optimisations. Il inclut également OpenShell, qui fait partie du NVIDIA Agent Toolkit, et qui définit des limites basées sur des politiques pour ce qu'un agent peut faire.
Ce dernier élément s'inscrit dans une tendance plus large. À mesure que les agents passent de la démo à l'usage quotidien, le goulot d'étranglement cesse d'être le modèle pour devenir la fiabilité. Une machine locale qui exécute un agent toute la nuit doit effectuer correctement des appels d'outils, se remettre des échecs et ne pas sortir de son périmètre. NVIDIA s'appuie exactement sur cela : le Spark vise les agents toujours actifs, pas les prompts ponctuels.
Perplexity s'est déjà adapté à ce matériel, en livrant un agent optimisé pour ordinateur portable capable d'exécuter un modèle 118B localement sur l'appareil. C'est un signal notable, car Perplexity est une entreprise tournée d'abord vers le cloud. Si elle développe pour du matériel local, c'est qu'elle anticipe un marché d'utilisateurs qui veulent le modèle sur leur propre machine.
À qui cela s'adresse, et à qui non
Le prix de 4 999 $ place le Spark dans le territoire professionnel, pas grand public. Les personnes qui en bénéficient sont les chercheurs, les développeurs indépendants et les petites équipes qui exécutent des agents suffisamment souvent pour que les frais d'API par token s'accumulent, ou qui travaillent avec des données qui ne peuvent pas quitter leur propre matériel. Affiner un modèle de codage sur un dépôt privé, exécuter une évaluation dès le premier jour sur un nouveau modèle ouvert, ou garder plusieurs modèles résidents en même temps sont autant de tâches qui correspondent à la conception de mémoire unifiée.
Pour tous les autres, le calcul est moins évident. Si vous utilisez l'IA quelques fois par jour, les API cloud sont moins chères et plus simples. Le Spark a du sens lorsque votre utilisation est élevée, que vos données sont sensibles ou que votre charge de travail tourne en continu. Le modèle 64 Go abaisse le prix d'entrée mais ne change pas cette logique.
Un détail mérite d'être signalé pour quiconque établit un budget. Les 56 Go de mémoire utilisable doivent couvrir à la fois les poids et le cache KV. Un long contexte consomme du cache, et les charges de travail des agents sont longues par nature. Un modèle quantifié qui tient techniquement peut quand même se heurter à un mur une fois le contexte développé, c'est pourquoi NVIDIA désigne la version quantifiée de 17 Go d'un modèle plus grand comme le choix pratique plutôt que sa version pleine précision de 55 Go. Faire tenir un modèle et l'exécuter correctement sur une longue tâche sont deux tests différents.
Le signal plus important
La partie intéressante de cette annonce n'est pas la baisse de prix. C'est qu'un modèle 27B ou 30B exécuté sur un ordinateur de bureau est désormais assez proche du comportement de pointe d'il y a quelques mois pour que la machine mérite qu'on construise un produit autour d'elle. Le matériel et les modèles ouverts ont convergé au même point : un boîtier sous un bureau, exécutant un agent qui travaille pendant que vous dormez, avec des données qui ne quittent jamais le bâtiment.
NVIDIA parie qu'assez de développeurs le veulent pour justifier une gamme de produits. La liste des OEM qui expédient le Spark suggère qu'elle pense que la réponse est oui, et que les prochaines années de travail sur l'IA ne se dérouleront pas toutes dans un centre de données.
Articles associés
Les images produits par IA se heurtent à un mur de conformité que personne n’avait intégré dans ses coûts
Le coût a toujours été annoncé à la génération. Le coût réel se compte par visuel qui passe le contrôle.
Les robots peuvent effectuer 74 % du travail physique, et presque rien de tout cela n'est rentable
La capacité est largement présente. L'économie ne l'est pas. Quarante ans pour atteindre dix pour cent n'est pas une prévision qui justifie la panique.
Un modèle agentique à poids ouverts de 744 Md arrive sous licence MIT
La licence est le marketing. Un modèle de 744 Md que tout le monde peut télécharger rebat les cartes de l’arbitrage entre achat et construction.
Les modèles vidéo IA chinois débarquent à Hollywood : 73 plans dans les effets visuels de la série d'Amazon
Ce ne sont pas les séries qui s'exportent, mais les outils qui servent à les fabriquer.