
La prochaine frontière de l'IA : transformer une seule image fixe en scène animée
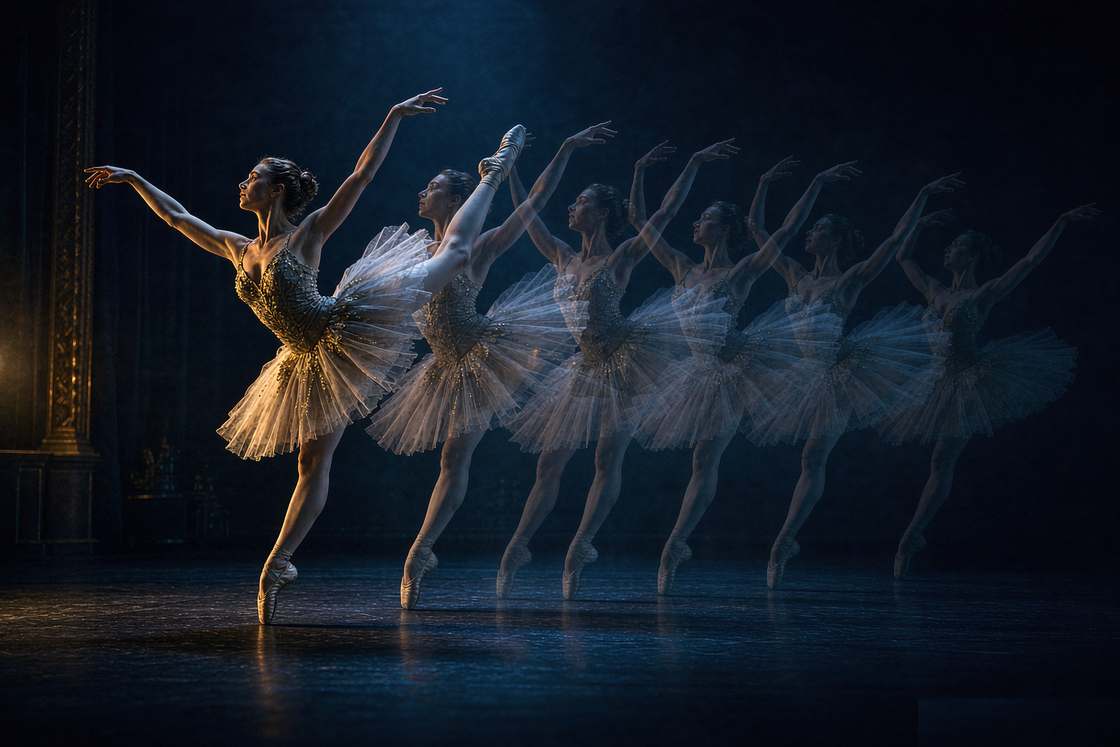
La génération d'images est devenue suffisamment performante pour que la conversation évolue. La nouvelle frontière, celle que les outils et les chercheurs poursuivent en ce moment, c'est la vidéo. Plus précisément, prendre une seule image fixe et la faire bouger.
Cela peut sembler un petit pas, mais c'est un problème technique différent. Un modèle de diffusion d'images transforme le bruit en une seule image cohérente. La vidéo, elle, implique des centaines d'images qui doivent rester cohérentes entre elles, avec la physique du sujet et avec l'image d'origine. Si l'on se trompe, le visage du personnage se déforme au bout de trois secondes.
C'est là que se concentre l'énergie en 2026, et il vaut la peine de comprendre ce qui est réellement possible aujourd'hui, car l'écart entre la démo et l'outil réellement utilisable reste tout l'enjeu.
Le problème de la physique, et pourquoi c'était difficile
La façon la plus claire de comprendre pourquoi c'est difficile est d'observer ce que fait un bon outil image-vers-vidéo lorsqu'il fonctionne.
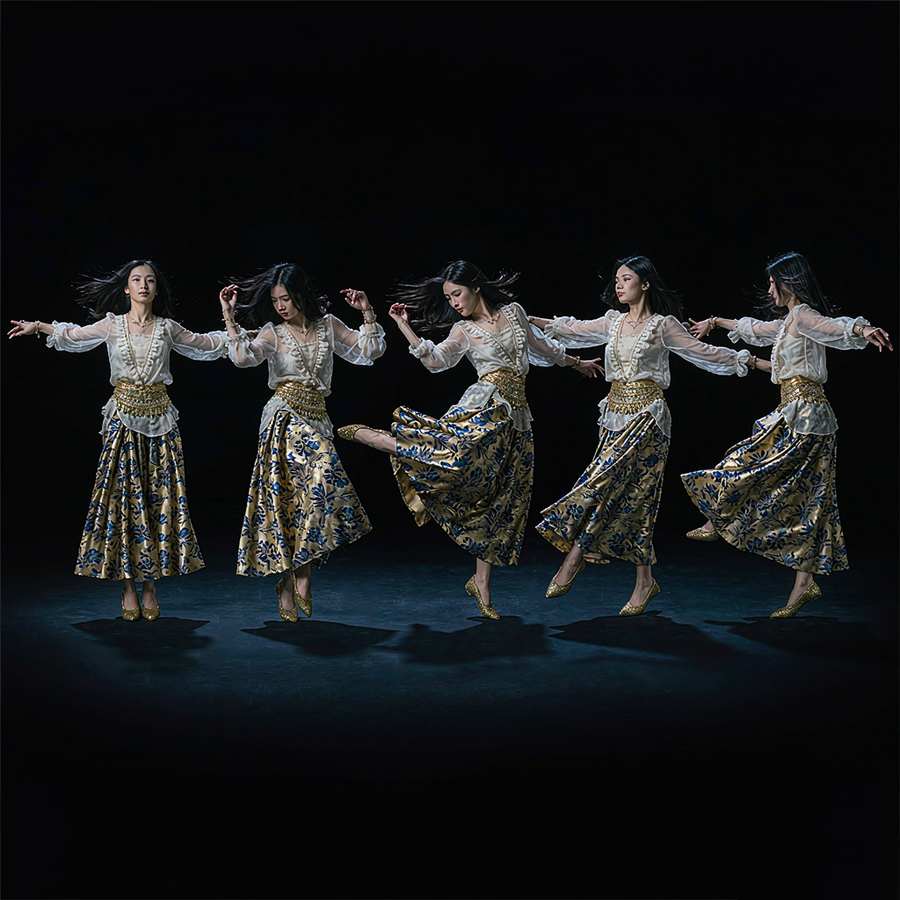
Prenons un personnage. Une image fixe d'une personne est une pose figée. Pour animer cette personne en train de danser, de marcher ou de faire un signe, le modèle doit comprendre la géométrie du corps, pas seulement les pixels. S'il se contente de copier des motifs visuels, les membres dérivent, les proportions se déforment, et l'on obtient le mouvement fondu, semblable à une marionnette, qui caractérisait les premiers outils.
Viggle, l'outil devenu célèbre précisément pour cela, a bâti sa réputation sur une approche différente. Son modèle JST-1 est un modèle physique 3D plutôt qu'un pur modèle de diffusion. Il s'appuie sur une compréhension de la géométrie du corps, ce qui explique pourquoi les proportions des personnages tiennent bon dans les chorégraphies rapides et complexes, là où les générateurs image par image ont tendance à s'effondrer. Ce modèle anime les personnages à partir d'une seule image fixe, et il est devenu le choix par défaut des créateurs de mèmes et de formats courts qui veulent faire danser un personnage.
Le côté open source se réveille
Le monde de l'open source a été plus lent sur ce terrain, car la génération vidéo coûte cher à entraîner. Mais il avance.
Viggle a publié Viggle-Animate sur Hugging Face en septembre, un modèle image-vers-vidéo destiné au remplacement de personnages et au montage vidéo, distillé à partir de MiniMax-H3. La distillation consiste à entraîner un modèle plus petit à reproduire le comportement d'un modèle parent plus grand, ce qui est important lorsque l'objectif est une inférence plus rapide et des coûts de calcul réduits. Cette version a une portée limitée : elle remplace des personnages et monte des séquences existantes plutôt que de générer des clips à partir de zéro, mais elle met un outil spécialement conçu entre les mains des développeurs sans API fermée.
Cette tendance mérite d'être suivie. Chaque problème difficile de l'IA finit par être ouvert, et le montage vidéo axé sur les personnages était l'un des plus difficiles à garder fermé. La version ouverte est brute et la licence n'est pas standard, mais c'est un signal que l'écosystème open source rattrape les outils fermés.
Le paysage commercial
Côté commercial, le secteur s'est organisé en niches.
Viggle domine l'animation de personnages à partir d'images fixes. Ce n'est pas un outil vidéo généraliste, et il ne gère pas les paysages ni les produits, mais pour faire danser ou poser un personnage à partir d'une seule image, il n'a pas de vrai rival. L'offre gratuite donne cinq vidéos filigranées par jour, et les formules payantes ajoutent de la résolution et suppriment le filigrane.
PixVerse est en tête sur le budget. Il transforme une seule image fixe en un court clip stylisé, avec un contrôle des images de début et de fin pour guider le mouvement entre deux images clés, et il propose un vaste catalogue d'effets viraux en une seule touche. Le compromis, ce sont des clips courts et une cohérence narrative plus faible.
Runway et Kling se situent à l'extrémité production pour ceux qui ont besoin d'un contrôle multi-scènes et de mouvements de caméra. Et les créateurs de modèles eux-mêmes, OpenAI, Google et xAI, continuent de faire progresser leurs modèles vidéo, la fonctionnalité « image unique vers vidéo » étant de plus en plus intégrée aux applications principales plutôt que vendue séparément.
Comment vraiment utiliser ces outils sans perdre votre temps
Les personnes qui tirent une vraie valeur de l'image-vers-vidéo en ce moment partagent quelques habitudes, qui valent la peine d'être copiées.
Commencez par une bonne image fixe. L'animation ne peut pas réparer une image source de mauvaise qualité. Si le personnage est flou, décentré ou mal posé, la vidéo sera floue, décentrée et mal posée, en mouvement. Générez ou choisissez d'abord une image nette et bien éclairée, et l'animation aura de la matière avec laquelle travailler.
Concevez en fonction de la limite de durée des clips. La plupart de ces outils plafonnent autour de dix à quinze secondes, et les meilleurs résultats restent bien en deçà de cette limite. Prévoyez une boucle, une accroche ou un seul moment fort plutôt qu'une scène. Essayer d'étirer un outil au-delà de ce qu'il fait, c'est ainsi que l'on obtient les images déformées que tout le monde a déjà vues.
Utilisez les images clés lorsque l'outil les propose. PixVerse et d'autres permettent de définir une image de début et une image de fin, ce qui donne au modèle deux points d'ancrage entre lesquels interpoler. Cette seule habitude élimine la plus grande partie de la dérive et donne au mouvement une impression d'intention plutôt que de hasard.
Et soyez honnête sur le résultat. Ces outils sont les plus performants pour le contenu stylisé, axé sur les personnages ou la présentation de produits. Ils ne remplacent pas encore les vraies images lorsque le réalisme et la confiance comptent. Pour un mème, une publication sur les réseaux sociaux ou une boucle de produit, ils sont prêts. Pour tout ce qui doit avoir l'air d'avoir été filmé, ils ne le sont pas.
Les créateurs qui prospèrent avec l'image-vers-vidéo sont ceux qui la considèrent comme un nouveau type de caméra, avec ses propres limites, plutôt que comme une version moins chère de l'ancienne. Apprenez les limites et filmez à l'intérieur de celles-ci, et une seule image fixe devient une toile étonnamment vaste.
Ce qui est réellement utilisable aujourd'hui
La version honnête, c'est que l'image-vers-vidéo est passée de la « démo » à « utile pour les courts clips », mais qu'elle n'a pas encore atteint le stade « prête pour la production en format long ».
Pour une boucle de dix secondes d'un personnage qui danse, une publication sociale stylisée ou une rotation de produit pour une publicité, les outils sont assez bons pour que le résultat vaille l'effort. Pour tout ce qui exige une continuité narrative, un travail de caméra cohérent ou une minute complète d'images cohérentes, les outils s'effondrent encore.
Ce n'est pas une critique. C'est simplement l'état actuel de la technologie. Ceux qui tirent de la valeur de l'image-vers-vidéo aujourd'hui sont ceux qui respectent la limite de durée des clips et conçoivent autour d'elle, plutôt que de lutter contre elle.
La frontière est pourtant réelle. L'industrie a clairement indiqué que la génération 3D et l'animation vidéo à partir d'images uniques sont la prochaine grande étape, censée mûrir d'ici un an ou deux. Le fait que les outils open source et fermés convergent désormais vers l'animation de personnages à partir d'une seule image fixe signifie que la partie la plus difficile, la physique du mouvement, est enfin traitée comme un problème d'ingénierie soluble plutôt que comme une curiosité de recherche.
Articles associés
La pile open-source d'images IA se reconstruit, un workflow à la fois
Workflow1111 recrée AUTOMATIC1111 avec 73 nœuds et 11 pipelines. Ce que la reconstruction par la communauté signifie pour la génération d'images locale.
Les chiffres derrière la génération d'images par IA : une chute de prix de 99 % a dévoré la photographie de stock
Taille du marché, disruption de la photo de stock, chiffres d'adoption et flux de travail hybride, expliqués par les statistiques.
Comment choisir les outils chinois de génération d'images par IA en septembre 2026 : comparatif Jimeng, Tongyi Wanxiang,
Comparatif détaillé de Jimeng, Tongyi Wanxiang, Kling, Doubao et LiblibAI : qualité d'image, compréhension du chinois, droits commerciaux et quotas gratuits, pour choisir l'outil adapté à vos besoins.
Flux 2 vs Stable Diffusion 3.5 : la course à l’image open source a un leader clair
Flux 2 domine sur la qualité, Stable Diffusion 3.5 conserve l’écosystème le plus profond. Comment choisir entre eux en 2026.