
LocalAI: ejecuta LLMs, imágenes y video en cualquier hardware, sin GPU
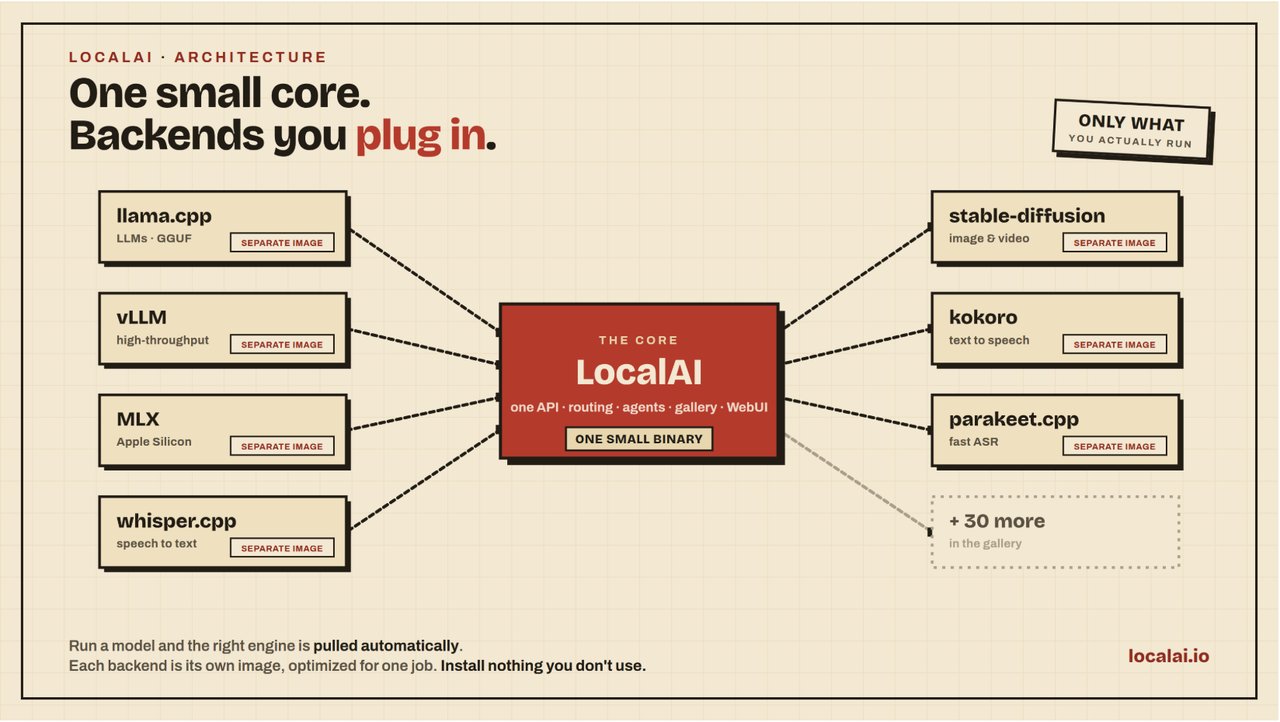
Seamos honestos: 2026 nos hizo preguntarnos si ejecutar IA significaba vender un riñón por una GPU de centro de datos. Entonces proyectos de código abierto como LocalAI aparecieron y cambiaron las reglas del juego. LocalAI es un motor de IA de código abierto y autoalojado que puede ejecutar LLMs, generación de imágenes, modelos de video, reconocimiento de voz, texto a voz y mucho más, en tu propia máquina, sin GPU y con total privacidad. Si has estado buscando una forma de escapar del bloqueo de proveedores de API, este es tu boleto.
¿Qué hace diferente a LocalAI?
El proyecto se describe a sí mismo como 'un núcleo pequeño, no un paquete'. En lugar de incluir todas las dependencias posibles en un solo binario gigante, LocalAI está diseñado para ser componible: cada backend envuelve un motor probado como llama.cpp, vLLM, whisper.cpp, stable-diffusion o MLX en su propia imagen de contenedor. Ese backend solo se descarga cuando un modelo realmente lo necesita. Esto significa que no instalas una montaña de software que nunca usarás, y puedes ampliar LocalAI con backends personalizados en cualquier idioma.
LocalAI también es un reemplazo directo para las APIs que ya conoces. Es compatible con la API de OpenAI, la API de Anthropic y la API de audio de ElevenLabs en todas sus modalidades. Así que si ya tienes código escrito para una API alojada y decides hacer la transición a local, normalmente todo lo que necesitas cambiar es la URL del endpoint.
La magia de no necesitar GPU
La mayoría de los modelos populares funcionan bien en CPU, pero más lento, y LocalAI admite aceleración por hardware cuando la tienes: NVIDIA (CUDA 12/13), AMD (ROCm), Intel (oneAPI), Apple Silicon (Metal), Vulkan e incluso dispositivos NVIDIA Jetson. Puedes comenzar con una laptop de CPU sola y luego pasar a una GPU más tarde sin cambiar tu flujo de trabajo. LocalAI también detecta automáticamente las capacidades de tu GPU y obtiene el backend correcto, por lo que no necesitas jugar con docenas de variables de entorno.
Instalación en diez segundos
Comenzar con LocalAI es realmente sencillo. La vía más rápida es Docker. Solo para CPU, ejecuta este comando de una sola línea:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
¿Tienes una GPU NVIDIA? Elige la imagen CUDA correspondiente y agrega --gpus all:
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13
Los fanáticos de AMD pueden usar la imagen HIPBLAS con un par de indicadores de dispositivo, mientras que los usuarios de Intel y Vulkan también tienen imágenes dedicadas. Si prefieres aplicaciones nativas, hay un DMG oficial para macOS; solo recuerda eliminar el atributo de cuarentena después de la instalación, ya que Apple no lo ha firmado. Encontrarás el comando exacto en el README del proyecto.
Cargando modelos: un comando, infinitas opciones
La forma más fácil de cargar un modelo es mediante la herramienta de línea de comandos integrada. LocalAI te da un comando para gobernarlos a todos:
local-ai run llama-3.2-1b-instruct:q4_k_m
Eso obtiene un modelo de la galería de modelos de LocalAI. Pero no estás limitado a esa galería. Puedes extraer modelos directamente de Hugging Face, el registro de Ollama o cualquier registro OCI estándar:
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
local-ai run ollama://gemma:2b
local-ai run oci://localai/phi-2:latest
Incluso puedes apuntar LocalAI a un archivo de configuración YAML para definir la configuración del modelo y la longitud de contexto exactamente como quieras.
Chatea con tu agente de terminal
Una vez que tu modelo esté cargado, hay un agente de terminal integrado experimental pero muy interesante. En lugar de caer en un REPL simple, este agente puede leer archivos, responder preguntas y ejecutar comandos en tu máquina. Pide aprobación antes de cambiar cualquier cosa, para que mantengas el control. En una terminal, inicia el servidor:
local-ai run llama-3.2-1b-instruct:q4_k_m
Luego abre otra consola y habla con él:
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
Mientras chateas, puedes escribir /models para ver los modelos instalados y /model <nombre> para cambiar entre ellos a mitad de la conversación. Es ingenioso, pero si no estás listo para dejar que una IA toque tu terminal, hay un servidor de chat estándar compatible con OpenAI ejecutándose en el puerto 8080 y puedes usar cualquier cliente que prefieras.
¿Qué puede hacer realmente LocalAI?
La lista de funciones de LocalAI es sinceramente abrumadora. En el lado del texto, obtienes generación de texto, embeddings, rerankers, una API de visión y herramientas compatibles con OpenAI. Para el habla, hay audio a texto, texto a audio, voz a voz en tiempo real con WebRTC, detección de actividad de voz e incluso diarización de hablantes. La generación de imágenes, la generación de video, la detección de objetos y la estimación de profundidad también están en el menú. Si necesitas salida estructurada, admite gramáticas restringidas y esquemas JSON.
La galería de backends incluye más de 60 backends. Algunos son motores nativos construidos por el equipo de LocalAI en C++/GGML, como parakeet.cpp para transcripción, voice-detect.cpp para reconocimiento de hablantes y free-splatter.cpp, que puede convertir un puñado de fotos en Gaussianas 3D sin GPU y sin poses de cámara. Estos no son solo envoltorios; son implementaciones en C++ desde cero sin inferencia de Python en el tiempo de ejecución, una hazaña impresionante para la portabilidad.
Los lanzamientos recientes agregaron modo distribuido con enrutamiento consciente de VRAM y autoescalado, soporte para MCP (Protocolo de Contexto de Modelo), gestión de cuotas multiusuario y ajuste fino (fine-tuning) directamente en la interfaz. En otras palabras, se está convirtiendo no solo en un ejecutor de modelos, sino en una plataforma completa para individuos y equipos.
La IA centrada en la privacidad finalmente es práctica
Hay una frase en el README de LocalAI que resume todo el atractivo: 'tus datos nunca salen de tu infraestructura'. Cuando ejecutas LocalAI, cada solicitud de API permanece en tus propias máquinas. Sin fugas de prompts, sin datos que entrenen el modelo de un extraño, sin dolores de cabeza de cumplimiento. Combinado con su soporte para ajuste fino y cuantización, puedes construir una pila de IA completamente privada que aún sigue estándares abiertos.
El proyecto tiene licencia MIT y es mantenido por Ettore Di Giacinto y una comunidad activa. Puedes explorar modelos en la galería de modelos de LocalAI o simplemente seguir la guía de inicio rápido en GitHub. Una vez que profundices, probablemente estarás de acuerdo: LocalAI es lo más cercano que tenemos a una forma universal, abierta y éticamente sensata de ejecutar IA en tus propios términos.
Artículos relacionados
Deep-Live-Cam 2.1.6: Intercambio de rostros en tiempo real con una sola foto
Descubre Deep-Live-Cam, la herramienta de código abierto que intercambia rostros en tiempo real con una sola imagen. Aprende a instalarlo y a usarlo de manera responsable.
Hermes Agent: la IA automejorable que aprende de cada tarea
Hermes Agent es un agente de IA de código abierto de Nous Research que aprende habilidades con el tiempo, recuerda tu contexto y puede ejecutarse en un teléfono, un portátil o un VPS de 5 dólares.
Humanizer: la herramienta de código abierto que hace que la escritura de IA suene humana
Humanizer reescribe el texto que suena a IA en prosa natural y humana utilizando 35 patrones de la página «Signos de escritura de IA» de Wikipedia. Así es como funciona, con ejemplos de antes y después y pasos de instalación.
Presentamos VoiceStudio: clonación de voz gratuita y local con 646 idiomas
VoiceStudio lleva a tu escritorio un estudio de voz gratuito, de código abierto y orientado a lo local. Clona cualquier voz con solo 3 segundos de audio y genera en 646 idiomas sin gastar ni un céntimo.