
NVIDIAs DGX Spark 64GB für 4.999 US-Dollar bringt einen Petaflop für Always-On-Agents auf den Schreibtisch
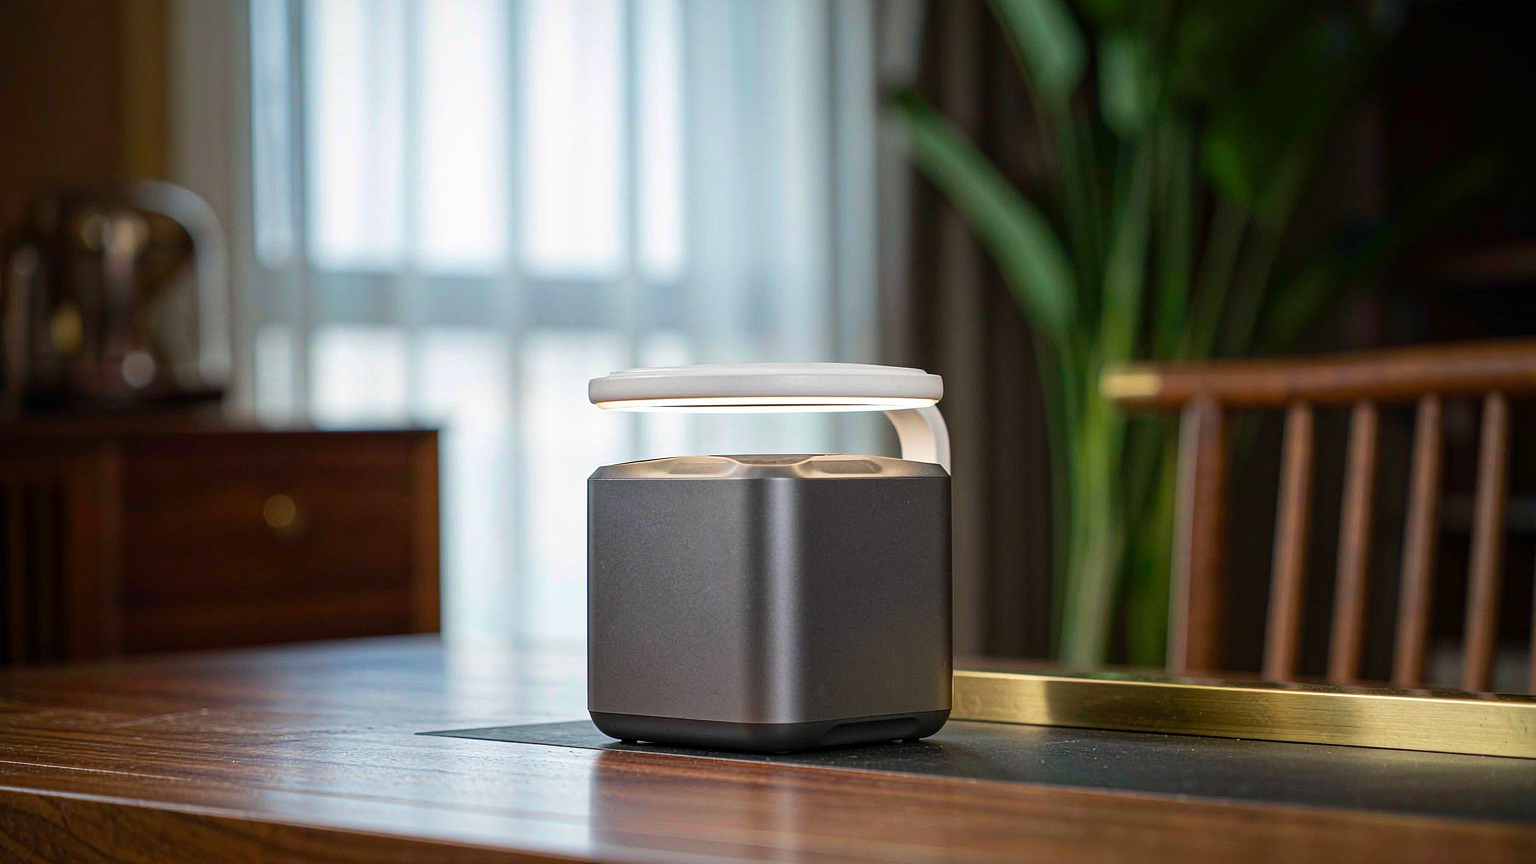
NVIDIA hat eine 64-GB-Version seines Desktop-KI-Computers DGX Spark bestätigt, ab 4.999 US-Dollar, mit Auslieferung ab dem 23. Oktober über Acer, Asus, Dell, Gigabyte, HP, MSI und H3C. Das 128-GB-Modell bleibt für 6.950 US-Dollar im Verkauf. Beide basieren auf dem GB10-Grace-Blackwell-Superchip, der eine Blackwell-GPU mit einer 20-Kern-Arm-CPU in einem Package verbindet und zwischen beiden einen gemeinsamen Pool aus LPDDR5X-Speicher teilt.
Die Architektur ist das Verkaufsargument. Kohärenter Unified Memory bedeutet, dass CPU und GPU denselben Adressraum sehen, sodass das Kopieren von Daten zwischen System-RAM und VRAM entfällt. Bei einer 64-GB-Box gehen rund 8 GB an das Betriebssystem, wodurch etwa 56 GB für Modellgewichte und den KV-Cache bleiben, der mit der Kontextlänge wächst. NVIDIA gibt den Chip mit bis zu einem Petaflop KI-Rechenleistung im FP4-Format an.
Was 64 GB tatsächlich ausführen
NVIDIA positioniert die 64-GB-Konfiguration für Modelle der 30B- bis 35B-Klasse: Qwen3.8-27B, Gemma 4 26B, Meta Muse Glimmer und Nemotron 3.5 Lightning. Mit NVFP4-Quantisierung, die laut NVIDIA die Genauigkeit erhält, kann eine Box Modelle mit bis zu etwa 100B Parametern bewältigen. Das ist der ganze Sinn der Maschine. Vor einem Jahr brauchten Modelle dieser Größenordnung ein Server-Rack. Jetzt passen sie in eine Box von der Größe eines großen Lunchpakets.
Der Kompromiss ist die Speicherbandbreite. Mit 273 GB/s ist der Spark nicht dafür gebaut, ein Chat-Produkt für hundert gleichzeitige Nutzer zu bedienen. Er ist für lange Eingaben und kurze Ausgaben gebaut: ein Repository, einen Log-Dump oder einen Stapel Dokumente lesen und ein kurzes Ergebnis schreiben. Diese Form passt gut zu Agents, denn ein Agent verbringt die meiste Zeit damit, Kontext zu lesen, und produziert nur gelegentlich eine Antwort.
Die Abstammungslinie hinter der Box
Der Spark ist nicht NVIDIAs erster Versuch, ernsthafte Rechenleistung unter einen Schreibtisch zu bringen. Die 128-GB-Version existierte bereits zu einem höheren Preis, und das 64-GB-Modell ist ein bewusster Schritt ins untere Marktsegment. Denselben GB10-Chip und dasselbe Unified-Memory-Design beizubehalten, während der Speicher halbiert wird, senkt die Einstiegskosten, ohne den Zweck der Maschine zu ändern. Das ist wichtig, weil das frühere Modell als Workstation bepreist war, und ein Workstation-Preis begrenzt, wer sich eine leisten kann.
Es gibt einen zweiten Grund, warum die 64-GB-Konfiguration jetzt und nicht vor einem Jahr sinnvoll ist. Die offenen Modelle, die in 56 GB passen, sind gut genug, um sie tatsächlich laufen zu lassen. Ein 27B-Modell mit quantisierten Gewichten und einem langen Kontextfenster kann echte Coding- und Rechercheaufgaben bewältigen statt Spielzeug-Prompts. Vor sechs Monaten bedeutete es, die entsprechende Fähigkeit lokal auszuführen, eine größere Box und eine höhere Rechnung. Die Hardware und die Modelle haben dieselbe Schwelle erreicht, und das macht die Preissenkung bedeutsam statt nur dekorativ.
Clustering ist eine erstklassige Funktion
Jeder DGX Spark wird mit einer ConnectX-7-Netzwerkkarte mit bis zu 200GbE ausgeliefert, und die kostenlose NVIDIA-Sync-App übernimmt die Einrichtung. Ihr Cluster Assistant konfiguriert das Netzwerk, sodass Sie bis zu vier Einheiten zusammenschließen können, ohne Netzwerkadministrator zu sein. Zwei 64-GB-Sparks bündeln sich zu 128 GB, und laut NVIDIA liefert das Paar bis zu 1,7-mal die Leistung eines einzelnen 128-GB-Modells, weil die kombinierte Rechenleistung und Bandbreite sich in etwa verdoppeln. Ein Direktkabel verbindet ein Paar; vier Einheiten benötigen einen Switch.
Der praktische Effekt ist eine gleitende Skala. Beginnen Sie mit einer Box zum Experimentieren, fügen Sie eine zweite für eine echte Workload hinzu und machen Sie weiter, bis die Workload die lokale Hardware übersteigt. Die Zeit bis zum ersten Token verbessert sich am stärksten, wenn Sie skalieren, und genau das zählt für Agents, die lange Eingaben lesen, bevor sie handeln.
Die Softwareebene ist der Ort, an dem die Agent-Story lebt
Der Spark wird mit DGX OS, dem CUDA-Stack und den üblichen Werkzeugen ausgeliefert: PyTorch, Jupyter, Ollama sowie abgestimmte Unterstützung für vLLM und llama.cpp. NVIDIA beansprucht mit seinen Optimierungen bis zu 1,9-mal schnellere lokale Agent-Inferenz. Außerdem ist OpenShell enthalten, Teil des NVIDIA Agent Toolkit, das richtlinienbasierte Grenzen dafür setzt, was ein Agent tun darf.
Das letzte Element knüpft an einen breiteren Trend an. Während Agents von der Demo in den Alltag übergehen, ist der Engpass nicht mehr das Modell, sondern die Zuverlässigkeit. Eine lokale Maschine, die einen Agent über Nacht laufen lässt, muss Tool-Aufrufe korrekt ausführen, sich von Fehlern erholen und nicht außerhalb ihres Bereichs wandern. NVIDIA setzt genau darauf: Der Spark zielt auf Always-On-Agents, nicht auf einmalige Prompts.
Perplexity hat sich bereits an die Hardware angepasst und liefert einen optimierten portablen Computer-Agent aus, der ein 118B-Modell lokal auf dem Gerät ausführen kann. Das ist ein bemerkenswertes Signal, denn Perplexity ist ein Cloud-First-Unternehmen. Wenn es für lokale Hardware entwickelt, erwartet es einen Markt von Nutzern, die das Modell auf ihrer eigenen Maschine haben wollen.
Für wen das gedacht ist – und für wen nicht
Der Preis von 4.999 US-Dollar platziert den Spark im professionellen Bereich, nicht im Consumer-Segment. Profitieren werden Forscher, unabhängige Entwickler und kleine Teams, die Agents oft genug ausführen, dass sich API-Gebühren pro Token summieren, oder die mit Daten arbeiten, die ihre eigene Hardware nicht verlassen dürfen. Das Fine-Tuning eines Coding-Modells auf einem privaten Repository, eine Day-One-Evaluierung eines neuen offenen Modells oder das gleichzeitige Vorhalten mehrerer Modelle sind alles Aufgaben, die zum Unified-Memory-Design passen.
Für alle anderen ist die Rechnung weniger klar. Wenn Sie KI ein paar Mal am Tag nutzen, sind Cloud-APIs billiger und einfacher. Der Spark ist sinnvoll, wenn Ihre Nutzung hoch ist, Ihre Daten sensibel sind oder Ihre Workload kontinuierlich läuft. Das 64-GB-Modell senkt den Einstiegspreis, ändert aber nichts an dieser Logik.
Ein Detail sollten alle beachten, die budgetieren. Die 56 GB nutzbarer Speicher müssen die Gewichte und den KV-Cache gemeinsam abdecken. Langer Kontext frisst Cache, und Agent-Workloads sind von Natur aus lang. Ein quantisiertes Modell, das technisch passt, kann trotzdem an die Grenze stoßen, sobald der Kontext wächst. Deshalb verweist NVIDIA auf den 17-GB-quantisierten Build eines größeren Modells als praktische Wahl gegenüber seiner 55-GB-Vollpräzisionsversion. Ein Modell passend zu machen und es gut auf einer langen Aufgabe laufen zu lassen, sind zwei verschiedene Tests.
Das größere Signal
Das Interessante an dieser Veröffentlichung ist nicht die Preissenkung. Es ist die Tatsache, dass ein 27B- oder 30B-Modell auf einem Desktop jetzt nah genug an dem Frontier-Verhalten von vor ein paar Monaten heranreicht, dass es sich lohnt, ein Produkt um die Maschine herum zu bauen. Die Hardware und die offenen Modelle sind am selben Punkt zusammengelaufen: eine Box unter einem Schreibtisch, die einen Agent ausführt, der arbeitet, während Sie schlafen, und bei der die Daten niemals das Gebäude verlassen.
NVIDIA wettet darauf, dass genügend Entwickler das wollen, um eine Produktlinie zu rechtfertigen. Die Liste der OEMs, die den Spark ausliefern, deutet darauf hin, dass das Unternehmen die Antwort für Ja hält – und dass die nächsten Jahre der KI-Arbeit nicht alle im Rechenzentrum stattfinden werden.
Verwandte Artikel
Agility Digit 5 kommt mit einem Sicherheitsnachweis, nicht nur mit einem Datenblatt
Eine Lagerhalle ist kein Labor. Die Zertifizierung ist die Hürde, nicht die Demo.
Frontier-Agenten schlossen 30 Prozent eines Forschungs-Workflows ab. Das ist die Zahl.
Agenten können Forschung ausführen. Das Erfinden der Prozedur ist noch außer Reichweite.
Figure AI sichert sich 3,5 Milliarden Dollar Compute, bevor es ein Produkt zu verkaufen gibt
Die Wette lautet, dass Generalisierung ein Compute-Problem ist. Das Feld hat das nicht abschließend geklärt.
OpenAI integriert endlich transparente Hintergründe in die Image API
Ein kleines Feature, das einen ganzen Schritt aus der Pipeline streicht.