
الحدود التالية للذكاء الاصطناعي هي تحويل صورة ثابتة واحدة إلى مشهد متحرك
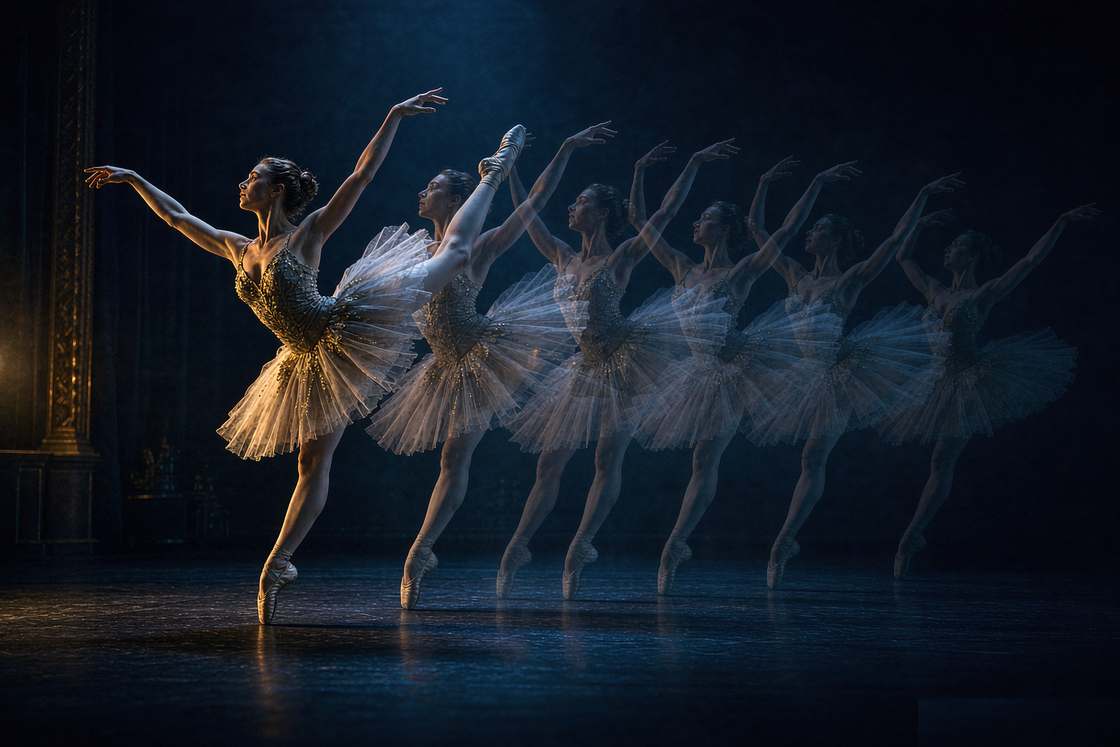
لقد أصبح توليد الصور جيداً بما يكفي لأن ينتقل الحديث إلى المرحلة التالية. الحدود الجديدة، التي تلاحقها الأدوات والباحثون هذا الموسم، هي الفيديو. وتحديداً، أخذ صورة ثابتة واحدة وجعلها تتحرك.
قد يبدو ذلك خطوة صغيرة، لكنه مشكلة تقنية مختلفة. نموذج الصور الانتشارية يحسّن الضوضاء إلى إطار واحد متماسك. أما الفيديو فيعني مئات الإطارات التي يجب أن تبقى متسقة مع بعضها بعضاً، ومع فيزياء الموضوع، ومع الصورة الأصلية. إذا أخطأت في ذلك، يذوب وجه الشخصية بعد ثلاث ثوانٍ.
هذا هو الاتجاه الذي تتجه إليه الطاقة في عام 2026، ومن المفيد أن نفهم ما هو ممكن فعلياً الآن، لأن الفجوة بين العرض التجريبي والأداة القابلة للاستخدام ما زالت هي جوهر اللعبة.
مشكلة الفيزياء، ولماذا كانت صعبة
أوضح طريقة لفهم سبب صعوبة ذلك هي النظر إلى ما تفعله أداة جيدة لتحويل الصورة إلى فيديو عندما تعمل.
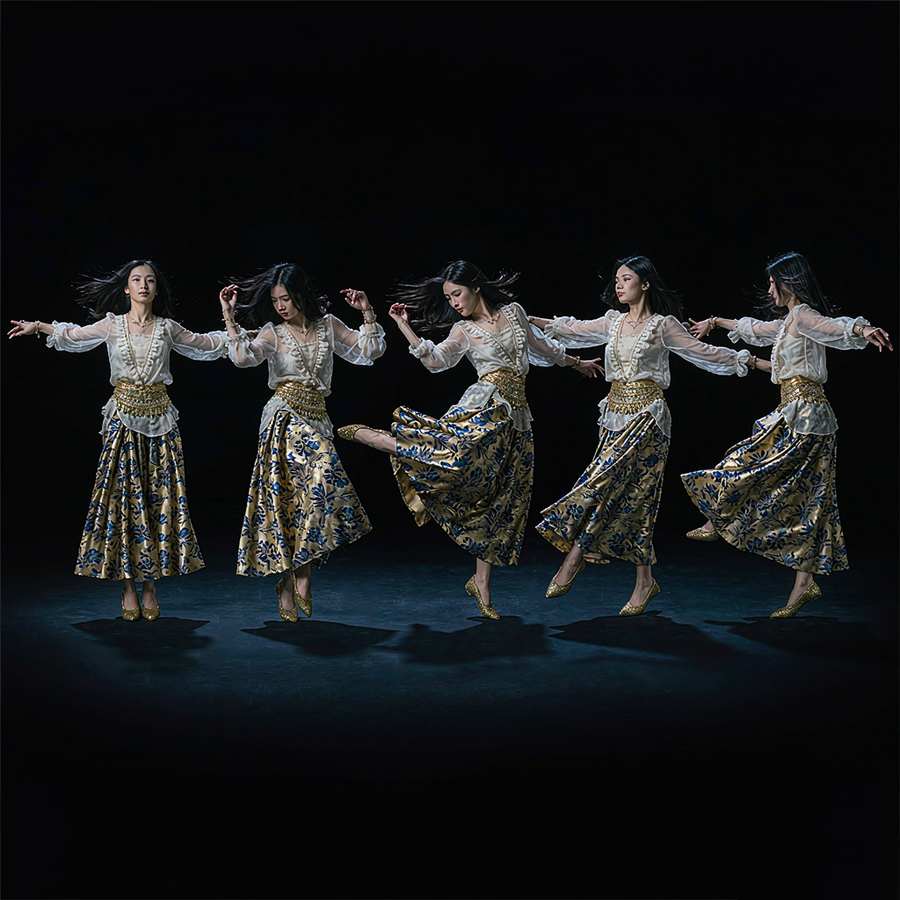
لنأخذ شخصية. الصورة الثابتة لشخص ما هي وضعية مجمّدة واحدة. لتحريك ذلك الشخص وهو يرقص أو يمشي أو يلوّح، يجب أن يفهم النموذج هندسة الجسم، وليس البكسلات فحسب. إذا اكتفى بنسخ الأنماط البصرية، تنزلق الأطراف، وتتشوه النسب، وستحصل على الحركة الذائبة الشبيهة بالدمى التي ميزت الأدوات الأولى.
أداة Viggle، التي اشتهرت بهذا الأمر تحديداً، بنت سمعتها على نهج مختلف. نموذجها JST-1 هو نموذج فيزياء ثلاثي الأبعاد وليس نموذج انتشار خالص. يعمل من خلال فهم هندسة الجسم، ولهذا تحافظ نسب الشخصية على تماسكها أثناء الرقصات السريعة والمعقدة حيث تميل المولدات التي تعمل إطاراً بإطار إلى الانهيار. يشغّل النموذج تحريك الشخصيات من صورة ثابتة واحدة، وأصبح الخيار الافتراضي لصنّاع الميمات وصنّاع المحتوى القصير الذين يريدون شخصية ترقص.
الجانب مفتوح المصدر يستيقظ
كان عالم المصادر المفتوحة أبطأ هنا، لأن تدريب توليد الفيديو مكلف. لكنه يتحرك.
أصدرت Viggle نموذج Viggle-Animate على Hugging Face في سبتمبر، وهو نموذج لتحويل الصورة إلى فيديو يهدف إلى استبدال الشخصيات وتحرير الفيديو، مستخلص من MiniMax-H3. الاستخلاص هو حيلة تدريب نموذج أصغر على إعادة إنتاج سلوك نموذج أصل أكبر، وهذا مهم عندما يكون الهدف استدلالاً أسرع وتكاليف حوسبة أقل. الإصدار ضيق النطاق، فهو لاستبدال الشخصيات وتحرير لقطات موجودة بدلاً من توليد مقاطع من الصفر، لكنه يضع أداة مخصصة في أيدي المطورين دون واجهة برمجة تطبيقات مغلقة.
هذا النمط يستحق المتابعة. كل مشكلة صعبة في الذكاء الاصطناعي تُفتح في النهاية، وكان تحرير الفيديو القائم على الشخصيات من أصعب المشكلات التي يمكن إبقاؤها مغلقة. الإصدار المفتوح خشن، والرخصة غير قياسية، لكنه إشارة إلى أن المنظومة مفتوحة المصدر تلحق بالأدوات المغلقة.
المشهد التجاري
على الجانب التجاري، قسّم المجال نفسه إلى تخصصات.
تسيطر Viggle على تحريك الشخصيات من الصور الثابتة. إنها ليست أداة فيديو عامة، ولا تتعامل مع المناظر الطبيعية أو المنتجات، لكنها لا تجد منافساً حقيقياً في جعل شخصية ترقص أو تتخذ وضعية من صورة واحدة. توفر الخطة المجانية خمسة مقاطع فيديو يومياً بعلامة مائية، وتضيف الخطط المدفوعة دقة أعلى وتزيل العلامة المائية.
تتصدر PixVerse من حيث التكلفة. تحوّل الصورة الثابتة الواحدة إلى مقطع قصير منمق، مع تحكم في إطار البداية والنهاية حتى تتمكن من توجيه الحركة بين إطارين رئيسيين، كما تملك كتالوجاً كبيراً من التأثيرات الفيروسية بنقرة واحدة. المقابل هو مقاطع قصيرة وضعف في الاتساق السردي.
أما Runway وKling فتجلسان في نهاية الإنتاج لمن يحتاجون تحكماً متعدد المشاهد وعمل كاميرا. ويواصل صانعو النماذج أنفسهم، OpenAI وGoogle وxAI، دفع نماذج الفيديو إلى الأمام، مع دمج قدرة «صورة واحدة إلى فيديو» بشكل متزايد في التطبيقات الرئيسية بدلاً من بيعها كمنتج منفصل.
كيف تستخدم هذه الأدوات فعلياً دون إضاعة وقتك
الأشخاص الذين يحصلون على قيمة حقيقية من تحويل الصورة إلى فيديو حالياً يتشاركون عادات قليلة، وتستحق التقليد.
ابدأ بصورة ثابتة جيدة. لا يستطيع التحريك إصلاح صورة مصدر رديئة. إذا كانت الشخصية ضبابية أو بعيدة عن المركز أو في وضعية غريبة، فسيكون الفيديو ضبابياً وبعيداً عن المركز وفي وضعية غريبة أيضاً أثناء الحركة. أولاً، أنشئ أو اختر صورة ثابتة نظيفة ومضاءة جيداً، وعندها سيكون لدى التحريك شيء يعمل به.
صمم وفقاً لحد المقطع. معظم هذه الأدوات لها حد أقصى يتراوح بين عشر وخمس عشرة ثانية، وأفضل النتائج تبقى داخل هذا الحد بوضوح. خطط لحلقة أو خطّاف أو لقطة إيقاع واحدة بدلاً من مشهد كامل. محاولة تمديد أداة واحدة إلى ما يتجاوز قدراتها هي الطريقة التي ستنتهي بها إلى الإطارات الذائبة التي رآها الجميع.
استخدم الإطارات الرئيسية عندما توفرها الأداة. تتيح لك PixVerse وغيرها ضبط إطار بداية وإطار نهاية، ما يمنح النموذج نقطتي ارتكاز يقحم بينهما. هذه العادة وحدها تزيل معظم الانجراف وتجعل الحركة تبدو مقصودة بدلاً من عشوائية.
وكن صادقاً بشأن الناتج. هذه الأدوات أقوى ما تكون في المحتوى المنمق أو القائم على الشخصيات أو لقطات المنتجات الدوارة. إنها ليست بديلاً بعد عن اللقطات الحقيقية عندما تكون الواقعية والثقة مهمتين. بالنسبة لميم أو منشور اجتماعي أو حلقة منتج، فهي جاهزة. أما لأي شيء يجب أن يبدو وكأنه تم تصويره، فهي ليست كذلك.
المبدعون الذين يزدهرون مع تحويل الصورة إلى فيديو هم من يتعاملون معها كنوع جديد من الكاميرا، بحدودها الخاصة، بدلاً من نسخة أرخص من الكاميرا القديمة. تعلم الحدود وصوّر داخلها، وستصبح الصورة الثابتة الواحدة لوحة واسعة بشكل مفاجئ.
ما هو قابل للاستخدام فعلياً اليوم
النسخة الصادقة هي أن تحويل الصورة إلى فيديو عبر من مرحلة «عرض تجريبي» إلى «مفيد للمقاطع القصيرة»، لكنه لم يعبر إلى «جاهز للإنتاج للمحتوى الطويل».
بالنسبة لحلقة مدتها عشر ثوانٍ لشخصية ترقص، أو منشور اجتماعي منمق، أو لقطة منتج دوّار لإعلان، فالأدوات جيدة بما يكفي لأن تستحق النتيجة الجهد. أما لأي شيء يحتاج استمرارية سردية، أو عملاً متسقاً بالكاميرا، أو دقيقة كاملة من اللقطات المتماسكة، فإن الأدوات لا تزال تنهار.
ليس هذا انتقاصاً. إنه فقط موضع التقنية الحالي. الأشخاص الذين يحصلون على قيمة من تحويل الصورة إلى فيديو حالياً هم من يحترمون حد طول المقطع ويصممون حوله بدلاً من مقاومته.
لكن الحدود حقيقية. لقد كان القطاع واضحاً في أن التوليد ثلاثي الأبعاد وتحريك الفيديو من صور مفردة هما الخطوة الكبرى التالية، ومن المتوقع أن تنضجا خلال العام أو العامين المقبلين. إن تقارب الأدوات المفتوحة والمغلقة الآن على تحريك الشخصيات من صورة ثابتة واحدة يعني أن الجزء الأصعب، أي فيزياء الحركة، يُعامل أخيراً كمشكلة هندسية قابلة للحل وليس كفضول بحثي.
مقالات ذات صلة
إعادة بناء منظومة أدوات توليد الصور بالذكاء الاصطناعي مفتوحة المصدر، سير عمل تلو الآخر
يعيد Workflow1111 إنشاء AUTOMATIC1111 بـ 73 عقدة و11 خط أنابيب. ماذا تعني إعادة البناء المجتمعية لتوليد الصور محليًا.
الأرقام وراء توليد الصور بالذكاء الاصطناعي: انخفاض الأسعار بنسبة 99% التهم صور الستوك
حجم السوق، واضطراب صور ستوك، وأرقام الاعتماد، وسير العمل الهجين، مشروحة من خلال الإحصاءات.
GPT Image 2 في مواجهة Nano Banana Pro: صراع 2026 الذي لا يتفق حوله أحد
السرعة والنص في مقابل الدقة والاتساق: مقارنة موثوقة بين GPT Image 2 وNano Banana Pro في 2026.
Flux 2 مقابل Stable Diffusion 3.5: سباق الصور مفتوحة المصدر له متصدر واضح
يتصدر Flux 2 في الجودة، ويحتفظ Stable Diffusion 3.5 بأعمق نظام بيئي. كيف تختار بينهما في 2026.