
DGX Spark 64GB من NVIDIA بسعر 4,999 دولار: بيتافلوب على المكتب لوكلاء يعملون على مدار الساعة
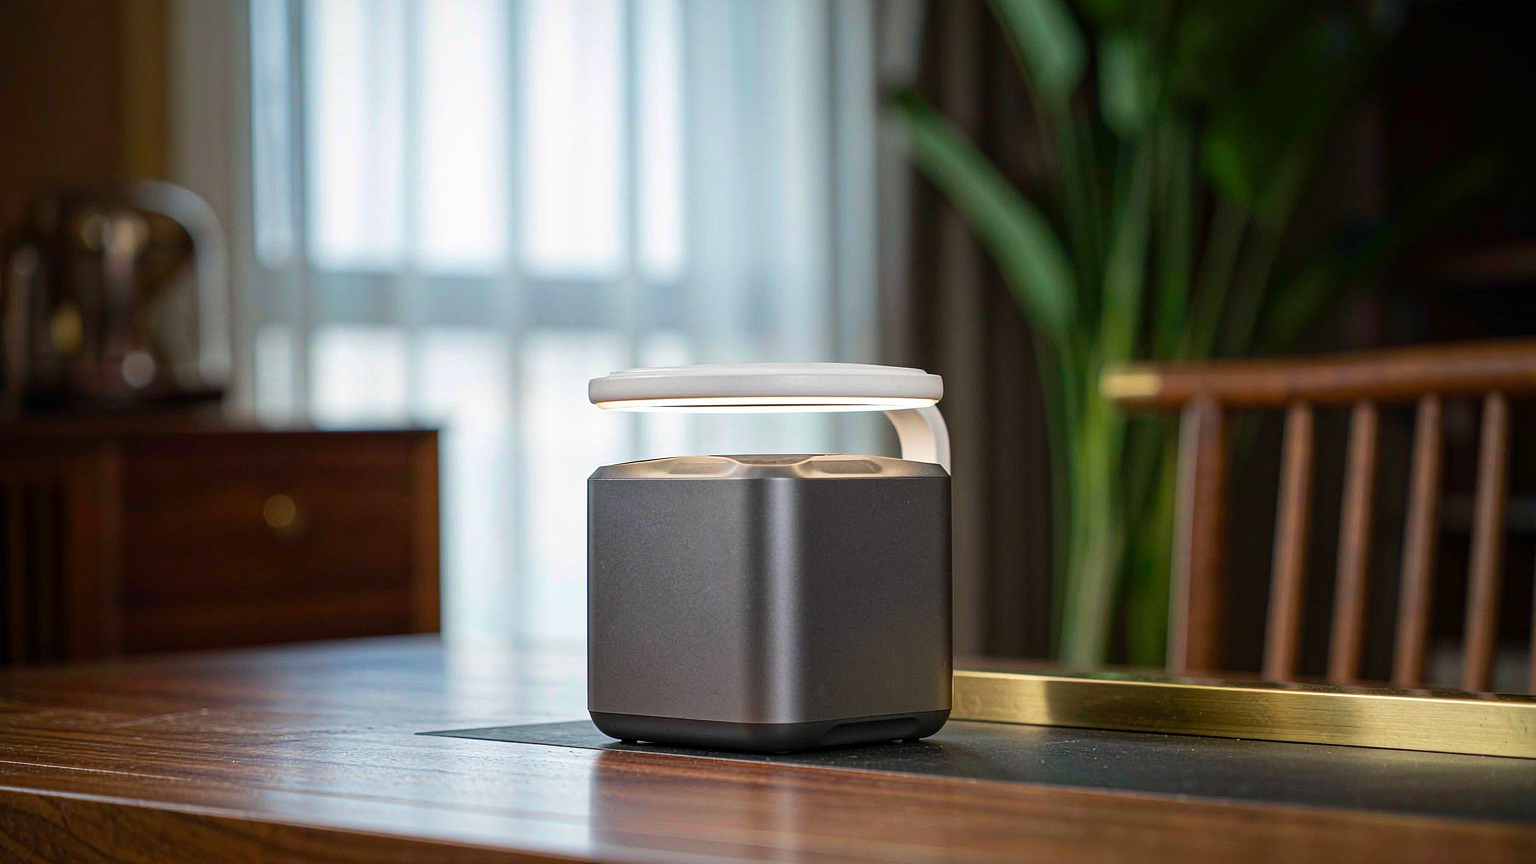
أكدت NVIDIA إصدارًا بسعة 64 غيغابايت من حاسوبها المكتبي للذكاء الاصطناعي DGX Spark، بسعر يبدأ من 4,999 دولارًا، ويُشحن في 23 أكتوبر عبر Acer وAsus وDell وGigabyte وHP وMSI وH3C. ويظل طراز 128 غيغابايت معروضًا للبيع بسعر 6,950 دولارًا. كلا الطرازين مبنيان على شريحة GB10 Grace Blackwell الفائقة، التي تجمع وحدة معالجة رسومات Blackwell مع معالج Arm بـ20 نواة في حزمة واحدة، ويتشاركان مخزنًا واحدًا لذاكرة LPDDR5X.
البنية هي نقطة البيع الأساسية. تعني الذاكرة الموحدة المتماسكة أن وحدة المعالجة المركزية ووحدة معالجة الرسومات ترى مساحة العناوين نفسها، لذا تتوقف عن نسخ البيانات بين ذاكرة النظام RAM وذاكرة الرسومات VRAM. في جهاز بسعة 64 غيغابايت، يذهب نحو 8 غيغابايت إلى نظام التشغيل، ما يترك حوالي 56 غيغابايت لأوزان النموذج وذاكرة KV cache التي تنمو مع طول السياق. وتقيّم NVIDIA الشريحة بما يصل إلى بيتافلوب واحد من حساب الذكاء الاصطناعي بصيغة FP4.
ما الذي يشغّله 64 غيغابايت فعليًا
تضع NVIDIA تكوين 64 غيغابايت في فئة النماذج من 30B إلى 35B: Qwen3.8-27B وGemma 4 26B وMeta Muse Glimmer وNemotron 3.5 Lightning. مع تكميم NVFP4، الذي تقول NVIDIA إنه يحافظ على الدقة، يمكن لجهاز واحد التعامل مع نماذج تصل إلى نحو 100B معامل. هذا هو بيت القصيد من الجهاز. قبل عام، كانت النماذج عند هذا المستوى تحتاج إلى رف خوادم. الآن تتسع في صندوق بحجم علبة غداء كبيرة.
المقايضة هي عرض النطاق الترددي للذاكرة. عند 273GB/s، لم يُبنَ Spark لخدمة منتج دردشة لمئة مستخدم متزامن. بل بُني للمدخلات الطويلة والمخرجات القصيرة: قراءة مستودع برمجي، أو تفريغ سجلات، أو كومة من المستندات، وكتابة نتيجة قصيرة. هذا الشكل يناسب الوكلاء جيدًا، لأن الوكيل يقضي معظم وقته في قراءة السياق ولا يُنتج إجابة إلا أحيانًا.
الخط التقني الذي يقف خلف الجهاز
ليست Spark أول محاولة من NVIDIA لوضع حوسبة جادة تحت المكتب. فقد وُجد إصدار 128 غيغابايت بالفعل بسعر أعلى، ويعدّ طراز 64 غيغابايت خطوة مدروسة نحو الشريحة الأدنى من السوق. فالإبقاء على شريحة GB10 نفسها وتصميم الذاكرة الموحدة نفسه مع خفض الذاكرة إلى النصف يقلل تكلفة الدخول دون تغيير الغرض من الجهاز. وهذا مهم لأن الطراز السابق كان مسعّرًا كجهاز محطة عمل، وسعر محطة العمل يحد من الفئة القادرة على شرائه.
هناك سبب ثانٍ يجعل تكوين 64 غيغابايت منطقيًا الآن وليس قبل عام. فالنماذج المفتوحة التي تتسع في 56 غيغابايت أصبحت جيدة بما يكفي لتستحق التشغيل. يمكن لنموذج 27B بأوزان مكممة ونافذة سياق طويلة التعامل مع مهام برمجية وبحثية حقيقية بدلًا من مطالبات تافهة. قبل ستة أشهر، كان تشغيل قدرة مكافئة محليًا يعني جهازًا أكبر وفاتورة أكبر. لقد وصلت العتاد والنماذج إلى العتبة نفسها، وهذا ما يجعل خفض السعر ذا معنى وليس مجرد زينة.
التجميع العنقودي ميزة أساسية
يأتي كل DGX Spark مزودًا ببطاقة شبكة ConnectX-7 تعمل بسرعة تصل إلى 200GbE، ويتولى تطبيق NVIDIA Sync المجاني عملية الإعداد. ويقوم Cluster Assistant الخاص به بتهيئة الشبكة كي تتمكن من ضم ما يصل إلى أربع وحدات دون أن تكون مسؤول شبكات. يتحد اثنان من أجهزة Spark بسعة 64 غيغابايت ليصبحا 128 غيغابايت، وتقول NVIDIA إن هذا الثنائي يقدم أداءً يصل إلى 1.7 ضعف أداء طراز واحد بسعة 128 غيغابايت، لأن الحوسبة وعرض النطاق الترددي المجمعين يتضاعفان تقريبًا. يوصل كابل مباشر بين جهازين؛ أما أربع وحدات فتحتاج إلى مبدل شبكة.
الأثر العملي هو مقياس متدرج. ابدأ بجهاز واحد للتجربة، وأضف ثانيًا لعبء عمل حقيقي، واستمر حتى يتجاوز عبء العمل العتاد المحلي. يتحسن زمن الوصول إلى أول token أكثر ما يتحسن عند التوسع، وهو ما يهم الوكلاء الذين يقرؤون مدخلات طويلة قبل التصرف.
طبقة البرمجيات هي حيث تكمن قصة الوكلاء
يأتي Spark مزودًا بنظام DGX OS، وحزمة CUDA، والأدوات المعتادة: PyTorch وJupyter وOllama، إضافة إلى دعم محسّن لـ vLLM وllama.cpp. وتزعم NVIDIA أن تحسيناتها تجعل استدلال الوكيل المحلي أسرع بما يصل إلى 1.9 ضعف. كما يتضمن OpenShell، وهو جزء من NVIDIA Agent Toolkit، الذي يضع حدودًا قائمة على السياسات لما يمكن للوكيل فعله.
يتصل هذا الجزء الأخير باتجاه أوسع. فمع انتقال الوكلاء من العرض التوضيحي إلى الاستخدام اليومي، تتوقف عنق الزجاجة عند النموذج وتصبح الموثوقية. تحتاج آلة محلية تشغّل وكيلًا طوال الليل إلى إجراء استدعاءات الأدوات بشكل صحيح، والتعافي من الأعطال، وعدم الخروج عن نطاقها. وتستند NVIDIA إلى هذا بالضبط: فـ Spark موجه للوكلاء العاملين باستمرار، لا للمطالبات العابرة.
لقد تكيّفت Perplexity بالفعل مع هذا العتاد، إذ طرحت وكيل حاسوب محمول محسّنًا يمكنه تشغيل نموذج 118B محليًا على الجهاز. هذه إشارة جديرة بالملاحظة، لأن Perplexity شركة تضع السحابة أولًا. وإذا كانت تبني للعتاد المحلي، فهي تتوقع سوقًا من المستخدمين الذين يريدون النموذج على أجهزتهم الخاصة.
لمن هذا الجهاز، ولمن ليس
يضع سعر 4,999 دولار جهاز Spark في نطاق الاحتراف، لا في نطاق المستهلك. المستفيدون هم الباحثون والمطورون المستقلون والفرق الصغيرة التي تشغّل الوكلاء كثيرًا بما يكفي لتتراكم رسوم API لكل token، أو التي تتعامل مع بيانات لا يمكن أن تخرج من عتادها الخاص. فضبط نموذج برمجي على مستودع خاص، أو تشغيل تقييم اليوم الأول لنموذج مفتوح جديد، أو إبقاء عدة نماذج محمّلة في الذاكرة في وقت واحد، كلها مهام تناسب تصميم الذاكرة الموحدة.
أما بالنسبة للآخرين، فالحساب أقل وضوحًا. إذا كنت تستخدم الذكاء الاصطناعي بضع مرات في اليوم، فإن واجهات API السحابية أرخص وأبسط. يصبح Spark منطقيًا عندما يكون استخدامك مرتفعًا، أو بياناتك حساسة، أو عبء عملك يعمل باستمرار. يخفض طراز 64 غيغابايت سعر الدخول لكنه لا يغير هذا المنطق.
هناك تفصيل يستحق الإشارة لأي شخص يضع ميزانية. يجب أن تغطي الـ56 غيغابايت من الذاكرة القابلة للاستخدام الأوزان وذاكرة KV cache معًا. السياق الطويل يلتهم ذاكرة التخزين المؤقت، وأعباء عمل الوكلاء طويلة بطبيعتها. النموذج المكمم الذي يتسع نظريًا قد يصطدم بالحد بمجرد نمو السياق، ولهذا تشير NVIDIA إلى النسخة المكممة بحجم 17 غيغابايت من نموذج أكبر باعتبارها الخيار العملي مقابل نسخته كاملة الدقة بحجم 55 غيغابايت. فاستيعاب نموذج وتشغيله جيدًا في مهمة طويلة اختباران مختلفان.
الإشارة الأكبر
الجزء المثير في هذا الإطلاق ليس خفض السعر. بل إن نموذجًا بحجم 27B أو 30B يعمل على حاسوب مكتبي أصبح قريبًا بما يكفي من سلوك النماذج الرائدة قبل بضعة أشهر، لدرجة أن الآلة تستحق بناء منتج حولها. لقد تقارب العتاد والنماذج المفتوحة عند النقطة نفسها: صندوق تحت مكتب، يشغّل وكيلًا يعمل بينما تنام، مع بيانات لا تغادر المبنى أبدًا.
تراهن NVIDIA على أن عددًا كافيًا من المطورين يريد ذلك بما يبرر خط إنتاج كامل. وتشير قائمة مصنّعي المعدات الأصلية (OEM) الذين يشحنون Spark إلى أنها تعتقد أن الجواب نعم، وأن السنوات القليلة القادمة من العمل في الذكاء الاصطناعي لن تحدث كلها في مركز بيانات.
مقالات ذات صلة
روبوت شبه بشري بعجلات أنهى ساعة من غسيل الملابس دون مساعدة
قد تنجح المهام الفردية بينما يفشل سير العمل ككل. غيّرت Dyna المقياس.
LTX 2.5 يريد تصيير مسودتك المتكتلة من Blender إلى لقطة نهائية
أنت لا تتحكم في ما يحدث في التوليد من النص إلى الفيديو. هذه الأداة تحاول إصلاح ذلك.
ServiceNow تحوّل إخفاقات الوكلاء إلى بيانات تدريب
التوليد دون تحقق ضجيج. والبوابات هي المنتج.
إطار واحد للغة والرؤية: نموذج هورايزن المفتوح بحجم 1.6 مليار
رهان على أن الجسور بين اللغة والرؤية لم تكن مطلوبة قط.