
Qwen Image 2.1:为何一个 7B 开放权重模型正让 Nano Banana 2.0 倍感压力
当阿里巴巴悄然发布 Qwen Image 2.1 时,纸面上的数字看起来平平无奇。七十亿参数。开放权重。又一周,又一个模型。随后基准测试结果出炉,Tom's Hardware 的一篇报道称,这个小模型在多项图像基准测试中击败了谷歌的 Nano Banana 2.0,同时与 OpenAI 和 Meta 的产品相比也保持竞争力。Hacker News 上一个关于 Qwen 官方博客文章的帖子获得了 739 分和近 200 条评论,这种流量可不是一次常规模型发布能得到的。
这里有些东西正在发生,值得深入拆解,因为有趣之处不在于谁登上了排行榜榜首,而更多在于图像生成正走向何方。
小模型,硬核输出
参数规模才是关键。大多数前沿图像模型都在数百亿参数级别。一个基准测试表现有竞争力的 7B 模型,会改变任何在自己硬件上运行推理的人的计算。在一台 RTX 5090 上,你可以不用任何量化就运行完整的 BF16 去噪器。在一台配备 M1 Max 和 32 GB 内存的 MacBook Pro 上,一位开发者让文生图和图像编辑在 Apple Silicon 上原生运行,512x512 输出大约耗时 24 秒,并把演示发到了 r/StableDiffusion。这不是在笔记本上跑出数据中心级性能。这是一个爱好者在为视频剪辑而买的机器上,运行一个据称可与最好的闭源系统匹敌的模型。
社区移植在几天内接踵而至。有人为 TensorSharp 添加了 Qwen-Image 2.1 支持,带有 GGUF 量化和 LoRA 配置,还包括更快的草稿变体,将生成步骤缩减到区区几步。另一位开发者围绕它构建了一个 Fooocus 风格的 Gradio 工作室,支持蒙版、标注、外绘、OpenPose 参考和草图作为输入。模式一再重复:当权重开放时,生态会构建官方团队始终没空做的工具。
对基准测试持怀疑态度是健康的
当然,厂商的基准测试值得怀疑,Hacker News 的评论者也没让人失望。老生常谈的告诫依然适用:基准测试的选择很重要,提示词集很重要,而且“击败 Nano Banana”在很大程度上取决于你衡量的是哪些任务。一份公开贴出的、将 Qwen Image 2.1 与 Krea 2 进行 192 张图像并排对比、并按类别排序的结果,正是那种比新闻稿更能解决这些争论的群众验证。运行这项对比的人不得不把文本编码器量化到 NF4 以适应内存预算,这本身就说明基准测试条件与真实配置之间存在差距。
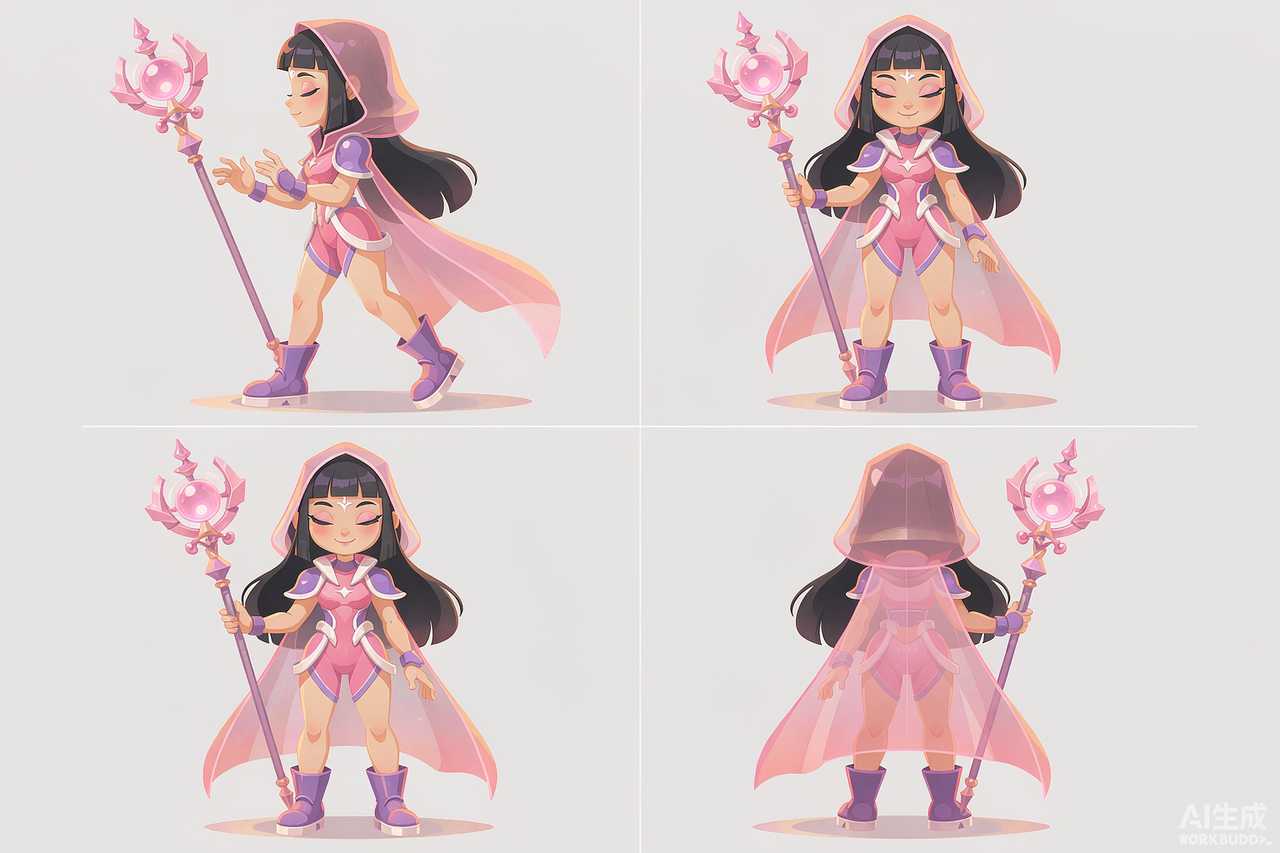
文本渲染仍然是最受关注的能力之一,而 Qwen 模型历来在 CJK 文字以及英文上都表现出色。编辑是另一条战线。r/StableDiffusion 上一篇展示用 Qwen 的编辑模式、无需任何 LoRA 生成角色设计表的帖子引起了关注,因为这种工作流过去需要一堆微调模型和一整个周末的 ComfyUI 连线。
为什么这不止关乎一个模型
这里可以看到两股更大的潮流。第一,开放权重社区有了新的默认选择。在很长一段时间里,本地生成意味着 Stable Diffusion 衍生模型和 Flux 变体,并且不断寻找“最不差”的检查点。Qwen Image 2.1 内置现代编辑能力,直接切入了这个生态,而工具几乎立刻跟进。第二股潮流是地理性的。r/singularity 上另一个标题为“中国 AI 模型在全球人气飙升——华盛顿感到担忧”的帖子引发了大量讨论,恰恰是因为像这样的模型不断在用户自己运行、而非厂商委托的偏好测试中名列前茅。
对于现在要挑选日常主力工具的人来说,实际结论很直接。如果你想要托管 API 带来的绝对最佳编辑质量,闭源领先者仍然物有所值。如果你想要一个可以自己运行、微调、量化,并接入自己的流水线而无需请求许可的模型,那么这个 7B 竞争者很难被忽视。如果你只是好奇,权重就在 Hugging Face 上。在一台两年前的笔记本上用 24 秒完成第一次实验,门槛低得不能再低。
编辑成为新战场
最具影响力的功能根本不是文生图。而是编辑。早期的图像模型把修改当作一个独立问题:局部重绘这个区域,接上 ControlNet,祈祷接缝消失。Qwen Image 2.1 将编辑视为原生模式,同一个会画画的模型也能重画。r/StableDiffusion 上流传的一个演示展示了角色设计表——同一角色在不同姿势和服装下的多个一致视图——无需任何 LoRA,也无需参考图绑定。一年前尝试过这种工作流的人都知道代价:每个角色都要微调一次,花数小时画蒙版,结果还会在不同角度之间漂移。
编辑也是商业价值集中的地方。营销团队要的不是图像;他们要的是自己的图像,经过调整。一张换了背景的产品图。一张用不同语言重新生成标题的海报。原生编辑压缩了这条流水线,而它如今存在于一个可下载的模型中,这意味着这种压缩会惠及那些永远不会为 API 付费的人。
社区工具反映了这一点。TensorSharp 移植版从第一天起就附带编辑配置,而不是后来补上的附加项。Fooocus 风格的工作室把蒙版、标注、外绘和姿势参考暴露为一等输入。当移植者把编辑当作核心功能而非附赠品时,这就是市场在对什么重要进行投票。
社区如何真正检验说法
在有人复现之前,厂商的基准测试就是营销,所以这个月更有意思的产物是群众性的。那份用相同提示词生成、按类别排序的 192 张图像 Qwen 对 Krea 2 对比,才是真正能解决争论的形式。它和盲测有同样的优点:没有人的排名能在与它接触后原封不动地存活。一个模型占优的类别一眼可见,两个模型都失败的类别同样如此。
Hacker News 尽了自己的一份力,拒绝照单全收标题。发布帖和 Tom's Hardware 投稿的评论区都追问了那些常见的软肋:用的是哪套基准测试,谁的提示词集,在测试分布之外会发生什么。这种怀疑是开放权重社区的免疫系统,也是为什么在那里存活下来的说法有分量。Qwen Image 2.1 目前的声誉,与其说建立在阿里巴巴的数字上,不如说建立在数百人运行了它,而且大多数人没有发羞辱帖这一事实上。
“足够好”与开放的经济学
有一种超越模型质量的商业解读。托管图像生成的定价对标的是前沿,而前沿的运营成本高昂。一个以电费为代价就能提供前沿大部分质量的 7B 模型,会改变客户愿意支付多少。它也会改变开发者构建所依赖的基础:一个权重稳定的开放模型可以被固定版本、微调,并打包进产品发布,而无需谈判 API 协议或担心被弃用。
最后一点值得强调,因为业界刚刚提供了一个实例教训。OpenAI 在 8 月底退役了独立的 DALL·E 产品,将图像生成并入 ChatGPT Images。技术上没有损失什么,但所有基于旧接口构建的集成都不得不按别人的时间表迁移。开放权重不会给你发那封邮件。
这一切并不能让 Qwen Image 2.1 成为世界上最好的图像模型。它造就的可以说是更具颠覆性的东西:一个普通人能够完全拥有的最好图像模型。排行榜之争反正会被下一次发布、再下一次发布解决。所有权转移才是持久的部分。
另一个需要内化的东西是节奏。正如一位 r/PromptEngineering 发帖者最近统计的,单月二十多个图像模型发布,意味着任何“最佳模型”的说法保质期都以周计。Qwen Image 2.1 是目前“小而开放”能让“大而闭源”难堪的证明。过一个月,有趣的问题就会变成什么会取代它。
相关文章
中国 AI 图像模型正在海外赢得拥趸,华盛顿也在关注
这种采用首先是技术性的,其次才是政治性的。开发者下载有效的东西,而目前有效的东西越来越多来自中国实验室。
预测市场正在就AI图像押注什么
真金白银正在押注谁将赢得AI图像。OpenAI在静态图上领先,MiniMax在视频上领先,而开源模型是无人定价的变数。
Qwen-Image 2.1 对比 Nano Banana 2.0:7B 开源模型已逼近谷歌
一个 70 亿参数的开源模型如今在阿里基准上领先于谷歌的 Nano Banana 2.0,并在其他方面都近在咫尺。
中国图像模型正在走向全球,而本月讨论风向变了
中国图像模型正在走向全球。基准测试、评论区和华盛顿的讨论本月如何发生变化。