
Qwen Image 2.1 : pourquoi un modèle à poids ouverts de 7B tient tête à Nano Banana 2.0
Lorsqu'Alibaba a discrètement publié Qwen Image 2.1, les chiffres clés semblaient anodins. Sept milliards de paramètres. Poids ouverts. Une semaine de plus, un modèle de plus. Puis les benchmarks sont arrivés, et un rapport de Tom's Hardware a affirmé que le petit modèle surpassait Nano Banana 2.0 de Google sur plusieurs benchmarks d'images tout en restant compétitif face aux offres d'OpenAI et de Meta. Un fil Hacker News sur l'article de blog officiel de Qwen a récolté 739 points et près de 200 commentaires, un type de trafic qu'une sortie de modèle routinière n'obtient pas.
Quelque chose se passe ici, et cela vaut la peine d'être décortiqué, car la partie intéressante concerne moins qui domine un classement que la direction que prend la génération d'images.
Des petits modèles, des résultats sérieux
Le nombre de paramètres est l'élément clé. La plupart des modèles d'images de pointe se situent dans les dizaines de milliards. Un modèle de 7B qui obtient des résultats compétitifs aux benchmarks change la donne pour quiconque exécute l'inférence sur son propre matériel. Sur une RTX 5090, vous pouvez exécuter le denoiser BF16 complet sans rien quantifier. Sur un MacBook Pro avec une M1 Max et 32 Go de mémoire, un développeur a réussi à faire tourner la génération texte-image et l'édition d'images nativement sur Apple Silicon en environ 24 secondes pour une sortie 512x512, et a publié la démo sur r/StableDiffusion. Ce n'est pas une performance de centre de données sur un ordinateur portable. C'est un amateur qui exécute un modèle qui rivaliserait prétendument avec les meilleurs systèmes fermés, sur une machine achetée pour le montage vidéo.
Les ports communautaires ont suivi en quelques jours. Quelqu'un a ajouté la prise en charge de Qwen-Image 2.1 à TensorSharp avec quantification GGUF et configurations LoRA, y compris des variantes de brouillon plus rapides qui réduisent la génération à une poignée d'étapes. Un autre développeur a construit un studio Gradio de style Fooocus autour de celui-ci, avec des masques, des annotations, de l'outpainting, des références OpenPose et des croquis comme entrées. Le schéma se répète : lorsque les poids sont ouverts, l'écosystème construit les outils que l'équipe officielle ne prend jamais le temps de créer.
Le scepticisme à l'égard des benchmarks est sain
Bien sûr, les benchmarks des fournisseurs méritent la méfiance, et les commentateurs de Hacker News n'ont pas déçu. Les mises en garde habituelles s'appliquent : le choix des benchmarks compte, les ensembles de prompts comptent, et « bat Nano Banana » dépend fortement des tâches que vous mesurez. Une comparaison côte à côte de 192 images de Qwen Image 2.1 contre Krea 2, triée par catégorie et publiée publiquement, est exactement le type de vérification par la communauté qui tranche ces débats mieux que les communiqués de presse. La personne qui l'a réalisée a dû quantifier l'encodeur de texte en NF4 pour respecter son budget mémoire, ce qui en dit long sur l'écart entre les conditions de benchmark et les configurations réelles.
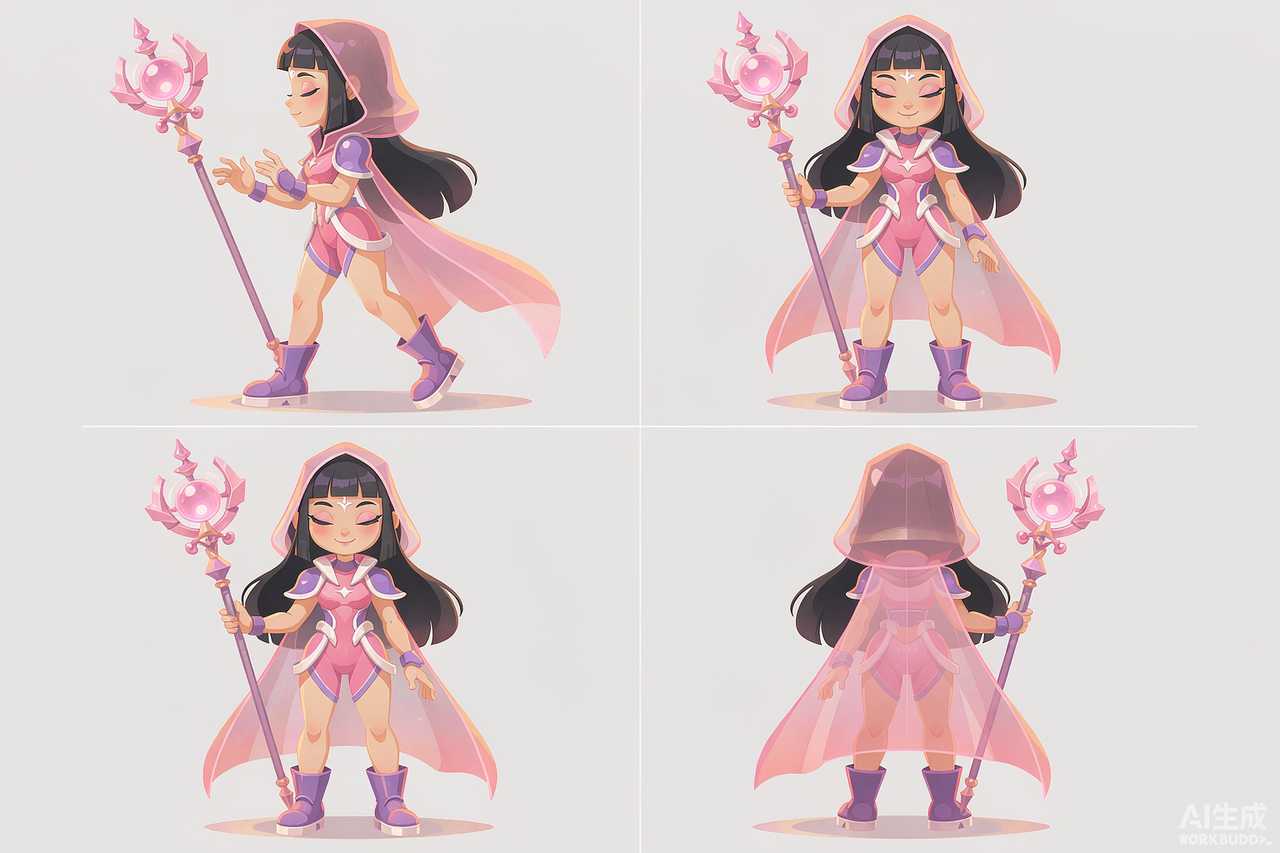
Le rendu de texte reste l'une des capacités les plus surveillées, et c'est là que les modèles Qwen ont historiquement bien performé pour les scripts CJK ainsi que pour l'anglais. L'édition est l'autre front. Un post sur r/StableDiffusion démontrant des planches de design de personnages générées avec le mode édition de Qwen et sans LoRA a attiré l'attention car ce flux de travail nécessitait auparavant une pile de fine-tunes et un week-end de câblage ComfyUI.
Pourquoi cela compte au-delà d'un seul modèle
Deux courants plus larges sont visibles ici. Le premier est que la communauté des poids ouverts a un nouveau standard. Pendant longtemps, la génération locale signifiait des dérivés de Stable Diffusion et des variantes de Flux, avec une chasse constante au checkpoint le moins mauvais. Qwen Image 2.1 s'intègre dans cet écosystème avec des capacités d'édition modernes intégrées, et les outils ont suivi presque immédiatement. Le second courant est géographique. Un fil séparé sur r/singularity intitulé « Les modèles d'IA chinois gagnent en popularité mondiale — et Washington s'inquiète » a suscité des discussions précisément parce que des modèles comme celui-ci continuent d'atteindre le sommet des tests de préférence que les utilisateurs réalisent eux-mêmes, et non ceux commandés par les fournisseurs.
Pour quiconque choisit un outil quotidien en ce moment, la lecture pratique est simple. Si vous voulez la meilleure qualité d'édition absolue à partir d'une API hébergée, les leaders fermés valent toujours leur prix. Si vous voulez quelque chose que vous pouvez exécuter, fine-tuner, quantifier et intégrer dans votre propre pipeline sans demander la permission, le concurrent de 7B est difficile à ignorer. Et si vous êtes simplement curieux, les poids sont sur Hugging Face. Vingt-quatre secondes sur un ordinateur portable de deux ans est un seuil bas à franchir pour une première expérience.
L'édition comme nouveau champ de bataille
La fonctionnalité la plus importante n'est pas du tout la génération texte-image. C'est l'édition. Les modèles d'images antérieurs traitaient la modification comme un problème distinct : inpaint cette région, connecter un ControlNet, espérer que les coutures disparaissent. Qwen Image 2.1 traite l'édition comme un mode natif, le même modèle qui dessine peut redessiner. Une démonstration qui a circulé sur r/StableDiffusion montrait des planches de design de personnages, plusieurs vues cohérentes du même personnage à travers des poses et des tenues, produites sans LoRA et sans système de référence. Quiconque a essayé ce flux de travail il y a un an sait ce que cela coûtait : un fine-tune par personnage, des heures de peinture de masque, et des résultats qui dérivaient entre les angles.
L'édition est aussi l'endroit où la valeur commerciale se concentre. Les équipes marketing ne veulent pas des images ; elles veulent leur image, ajustée. Une photo de produit avec l'arrière-plan échangé. Une affiche avec le titre régénéré dans une autre langue. L'édition native fait s'effondrer ce pipeline, et le fait qu'elle existe maintenant dans un modèle téléchargeable signifie que cet effondrement atteint des personnes qui ne paieront jamais pour une API.
L'outillage communautaire reflète cela. Le port TensorSharp est livré avec des configurations d'édition dès le premier jour, et non comme un ajout ultérieur. Le studio de style Fooocus expose les masques, les annotations, l'outpainting et les références de pose comme des entrées de premier ordre. Lorsque les adaptateurs traitent l'édition comme une fonctionnalité essentielle plutôt qu'un bonus, c'est le marché qui vote sur ce qui compte.
Comment la communauté teste réellement les affirmations
Les benchmarks des fournisseurs relèvent du marketing jusqu'à ce que quelqu'un les reproduise, donc les artefacts les plus intéressants ce mois-ci étaient ceux de la communauté. La comparaison de 192 images entre Qwen et Krea 2, générée avec des prompts identiques et triée par catégorie, est le format qui tranche réellement les débats. Elle a la même vertu qu'un test de goût à l'aveugle : le classement de personne ne survit à son contact inchangé. Les catégories où un modèle domine sont visibles en un coup d'œil, tout comme les catégories où les deux échouent.
Hacker News a fait sa part en refusant d'accepter le titre au pied de la lettre. Les sections de commentaires sur le fil de discussion de la sortie et la soumission de Tom's Hardware ont insisté sur les points faibles habituels : quelle suite de benchmarks, quel ensemble de prompts, ce qui se passe en dehors de la distribution testée. Ce scepticisme est le système immunitaire de la communauté des poids ouverts, et c'est pourquoi les affirmations qui y survivent ont du poids. La réputation de Qwen Image 2.1 est actuellement moins fondée sur les chiffres d'Alibaba que sur le fait que des centaines de personnes l'ont exécuté et n'ont pour la plupart pas publié de fils d'humiliation.
L'économie du suffisamment bon et de l'ouvert
Il y a une lecture commerciale qui va au-delà de la qualité du modèle. La génération d'images hébergée est tarifée par rapport aux modèles de pointe, et les modèles de pointe sont coûteux à exploiter. Un modèle de 7B qui offre la plupart de la qualité des modèles de pointe pour le coût de l'électricité change ce que les clients toléreront de payer. Cela change aussi ce sur quoi les développeurs construisent : un modèle ouvert avec des poids stables peut être épinglé, fine-tuné et expédié dans un produit sans négocier un accord API ni craindre une dépréciation.
Ce dernier point mérite d'être souligné car l'industrie vient de fournir une leçon de choses. OpenAI a retiré le produit DALL·E autonome à la fin du mois d'août, intégrant la génération d'images dans ChatGPT Images. Rien n'a été perdu techniquement, mais chaque intégration construite sur l'ancienne interface a dû migrer selon le calendrier de quelqu'un d'autre. Les poids ouverts n'envoient pas cet e-mail.
Rien de tout cela ne fait de Qwen Image 2.1 le meilleur modèle d'images au monde. Cela en fait quelque chose de sans doute plus perturbateur : le meilleur modèle d'images que n'importe qui peut posséder entièrement. Le débat sur le classement sera de toute façon tranché par la prochaine version, et celle d'après. Le changement de propriété est la partie qui perdure.
Le rythme est l'autre chose à intégrer. Plus de vingt sorties de modèles d'images en un seul mois, comme l'a compté récemment un utilisateur sur r/PromptEngineering, signifie que toute affirmation de « meilleur modèle » a une durée de vie mesurée en semaines. Qwen Image 2.1 est la preuve actuelle que petit et ouvert peut embarrasser grand et fermé. Donnez-lui un mois, et la question intéressante sera de savoir ce qui le remplacera.
Articles associés
Les modèles chinois d’IA d’image gagnent des adeptes à l’étranger, et Washington surveille
L’adoption est d’abord technique, politique ensuite. Les développeurs téléchargent ce qui fonctionne, et aujourd’hui, cela vient de plus en plus de laboratoires chinois.
Ce que les marchés de prédiction parient sur les images IA
De l’argent réel parie sur qui remportera la course à l’image IA. OpenAI mène sur les images fixes, MiniMax sur la vidéo, et les modèles ouverts sont la carte joker que personne n’intègre dans les prix.
Qwen-Image 2.1 vs Nano Banana 2.0 : un modèle ouvert de 7B vient de coller aux basques de Google
Un modèle ouvert de 7 milliards de paramètres dépasse désormais le Nano Banana 2.0 de Google sur le benchmark d'Alibaba et reste à portée de tir partout ailleurs.
Les modèles d’image chinois s’internationalisent, et ce mois-ci la conversation a changé
Les modèles d’image chinois s’internationalisent. Comment les benchmarks, les sections de commentaires et Washington ont changé ce mois-ci.