
Qwen Image 2.1: por qué un modelo de pesos abiertos de 7B le está dando batalla a Nano Banana 2.0
Cuando Alibaba lanzó discretamente Qwen Image 2.1, las cifras principales parecían poco llamativas. Siete mil millones de parámetros. Pesos abiertos. Otra semana, otro modelo. Luego llegaron los benchmarks, y un informe de Tom's Hardware afirmó que el modelo pequeño superó a Nano Banana 2.0 de Google en varios benchmarks de imágenes, a la vez que se mantenía competitivo frente a las ofertas de OpenAI y Meta. Un hilo de Hacker News sobre la publicación oficial en el blog de Qwen acumuló 739 puntos y casi 200 comentarios, el tipo de tráfico que no recibe un lanzamiento rutinario de un modelo.
Algo está pasando aquí, y vale la pena analizarlo, porque la parte interesante no es tanto quién encabeza una tabla de clasificación, sino hacia dónde se dirige la generación de imágenes.
Modelos pequeños, resultados serios
La cifra de parámetros es la clave. La mayoría de los modelos de imagen de frontera están en las decenas de miles de millones. Un modelo de 7B que obtiene resultados competitivos en benchmarks cambia los cálculos para cualquiera que ejecute inferencia en su propio hardware. En una RTX 5090 puedes ejecutar el denoiser completo en BF16 sin cuantizar nada. En un MacBook Pro con un M1 Max y 32 GB de memoria, un desarrollador logró ejecutar generación de texto a imagen y edición de imágenes de forma nativa en Apple Silicon en aproximadamente 24 segundos para una salida de 512x512, y publicó la demo en r/StableDiffusion. Eso no es rendimiento de centro de datos en un portátil. Eso es un aficionado ejecutando un modelo que presuntamente rivaliza con los mejores sistemas cerrados, en una máquina comprada para editar vídeo.
Los ports de la comunidad llegaron en cuestión de días. Alguien añadió soporte para Qwen-Image 2.1 a TensorSharp con cuantización GGUF y configuraciones LoRA, incluidas variantes de borrador más rápidas que reducen la generación a un puñado de pasos. Otro desarrollador creó un estudio Gradio al estilo Fooocus en torno a él, con máscaras, anotaciones, outpainting, referencias de OpenPose y bocetos como entradas. El patrón se repite: cuando los pesos son abiertos, el ecosistema construye las herramientas que el equipo oficial nunca llega a hacer.
El escepticismo ante los benchmarks es sano
Por supuesto, los benchmarks de los proveedores merecen recelo, y los comentaristas de Hacker News no decepcionaron. Aplican las advertencias habituales: la selección de benchmarks importa, los conjuntos de prompts importan, y “supera a Nano Banana” depende en gran medida de qué tareas midas. Una comparación lado a lado de 192 imágenes de Qwen Image 2.1 frente a Krea 2, ordenada por categoría y publicada abiertamente, es exactamente el tipo de verificación colectiva que zanja estos debates mejor que las notas de prensa. La persona que la realizó tuvo que cuantizar el codificador de texto a NF4 para ajustarse a su presupuesto de memoria, lo que dice algo sobre la brecha entre las condiciones de los benchmarks y las configuraciones reales.
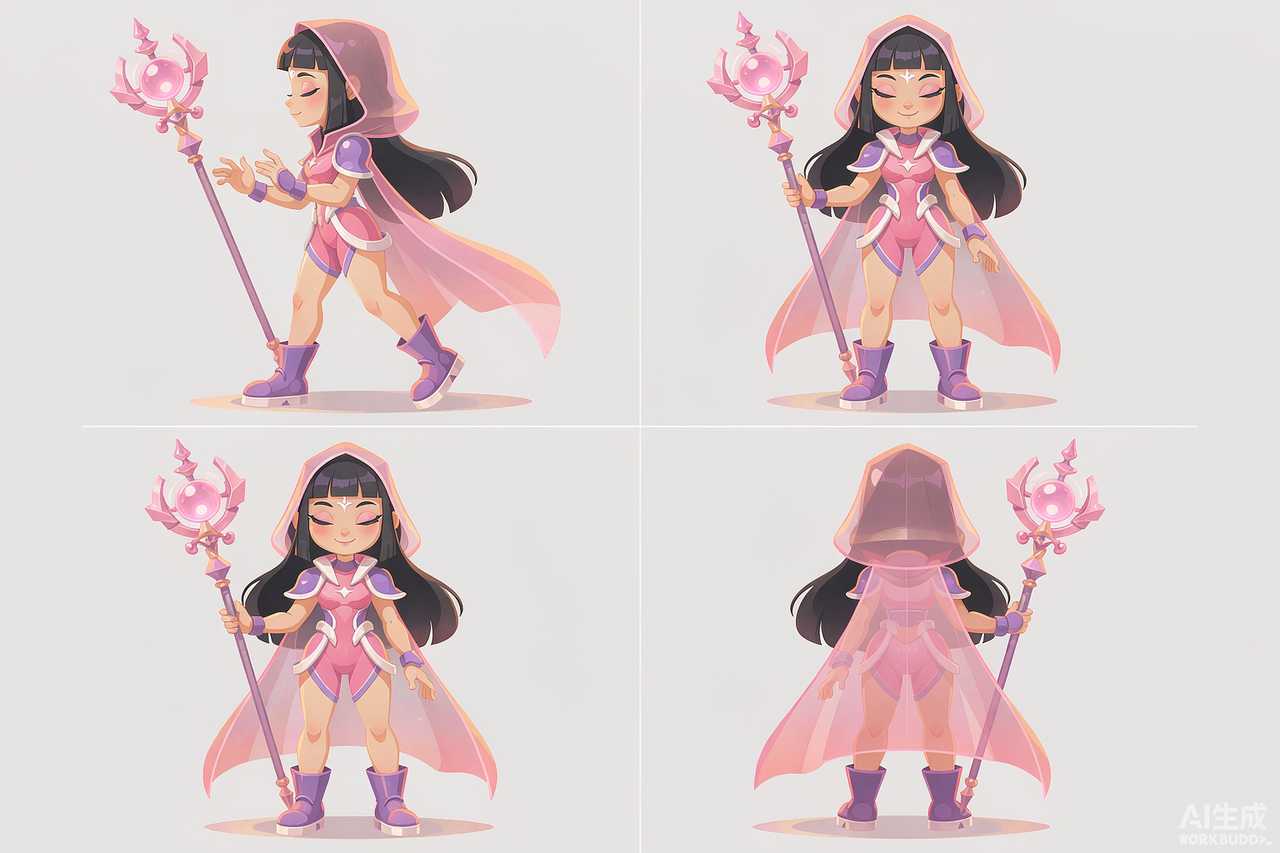
La representación de texto sigue siendo una de las capacidades más observadas, y es donde los modelos Qwen históricamente lo han hecho bien tanto para escrituras CJK como para inglés. La edición es el otro frente. Una publicación en r/StableDiffusion que mostraba hojas de diseño de personajes generadas con el modo de edición de Qwen y sin LoRAs llamó la atención porque ese flujo de trabajo solía requerir un montón de fine-tunes y un fin de semana de cableado en ComfyUI.
Por qué esto importa más allá de un solo modelo
Aquí se ven dos corrientes más amplias. La primera es que la comunidad de pesos abiertos tiene un nuevo valor predeterminado. Durante un largo periodo, la generación local significaba derivados de Stable Diffusion y variantes de Flux, con una búsqueda constante del checkpoint menos malo. Qwen Image 2.1 encaja en ese ecosistema con capacidades de edición modernas integradas, y las herramientas llegaron casi de inmediato. La segunda corriente es geográfica. Un hilo aparte en r/singularity titulado “Los modelos de IA chinos se disparan en popularidad mundial — y Washington está preocupado” acumuló debate precisamente porque modelos como este siguen quedando cerca de lo más alto en pruebas de preferencia que los propios usuarios ejecutan, no las que encargan los proveedores.
Para cualquiera que elija un modelo de uso diario ahora mismo, la lectura práctica es sencilla. Si quieres la mejor calidad de edición absoluta de una API alojada, los líderes cerrados todavía valen su precio. Si quieres algo que puedas ejecutar, ajustar, cuantizar y conectar a tu propio pipeline sin pedir permiso, el contendiente de 7B es difícil de ignorar. Y si solo tienes curiosidad, los pesos están en Hugging Face. Veinticuatro segundos en un portátil de hace dos años es un listón bajo para un primer experimento.
La edición como el nuevo campo de batalla
La característica más trascendental no es en absoluto la generación de texto a imagen. Es la edición. Los modelos de imagen anteriores trataban la modificación como un problema aparte: haz inpaint en esta región, conecta un ControlNet, confía en que las costuras desaparezcan. Qwen Image 2.1 trata la edición como un modo nativo; el mismo modelo que dibuja puede volver a dibujar. Una demostración que circuló en r/StableDiffusion mostraba hojas de diseño de personajes, múltiples vistas consistentes del mismo personaje en distintas poses y atuendos, producidas sin LoRAs y sin montaje de referencias. Cualquiera que haya probado ese flujo de trabajo hace un año sabe lo que costaba: un fine-tune por personaje, horas pintando máscaras y resultados que se desviaban entre ángulos.
La edición es también donde se concentra el valor comercial. Los equipos de marketing no quieren imágenes; quieren su imagen, ajustada. Una foto de producto con el fondo cambiado. Un póster con el titular regenerado en otro idioma. La edición nativa colapsa ese pipeline, y el hecho de que ahora exista en un modelo descargable significa que ese colapso llega a personas que nunca pagarán por una API.
Las herramientas de la comunidad reflejan esto. El port de TensorSharp se distribuye con configuraciones de edición desde el primer día, no como un añadido posterior. El estudio al estilo Fooocus expone máscaras, anotaciones, outpainting y referencias de pose como entradas de primera clase. Cuando quienes hacen los ports tratan la edición como una característica central en lugar de un extra, es el mercado votando sobre lo que importa.
Cómo prueba realmente la comunidad las afirmaciones
Los benchmarks de los proveedores son marketing hasta que alguien los reproduce, así que los artefactos más interesantes de este mes fueron los de la multitud. La comparación de 192 imágenes entre Qwen y Krea 2, generada con prompts idénticos y ordenada por categoría, es el formato que realmente zanja discusiones. Tiene la misma virtud que una cata a ciegas: el ranking de nadie sobrevive intacto al contacto con ella. Las categorías donde un modelo domina se ven de un vistazo, y también las categorías donde ambos fallan.
Hacker News hizo su parte al negarse a aceptar el titular sin más. Las secciones de comentarios del hilo del lanzamiento y del envío de Tom's Hardware presionaron sobre los puntos débiles habituales: qué suite de benchmarks, el conjunto de prompts de quién, qué ocurre fuera de la distribución probada. Ese escepticismo es el sistema inmunitario de la comunidad de pesos abiertos, y es la razón por la que las afirmaciones que sobreviven allí tienen peso. La reputación de Qwen Image 2.1 se basa actualmente menos en los números de Alibaba que en el hecho de que cientos de personas lo ejecutaron y en su mayoría no publicaron hilos de humillación.
La economía de lo suficientemente bueno y lo abierto
Hay una lectura empresarial que va más allá de la calidad del modelo. La generación de imágenes alojada tiene precios fijados en función de la frontera, y operar en la frontera es caro. Un modelo de 7B que ofrece la mayor parte de la calidad de la frontera por el coste de la electricidad cambia lo que los clientes tolerarán pagar. También cambia sobre qué construyen los desarrolladores: un modelo abierto con pesos estables se puede fijar, ajustar y enviar dentro de un producto sin negociar un acuerdo de API ni temer una deprecación.
Ese último punto merece énfasis porque la industria acaba de dar una lección objetiva. OpenAI retiró el producto independiente DALL·E a finales de agosto, integrando la generación de imágenes en ChatGPT Images. Técnicamente no se perdió nada, pero todas las integraciones construidas sobre la interfaz antigua tuvieron que migrar según el calendario de otra persona. Los pesos abiertos no envían ese correo.
Nada de esto convierte a Qwen Image 2.1 en el mejor modelo de imagen del mundo. Lo convierte en algo posiblemente más disruptivo: el mejor modelo de imagen que una persona cualquiera puede poseer por completo. La discusión sobre la tabla de clasificación se resolverá con el próximo lanzamiento, de todos modos, y con el siguiente. El cambio de propiedad es la parte que perdura.
El ritmo es lo otro que hay que interiorizar. Más de veinte lanzamientos de modelos de imagen en un solo mes, como contó recientemente un usuario de r/PromptEngineering, significa que cualquier afirmación de “mejor modelo” tiene una vida útil medida en semanas. Qwen Image 2.1 es la prueba actual de que lo pequeño y abierto puede avergonzar a lo grande y cerrado. Dale un mes, y la pregunta interesante será qué lo reemplaza.
Artículos relacionados
El desastre de generación de imágenes de Grok está reescribiendo las reglas para todos los demás
Millones de deepfakes no consentidos, investigaciones en tres continentes y un parche de suscripción de pago. Lo que la crisis de Grok zanjó sobre la responsabilidad de las imágenes con IA.
Los modelos chinos de IA para imágenes conquistan adeptos en el extranjero, y Washington observa
La adopción es técnica primero, política después. Los desarrolladores descargan lo que funciona, y ahora mismo eso viene cada vez más de laboratorios chinos.
Qué están apostando los mercados de predicción sobre las imágenes de IA
Hay dinero real apostando por quién gana en imágenes de IA. OpenAI lidera las imágenes fijas, MiniMax lidera el vídeo, y los modelos abiertos son el comodín que nadie valora.
Qwen-Image 2.1 vs. Nano Banana 2.0: un modelo abierto de 7B acaba de pisarle los talones a Google
Un modelo abierto de 7.000 millones de parámetros se sitúa ahora por delante de Nano Banana 2.0 de Google en el benchmark de Alibaba y a tiro de piedra en todo lo demás.