
Qwen Image 2.1: Warum ein 7B-Open-Weights-Modell Nano Banana 2.0 ernsthaft Konkurrenz macht
Als Alibaba Qwen Image 2.1 still veröffentlichte, wirkten die Schlagzeilen-Zahlen unspektakulär. Sieben Milliarden Parameter. Offene Gewichte. Eine weitere Woche, ein weiteres Modell. Dann kamen die Benchmarks, und ein Bericht von Tom's Hardware behauptete, das kleine Modell schlage Googles Nano Banana 2.0 in mehreren Bild-Benchmarks und bleibe zugleich konkurrenzfähig mit Angeboten von OpenAI und Meta. Ein Hacker-News-Thread zum offiziellen Qwen-Blogbeitrag sammelte 739 Punkte und fast 200 Kommentare – die Art von Traffic, die ein routinemäßiges Modellrelease nicht bekommt.
Hier ist etwas im Gange, und es lohnt sich, das auseinanderzunehmen, denn der interessante Teil dreht sich weniger darum, wer eine Bestenliste anführt, als darum, wohin die Bildgenerierung steuert.
Kleine Modelle, ernstzunehmende Resultate
Die Parameterzahl ist die Geschichte. Die meisten Frontier-Bildmodelle liegen im zweistelligen Milliardenbereich. Ein 7B-Modell, das konkurrenzfähig abschneidet, verändert die Rechnung für alle, die Inferenz auf eigener Hardware ausführen. Auf einer RTX 5090 lässt sich der vollständige BF16-Denoiser ohne jegliche Quantisierung ausführen. Auf einem MacBook Pro mit M1 Max und 32 GB Arbeitsspeicher brachte ein Entwickler Text-zu-Bild und Bildbearbeitung nativ auf Apple Silicon zum Laufen – mit etwa 24 Sekunden für eine 512x512-Ausgabe – und postete die Demo auf r/StableDiffusion. Das ist keine Rechenzentrumsleistung auf einem Laptop. Das ist ein Hobbyist, der ein Modell ausführt, das angeblich mit den besten geschlossenen Systemen mithält, auf einer Maschine, die für Videobearbeitung gekauft wurde.
Community-Ports folgten innerhalb von Tagen. Jemand fügte Qwen-Image-2.1-Unterstützung zu TensorSharp hinzu, mit GGUF-Quantisierung und LoRA-Konfigurationen, einschließlich schnellerer Draft-Varianten, die die Generierung auf eine Handvoll Schritte reduzieren. Ein anderer Entwickler baute ein Gradio-Studio im Fooocus-Stil darum, mit Masken, Annotationen, Outpainting, OpenPose-Referenzen und Skizzen als Eingaben. Das Muster wiederholt sich: Wenn die Gewichte offen sind, baut das Ökosystem die Werkzeuge, zu denen es das offizielle Team nie schafft.
Benchmark-Skepsis ist gesund
Natürlich verdienen Hersteller-Benchmarks Misstrauen, und die Hacker-News-Kommentierenden enttäuschten nicht. Es gelten die üblichen Einschränkungen: Die Benchmark-Auswahl zählt, die Prompt-Sets zählen, und „schlägt Nano Banana“ hängt stark davon ab, welche Aufgaben man misst. Ein öffentlich geposteter 192-Bilder-Vergleich von Qwen Image 2.1 gegen Krea 2, nach Kategorie sortiert, ist genau die Art von Crowd-Verifikation, die solche Debatten besser entscheidet als Pressemitteilungen. Die Person, die ihn durchführte, musste den Textencoder auf NF4 quantisieren, um ins Speicherbudget zu passen – was etwas über die Lücke zwischen Benchmark-Bedingungen und realen Setups verrät.
Textwiedergabe bleibt eine der am meisten beachteten Fähigkeiten, und hier haben Qwen-Modelle historisch sowohl bei CJK-Schriften als auch bei Englisch gut abgeschnitten. Bearbeitung ist die andere Front. Ein r/StableDiffusion-Beitrag, der mit Qwens Bearbeitungsmodus und ohne LoRAs generierte Character-Design-Sheets zeigte, erhielt Aufmerksamkeit, weil dieser Workflow früher einen Stapel Fine-Tunes und ein Wochenende voller ComfyUI-Verkabelung erforderte.
Warum das über ein einzelnes Modell hinaus wichtig ist
Hier sind zwei größere Strömungen sichtbar. Die erste ist, dass die Open-Weights-Community einen neuen Standard hat. Lange Zeit bedeutete lokale Generierung Stable-Diffusion-Derivate und Flux-Varianten, mit einer ständigen Suche nach dem am wenigsten schlechten Checkpoint. Qwen Image 2.1 fügt sich mit integrierten modernen Bearbeitungsfähigkeiten in dieses Ökosystem ein, und die Tools folgten fast unmittelbar. Die zweite Strömung ist geografisch. Ein separater r/singularity-Thread mit dem Titel „Chinese AI models surge in global popularity — and Washington is worried“ sammelte genau deshalb Diskussionen, weil Modelle wie dieses immer wieder nahe der Spitze von Präferenztests landen, die Nutzer selbst durchführen, nicht die, die Anbieter in Auftrag geben.
Für alle, die jetzt ein Daily-Driver-Modell wählen, ist die praktische Einschätzung unkompliziert. Wer die absolut beste Bearbeitungsqualität über eine gehostete API will, für den sind die geschlossenen Marktführer ihren Preis weiterhin wert. Wer etwas will, das man selbst ausführen, fine-tunen, quantisieren und ohne Erlaubnis in die eigene Pipeline einbinden kann, für den ist der 7B-Herausforderer schwer zu ignorieren. Und wer nur neugierig ist: Die Gewichte liegen auf Hugging Face. Vierundzwanzig Sekunden auf einem zwei Jahre alten Laptop sind eine niedrige Hürde für ein erstes Experiment.
Bearbeitung als neues Schlachtfeld
Die folgenreichste Funktion ist überhaupt nicht Text-zu-Bild. Es ist die Bearbeitung. Frühere Bildmodelle behandelten Modifikation als separates Problem: diesen Bereich inpainten, ein ControlNet verkabeln, hoffen, dass die Nähte verschwinden. Qwen Image 2.1 behandelt Bearbeitung als nativen Modus – dasselbe Modell, das zeichnet, kann auch neu zeichnen. Eine auf r/StableDiffusion kursierende Demonstration zeigte Character-Design-Sheets, mehrere konsistente Ansichten derselben Figur über Posen und Outfits hinweg, erzeugt ohne LoRAs und ohne Referenz-Rigging. Wer diesen Workflow vor einem Jahr ausprobiert hat, weiß, was er kostete: ein Fine-Tune pro Figur, Stunden des Maskenmalens und Ergebnisse, die zwischen Winkeln drifteten.
Bearbeitung ist auch der Bereich, in dem sich der kommerzielle Wert bündelt. Marketingteams wollen keine Bilder; sie wollen ihr Bild, angepasst. Ein Produktfoto mit ausgetauschtem Hintergrund. Ein Poster, dessen Überschrift in einer anderen Sprache neu generiert wird. Native Bearbeitung lässt diese Pipeline kollabieren, und die Tatsache, dass es sie jetzt in einem herunterladbaren Modell gibt, bedeutet, dass dieser Kollaps Menschen erreicht, die niemals für eine API bezahlen werden.
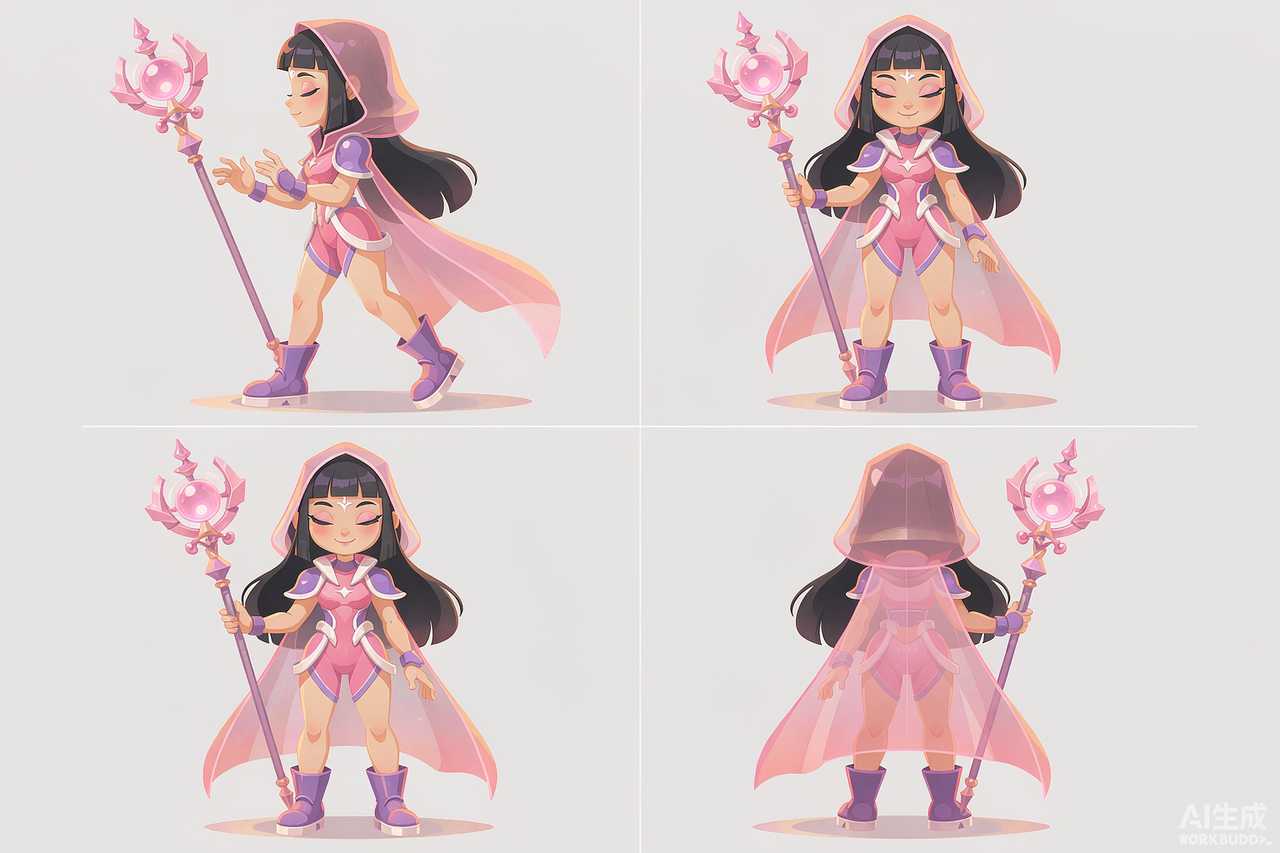
Die Community-Tooling spiegelt das wider. Der TensorSharp-Port wird von Tag eins an mit Bearbeitungskonfigurationen ausgeliefert, nicht als späterer Nachtrag. Das Studio im Fooocus-Stil stellt Masken, Annotationen, Outpainting und Posenreferenzen als erstklassige Eingaben bereit. Wenn Porter die Bearbeitung als Kernfunktion statt als Bonus behandeln, stimmt der Markt darüber ab, was zählt.
Wie die Community Behauptungen tatsächlich prüft
Benchmarks von Anbietern sind Marketing, bis jemand sie reproduziert; deshalb waren die interessanteren Artefakte dieses Monats die Crowd-Artefakte. Der 192-Bilder-Vergleich Qwen gegen Krea 2, mit identischen Prompts generiert und nach Kategorie sortiert, ist das Format, das Debatten tatsächlich entscheidet. Es hat dieselbe Tugend wie ein Blindtest: Niemandes Ranking übersteht den Kontakt damit unverändert. Kategorien, in denen ein Modell dominiert, sind auf einen Blick sichtbar – ebenso Kategorien, in denen beide scheitern.
Hacker News tat seinen Teil, indem es sich weigerte, die Schlagzeile für bare Münze zu nehmen. Die Kommentarbereiche zum Release-Thread und zur Tom's-Hardware-Einreichung hakten die üblichen Schwachstellen nach: Welche Benchmark-Suite, wessen Prompt-Set, was außerhalb der getesteten Verteilung passiert. Diese Skepsis ist das Immunsystem der Open-Weights-Community, und deshalb haben Behauptungen, die dort überleben, Gewicht. Der Ruf von Qwen Image 2.1 basiert derzeit weniger auf Alibabas Zahlen als auf der Tatsache, dass Hunderte Menschen es ausprobierten und größtenteils keine Demütigungs-Threads posteten.
Die Ökonomie von gut genug und offen
Es gibt eine geschäftliche Lesart, die über die Modellqualität hinausgeht. Gehostete Bildgenerierung wird gegen die Frontier bepreist, und die Frontier ist teuer im Betrieb. Ein 7B-Modell, das den größten Teil der Frontier-Qualität für die Stromkosten liefert, verändert, was Kundinnen und Kunden zu zahlen bereit sind. Es verändert auch, worauf Entwickler aufbauen: Ein offenes Modell mit stabilen Gewichten kann gepinnt, fine-getunt und innerhalb eines Produkts ausgeliefert werden, ohne eine API-Vereinbarung auszuhandeln oder eine Deprecation zu fürchten.
Der letzte Punkt verdient Betonung, denn die Branche hat gerade eine Anschauungsstunde geliefert. OpenAI zog das eigenständige DALL·E-Produkt Ende August zurück und integrierte die Bildgenerierung in ChatGPT Images. Technisch ging nichts verloren, aber jede Integration, die auf der alten Schnittstelle aufbaute, musste nach dem Zeitplan von jemand anderem migrieren. Offene Gewichte schicken diese E-Mail nicht.
Das alles macht Qwen Image 2.1 nicht zum besten Bildmodell der Welt. Es macht etwas, das wohl disruptiver ist: das beste Bildmodell, das eine x-beliebige Person vollständig besitzen kann. Die Bestenlisten-Debatte wird ohnehin durch das nächste Release entschieden, und durch das danach. Der Wandel hin zum Eigentum ist der Teil, der bleibt.
Das Tempo ist das andere, was man verinnerlichen sollte. Mehr als zwanzig Bildmodell-Releases in einem einzigen Monat, wie ein r/PromptEngineering-Poster kürzlich zählte, bedeutet, dass jede „beste Modell“-Behauptung eine Haltbarkeit von Wochen hat. Qwen Image 2.1 ist der aktuelle Beweis dafür, dass klein und offen groß und geschlossen blamieren kann. In einem Monat wird die interessante Frage sein, was es ersetzt.
Verwandte Artikel
Chinesische KI-Bildmodelle gewinnen Fans im Ausland, und Washington schaut zu
Die Verbreitung ist zuerst technisch, politisch erst an zweiter Stelle. Entwickler laden herunter, was funktioniert, und das kommt derzeit zunehmend von chinesischen Laboren.
Worauf die Prediction Markets bei KI-Bildern wetten
Echtes Geld wettet darauf, wer KI-Bilder gewinnt. OpenAI führt bei Standbildern, MiniMax bei Video, und die offenen Modelle sind die Wildcard, die niemand einpreist.
Qwen-Image 2.1 vs. Nano Banana 2.0: Ein offenes 7B-Modell ist Google dicht auf den Fersen
Ein offenes Modell mit 7 Milliarden Parametern liegt jetzt in Alibabas Benchmark vor Googles Nano Banana 2.0 und überall sonst in Schlagdistanz.
Chinesische Bildmodelle gehen global – und diesen Monat hat sich die Diskussion verändert
Chinesische Bildmodelle gehen global. Wie sich die Benchmarks, die Kommentarspalten und Washington in diesem Monat verändert haben.