
Qwen Image 2.1: Por que um modelo de 7B com pesos abertos está fazendo frente ao Nano Banana 2.0
Quando a Alibaba lançou discretamente o Qwen Image 2.1, os números de destaque pareciam pouco impressionantes. Sete bilhões de parâmetros. Pesos abertos. Mais uma semana, mais um modelo. Então os benchmarks chegaram, e um relatório do Tom's Hardware afirmou que o modelo pequeno superou o Nano Banana 2.0, do Google, em vários benchmarks de imagem, mantendo-se competitivo com as ofertas da OpenAI e da Meta. Uma thread no Hacker News sobre o post oficial no blog do Qwen reuniu 739 pontos e quase 200 comentários, o tipo de tráfego que um lançamento rotineiro de modelo não costuma receber.
Há algo acontecendo aqui, e vale a pena destrinchar, porque a parte interessante tem menos a ver com quem lidera um ranking e mais com para onde a geração de imagens está caminhando.
Modelos pequenos, resultados sérios
A contagem de parâmetros é a história. A maioria dos modelos de imagem de ponta fica na casa das dezenas de bilhões. Um modelo de 7B que tem desempenho competitivo em benchmarks muda as contas para qualquer pessoa que roda inferência no próprio hardware. Em uma RTX 5090, você pode rodar o denoiser BF16 completo sem quantizar nada. Em um MacBook Pro com M1 Max e 32 GB de memória, um desenvolvedor conseguiu rodar text-to-image e edição de imagem nativamente em Apple Silicon em cerca de 24 segundos para uma saída de 512x512, e publicou a demonstração no r/StableDiffusion. Isso não é desempenho de datacenter em um laptop. É um hobista rodando um modelo que, supostamente, rivaliza com os melhores sistemas fechados, em uma máquina comprada para edição de vídeo.
Portes da comunidade surgiram em poucos dias. Alguém adicionou suporte ao Qwen-Image 2.1 no TensorSharp com quantização GGUF e configurações de LoRA, incluindo variantes de rascunho mais rápidas que reduzem a geração a um punhado de passos. Outro desenvolvedor criou um estúdio Gradio no estilo Fooocus em torno dele, com máscaras, anotações, outpainting, referências OpenPose e esboços como entradas. O padrão se repete: quando os pesos são abertos, o ecossistema constrói as ferramentas que a equipe oficial nunca chega a fazer.
O ceticismo em relação a benchmarks é saudável
É claro que benchmarks de fornecedores merecem desconfiança, e os comentaristas do Hacker News não decepcionaram. As ressalvas de sempre se aplicam: a escolha do benchmark importa, os conjuntos de prompts importam, e “supera o Nano Banana” depende muito de quais tarefas você mede. Uma comparação lado a lado de 192 imagens do Qwen Image 2.1 contra o Krea 2, ordenada por categoria e publicada abertamente, é exatamente o tipo de verificação pela multidão que resolve essas discussões melhor do que comunicados de imprensa. A pessoa que a conduziu teve que quantizar o codificador de texto para NF4 para caber no orçamento de memória, o que diz algo sobre a lacuna entre condições de benchmark e configurações reais.
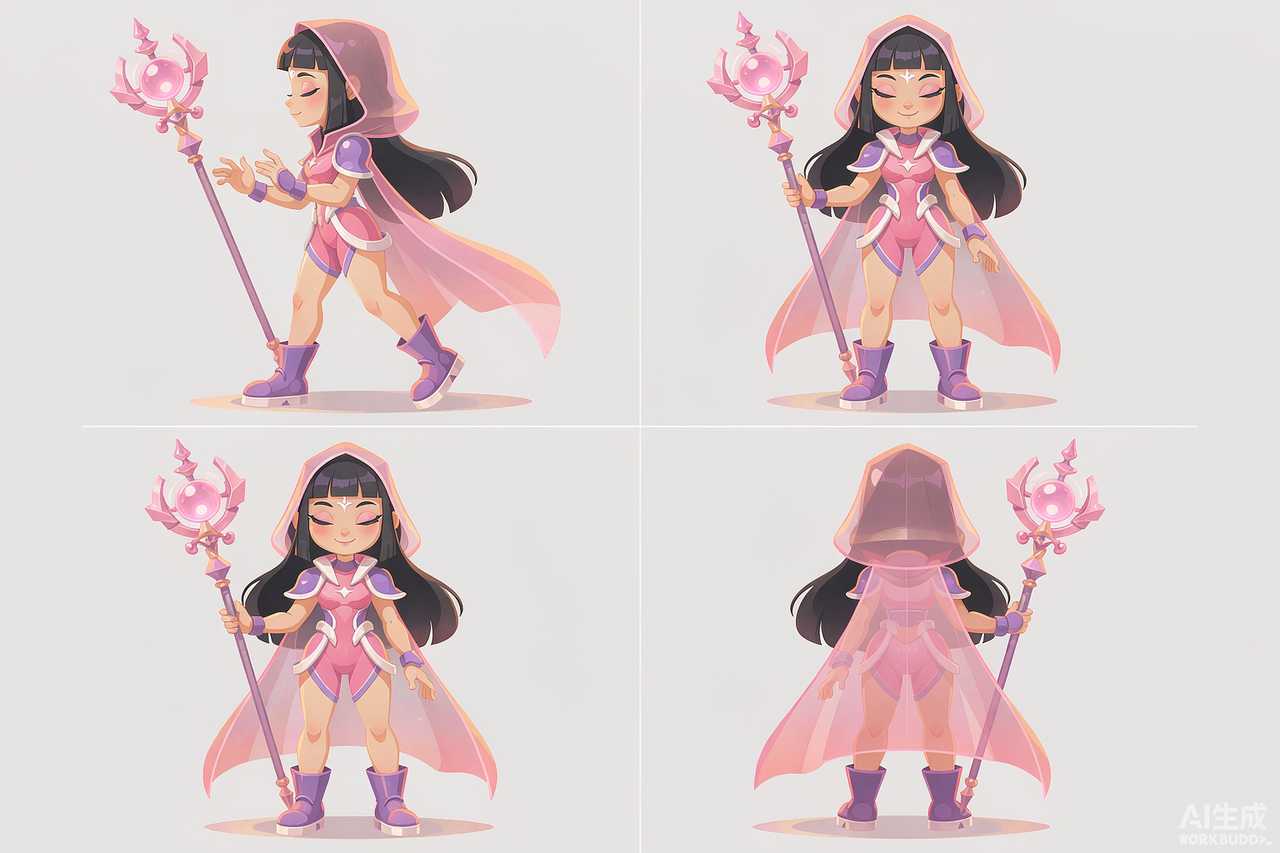
A renderização de texto continua sendo uma das capacidades mais observadas, e é onde os modelos Qwen historicamente se saíram bem tanto para escritas CJK quanto para inglês. A edição é a outra frente. Um post no r/StableDiffusion demonstrando folhas de design de personagem geradas com o modo de edição do Qwen e sem LoRAs chamou atenção porque esse fluxo de trabalho costumava exigir uma pilha de fine-tunes e um fim de semana montando ComfyUI.
Por que isso importa além de um modelo
Duas correntes maiores são visíveis aqui. A primeira é que a comunidade de pesos abertos tem um novo padrão. Por um longo período, geração local significava derivados do Stable Diffusion e variantes do Flux, com uma caça constante pelo checkpoint menos ruim. O Qwen Image 2.1 se encaixa nesse ecossistema com habilidades modernas de edição já integradas, e as ferramentas vieram quase imediatamente. A segunda corrente é geográfica. Uma thread separada no r/singularity intitulada “Modelos de IA chineses crescem em popularidade global — e Washington está preocupada” acumulou discussão justamente porque modelos como esse continuam aparecendo perto do topo de testes de preferência que os próprios usuários aplicam, não os que os fornecedores encomendam.
Para quem está escolhendo um modelo para o dia a dia agora, a leitura prática é direta. Se você quer a melhor qualidade de edição absoluta de uma API hospedada, os líderes fechados ainda valem o preço. Se você quer algo que possa rodar, ajustar, quantizar e conectar ao seu próprio pipeline sem pedir permissão, o concorrente de 7B é difícil de ignorar. E se você só está curioso, os pesos estão no Hugging Face. Vinte e quatro segundos em um laptop de dois anos é uma barra baixa para um primeiro experimento.
Edição como o novo campo de batalha
A funcionalidade mais significativa não é text-to-image. É edição. Modelos de imagem anteriores tratavam a modificação como um problema separado: inpaint nesta região, conecte um ControlNet, torça para as emendas desaparecerem. O Qwen Image 2.1 trata edição como um modo nativo, o mesmo modelo que desenha pode redesenhar. Uma demonstração que circulou no r/StableDiffusion mostrou folhas de design de personagem, múltiplas visões consistentes do mesmo personagem em poses e figurinos diferentes, produzidas sem LoRAs e sem referências montadas. Qualquer um que tentou esse fluxo de trabalho um ano atrás sabe o que ele custava: um fine-tune por personagem, horas pintando máscaras e resultados que mudavam entre ângulos.
A edição também é onde o valor comercial se concentra. Equipes de marketing não querem imagens; querem a imagem delas, ajustada. Uma foto de produto com o fundo trocado. Um cartaz com a manchete regenerada em outro idioma. A edição nativa colapsa esse pipeline, e o fato de ela agora existir em um modelo baixável significa que o colapso alcança pessoas que nunca pagariam por uma API.
As ferramentas da comunidade refletem isso. O porte para TensorSharp já vem com configurações de edição desde o primeiro dia, não como um adendo posterior. O estúdio no estilo Fooocus expõe máscaras, anotações, outpainting e referências de pose como entradas de primeira classe. Quando quem faz os portes trata a edição como um recurso central, e não como bônus, é o mercado votando no que importa.
Como a comunidade realmente testa alegações
Benchmarks de fornecedores são marketing até alguém reproduzi-los, então os artefatos mais interessantes deste mês foram os comunitários. A comparação de 192 imagens entre Qwen e Krea 2, gerada com prompts idênticos e ordenada por categoria, é o formato que de fato resolve discussões. Ela tem a mesma virtude de um teste de sabor às cegas: o ranking de ninguém sobrevive ao contato com ela inalterado. Categorias em que um modelo domina são visíveis de relance, e também as categorias em que ambos falham.
O Hacker News fez sua parte ao se recusar a aceitar a manchete pelo valor de face. As seções de comentários na thread do lançamento e no envio do Tom's Hardware pressionaram os pontos fracos de sempre: qual suíte de benchmarks, o conjunto de prompts de quem, o que acontece fora da distribuição testada. Esse ceticismo é o sistema imunológico da comunidade de pesos abertos, e é por isso que alegações que sobrevivem ali têm peso. A reputação do Qwen Image 2.1 atualmente se baseia menos nos números da Alibaba e mais no fato de que centenas de pessoas o testaram e, em sua maioria, não publicaram threads de humilhação.
A economia do bom o suficiente e aberto
Há uma leitura de negócios que vai além da qualidade do modelo. A geração de imagens hospedada tem seu preço definido em relação à fronteira, e operar na fronteira é caro. Um modelo de 7B que entrega a maior parte da qualidade da fronteira pelo custo da eletricidade muda o que os clientes tolerarão pagar. Também muda aquilo sobre o que os desenvolvedores constroem: um modelo aberto com pesos estáveis pode ser fixado, ajustado e enviado dentro de um produto sem negociar um acordo de API ou temer uma depreciação.
Esse último ponto merece ênfase porque a indústria acabou de dar uma lição objetiva. A OpenAI aposentou o produto DALL·E independente no final de agosto, incorporando a geração de imagens ao ChatGPT Images. Nada foi perdido tecnicamente, mas toda integração construída sobre a interface antiga teve que migrar no cronograma de outra pessoa. Pesos abertos não mandam esse e-mail.
Nada disso torna o Qwen Image 2.1 o melhor modelo de imagem do mundo. Torna algo indiscutivelmente mais disruptivo: o melhor modelo de imagem que uma pessoa aleatória pode possuir por completo. A discussão de ranking será resolvida pelo próximo lançamento de qualquer forma, e pelo seguinte. A mudança de propriedade é a parte que dura.
O ritmo é a outra coisa a internalizar. Mais de vinte lançamentos de modelos de imagem em um único mês, como contou recentemente um post no r/PromptEngineering, significa que qualquer alegação de “melhor modelo” tem prazo de validade medido em semanas. O Qwen Image 2.1 é a prova atual de que pequeno e aberto pode envergonhar grande e fechado. Dê um mês, e a pergunta interessante será o que o substituirá.
Artigos relacionados
Modelos chineses de imagem por IA estão conquistando fãs no exterior, e Washington está de olho
A adoção é técnica em primeiro lugar, política em segundo. Os desenvolvedores baixam o que funciona, e no momento isso vem cada vez mais de laboratórios chineses.
O que os mercados de previsão estão apostando sobre imagens de IA
Dinheiro de verdade está apostando em quem vence em imagens de IA. A OpenAI lidera em imagens estáticas, a MiniMax lidera em vídeo, e os modelos abertos são o curinga que ninguém precifica.
Qwen-Image 2.1 vs Nano Banana 2.0: Um Modelo Aberto de 7B Acabou de Chegar nos Calcanhares do Google
Um modelo aberto de 7 bilhões de parâmetros agora está à frente do Nano Banana 2.0 do Google no benchmark da Alibaba e a uma distância competitiva em todos os outros lugares.
Os modelos de imagem chineses estão se globalizando, e neste mês a conversa mudou
Os modelos de imagem chineses estão se globalizando. Como os benchmarks, as seções de comentários e Washington mudaram neste mês.