
Qwen Image 2.1:為何一個 7B 開放權重模型讓 Nano Banana 2.0 不敢小覷
當阿里巴巴悄悄發布 Qwen Image 2.1 時,標題數字看起來並不亮眼。70 億參數。開放權重。又過一週,又一個模型。接著基準測試結果出爐,Tom's Hardware 一篇報導聲稱,這個小模型在數項圖像基準測試上擊敗 Google 的 Nano Banana 2.0,同時與 OpenAI 和 Meta 的產品保持競爭力。Hacker News 上一則關於 Qwen 官方部落格文章的討論串吸引了 739 分與近 200 則留言,這可不是例行模型發布會得到的流量。
有些事情正在發生,值得細究,因為有趣的部分與其說在於誰登上排行榜首位,不如說在於圖像生成正走向何方。
小模型,認真輸出
參數數量才是重點。多數前沿圖像模型都落在數百億參數。一個在基準測試中具競爭力的 7B 模型,改變了任何在自己硬體上跑推論的人的盤算。在 RTX 5090 上,你可以執行完整的 BF16 去雜訊器,完全不用量化任何東西。在一台配備 M1 Max 與 32 GB 記憶體的 MacBook Pro 上,一名開發者讓文字轉圖像與圖像編輯原生跑在 Apple Silicon 上,512x512 輸出約需 24 秒,並將示範貼到 r/StableDiffusion。那不是資料中心效能在筆電上。那是一名業餘愛好者在一台為了剪輯影片而買的機器上,跑著一個據稱可與最佳閉源系統匹敵的模型。
社群移植在幾天內跟進。有人把 Qwen-Image 2.1 支援加入 TensorSharp,附帶 GGUF 量化與 LoRA 設定,包括能把生成縮減到寥寥幾步的更快草稿變體。另一名開發者圍繞它打造了 Fooocus 風格的 Gradio 工作室,以遮罩、標註、擴圖、OpenPose 參考與素描作為輸入。這個模式一再重複:當權重開放,生態系就會打造官方團隊始終沒空做的工具。
基準測試的懷疑是健康的
當然,廠商基準測試值得懷疑,而 Hacker News 的留言者也沒讓人失望。慣例的但書依然適用:基準測試的挑選很重要,提示詞集很重要,而「擊敗 Nano Banana」很大程度上取決於你衡量哪些任務。一份把 Qwen Image 2.1 與 Krea 2 並排比較的 192 張圖像比較,按類別排序並公開貼出,正是那種比新聞稿更能平息這類爭論的群眾驗證。執行這項比較的人必須把文字編碼器量化到 NF4,才塞得進記憶體預算,這說明了基準測試條件與真實設定之間的落差。
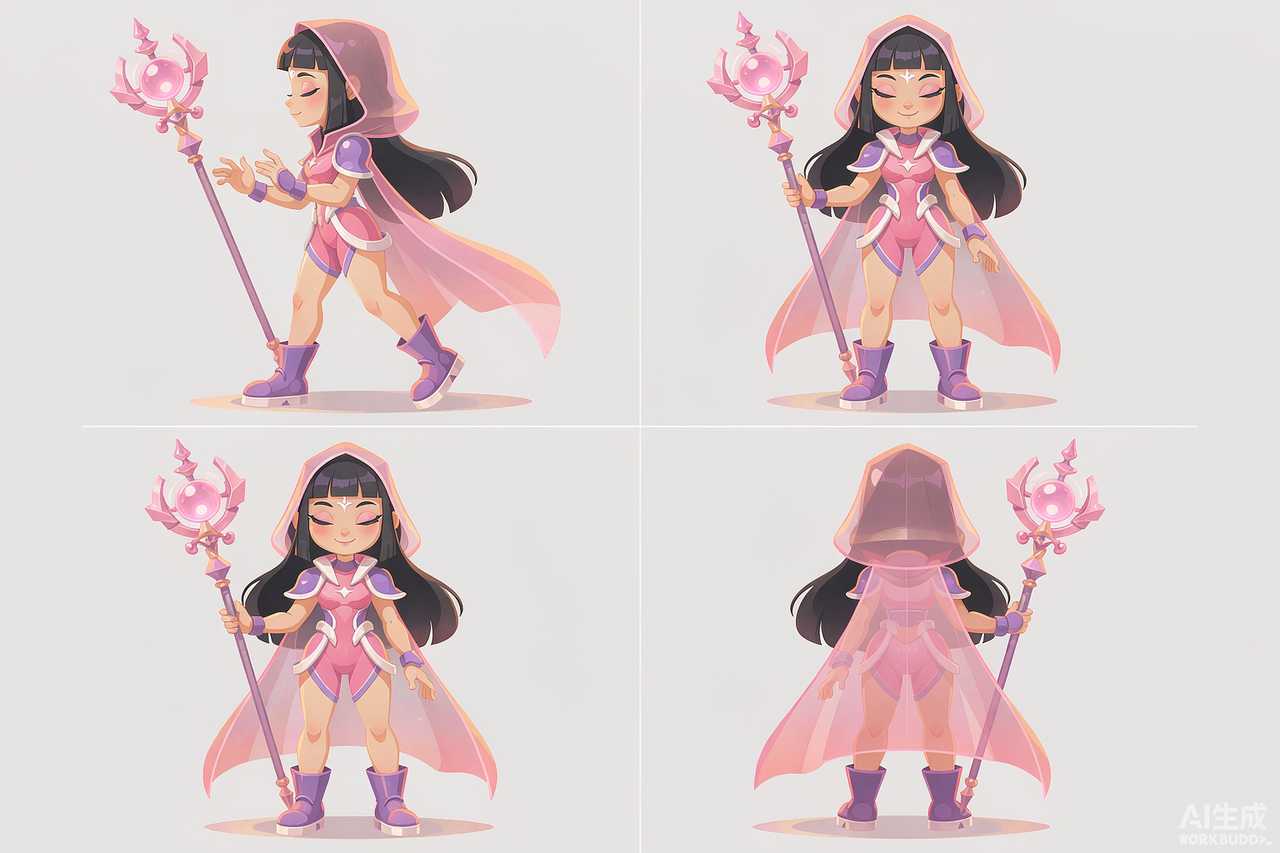
文字渲染仍是最受關注的能力之一,而 Qwen 模型歷來在 CJK 文字與英文上都表現良好。編輯是另一條戰線。一篇 r/StableDiffusion 貼文展示了以 Qwen 的編輯模式、完全不使用 LoRA 生成的角色設計表,之所以受到關注,是因為那樣的工作流程以前需要一堆微調模型和一整個週末的 ComfyUI 接線。
為何這不只是一款模型的事
這裡可見兩股更大的潮流。第一股是開放權重社群有了新的預設選擇。有好長一段時間,本機生成意味著 Stable Diffusion 衍生物與 Flux 變體,並且不斷尋找最不糟糕的檢查點。Qwen Image 2.1 內建現代編輯能力,切入那個生態系,而工具幾乎立刻跟上。第二股潮流是地理性的。另一則 r/singularity 討論串標題為「中國 AI 模型在全球人氣飆升——而華盛頓感到擔憂」,之所以引發大量討論,正是因為像這樣的模型不斷在使用者自己跑的偏好測試中名列前茅,而不是廠商委託的那種測試。
對現在正在挑選每日主力工具的人來說,實務上的解讀很直接。如果你想要託管 API 帶來絕對最佳的編輯品質,閉源領導者仍然值那個價。如果你想要能自己執行、微調、量化,並接入自己工作流程而不必請求許可的東西,這個 7B 競爭者很難忽視。而如果你只是好奇,權重就在 Hugging Face 上。在一台兩年老筆電上花 24 秒,對第一次實驗來說是很低的門檻。
編輯成為新戰場
最具影響力的功能根本不是文字轉圖像。而是編輯。較早的圖像模型把修改當成另一個問題:修補這個區域、接上 ControlNet、祈禱接縫消失。Qwen Image 2.1 把編輯當成原生模式,會畫圖的同一個模型也能重繪。一則在 r/StableDiffusion 上流傳的示範展示了角色設計表,同一個角色在不同姿勢與服裝下的多個一致視圖,而且不用任何 LoRA、不用任何參考架設。一年前試過那種工作流程的人都知道代價:每個角色一次微調、數小時的遮罩描繪,以及會在不同角度之間飄移的結果。
編輯也是商業價值集中之處。行銷團隊要的不是圖像;他們要的是他們的圖像,經過調整。一張換掉背景的產品照。一張把標題重新生成為不同語言的海報。原生編輯讓那條流程坍縮,而它現在存在於一個可下載的模型中,意味著這種坍縮會觸及那些永遠不會付費使用 API 的人。
社群工具反映了這一點。TensorSharp 移植版從第一天就附上編輯設定,而不是後來才追加。Fooocus 風格工作室把遮罩、標註、擴圖與姿勢參考當成第一級輸入。當移植者把編輯視為核心功能而非附加福利,那就是市場在對什麼重要投票。
社群實際上如何檢驗宣稱
廠商基準測試在有人重現之前都只是行銷,所以這個月更有趣的產物是群眾做的那些。那份以相同提示詞生成、按類別排序的 192 張 Qwen 對 Krea 2 比較,才是真正能平息爭論的格式。它和盲測有同樣的優點:沒有任何人的排名能原封不動地通過考驗。某個模型佔優的類別一眼可見,兩者都失敗的類別也一樣。
Hacker News 也盡了一份力,拒絕照單全收標題。發布討論串與 Tom's Hardware 投稿底下的留言區,猛攻慣常的弱點:哪一套基準測試、誰的提示詞集、在受測分布之外會發生什麼。那種懷疑是開放權重社群的免疫系統,也是為什麼能在那裡存活的宣稱具有份量。Qwen Image 2.1 的聲譽目前與其說建立在阿里巴巴的數字上,不如說建立在數百人跑過它、而且大多沒有貼出羞辱討論串的事實上。
夠好與開放的經濟學
有一個超越模型品質的商業解讀。託管圖像生成的定價是對照前沿水準,而前沿水準的營運成本高昂。一個 7B 模型以電費為代價,交出前沿大部分品質,改變了客戶願意容忍支付的價格。它也改變了開發者建造的基礎:一個權重穩定的開放模型可以被固定、微調,並在產品中出貨,不必協商 API 協議,也不必擔心遭棄用。
最後一點值得強調,因為產業才剛提供了一個活生生的教訓。OpenAI 在八月底終止了獨立的 DALL·E 產品,把圖像生成併入 ChatGPT Images。技術上沒有失去什麼,但每一個建立在舊介面上的整合,都必須按照別人的時程遷移。開放權重不會寄那封電子郵件。
這一切都不會讓 Qwen Image 2.1 成為世界上最好的圖像模型。它讓某件可說更具顛覆性的事成立:一個普通人能完全擁有的最佳圖像模型。排行榜之爭反正會被下一次發布平息,然後再下一次。所有權的轉移才是會留下來的部分。
步調是另一件要內化的事。正如一位 r/PromptEngineering 發文者最近統計的,單月二十多個圖像模型發布,意味著任何「最佳模型」宣稱的保鮮期都以週計。Qwen Image 2.1 是目前小且開放能讓大且閉源難堪的證明。給它一個月,有趣的問題就會變成什麼會取代它。
相關文章
中國 AI 圖像模型正在海外贏得粉絲,華府正密切關注
這種採用首先是技術性的,政治其次。開發者下載的是真正有用的東西,而現在這越來越常來自中國實驗室。
預測市場正在押注 AI 圖像的什麼事
真金白銀正在押注誰能贏得 AI 圖像。OpenAI 在靜態圖像領先,MiniMax 在影片領先,而開源模型是沒人定價的變數。
Qwen-Image 2.1 對決 Nano Banana 2.0:7B 開源模型已緊追 Google 其後
一款 70 億參數的開源模型如今在阿里巴巴的基準測試中領先 Google 的 Nano Banana 2.0,在其他排行榜上也已逼近到隨時可能超車的距離。
中國 AI 圖像模型正走向全球,而這個月,風向變了
中國圖像模型正走向全球。這個月,基準測試、留言區與華府如何改變了整個討論。