
Qwen Image 2.1: perché un modello open-weights da 7B sta dando filo da torcere a Nano Banana 2.0
Quando Alibaba ha pubblicato Qwen Image 2.1 senza clamore, i numeri principali sembravano poco degni di nota. Sette miliardi di parametri. Pesi aperti. Un'altra settimana, un altro modello. Poi sono arrivati i benchmark, e un report di Tom's Hardware ha affermato che il modello piccolo ha battuto Nano Banana 2.0 di Google su diversi benchmark per immagini, mantenendosi competitivo con le offerte di OpenAI e Meta. Un thread su Hacker News riguardo al post ufficiale sul blog di Qwen ha totalizzato 739 punti e quasi 200 commenti, il tipo di traffico che un rilascio di modello ordinario non ottiene.
Qualcosa bolle in pentola, e vale la pena approfondire, perché la parte interessante riguarda meno chi è in cima a una classifica e più dove sta andando la generazione di immagini.
Modelli piccoli, risultati seri
Il numero di parametri è il punto. La maggior parte dei modelli di immagini di frontiera si colloca nelle decine di miliardi. Un modello da 7B che si comporta bene nei benchmark cambia i calcoli per chiunque esegua inferenza sul proprio hardware. Su una RTX 5090 puoi eseguire il denoiser BF16 completo senza quantizzare nulla. Su un MacBook Pro con M1 Max e 32 GB di memoria, uno sviluppatore ha fatto girare text-to-image e editing di immagini nativamente su Apple Silicon a circa 24 secondi per un output 512x512, e ha pubblicato la demo su r/StableDiffusion. Non è prestazione da datacenter su un laptop. È un appassionato che esegue un modello che presumibilmente rivaleggia con i migliori sistemi chiusi, su una macchina comprata per il montaggio video.
Port della community sono seguiti nel giro di giorni. Qualcuno ha aggiunto il supporto a Qwen-Image 2.1 in TensorSharp con quantizzazione GGUF e configurazioni LoRA, incluse varianti draft più veloci che riducono la generazione a una manciata di passaggi. Un altro sviluppatore ha costruito attorno ad esso uno studio Gradio in stile Fooocus, con maschere, annotazioni, outpainting, riferimenti OpenPose e schizzi come input. Il pattern si ripete: quando i pesi sono aperti, l'ecosistema costruisce gli strumenti che il team ufficiale non riesce mai a realizzare.
Lo scetticismo sui benchmark è sano
Naturalmente, i benchmark dei fornitori meritano sospetto, e i commentatori di Hacker News non hanno deluso. Valgono le solite avvertenze: la scelta dei benchmark conta, i set di prompt contano, e "batte Nano Banana" dipende fortemente da quali attività misuri. Un confronto affiancato di 192 immagini di Qwen Image 2.1 contro Krea 2, ordinato per categoria e pubblicato pubblicamente, è esattamente il tipo di verifica collettiva che risolve queste discussioni meglio dei comunicati stampa. La persona che lo ha eseguito ha dovuto quantizzare il text encoder a NF4 per rientrare nel budget di memoria, il che dice qualcosa sul divario tra condizioni di benchmark e configurazioni reali.
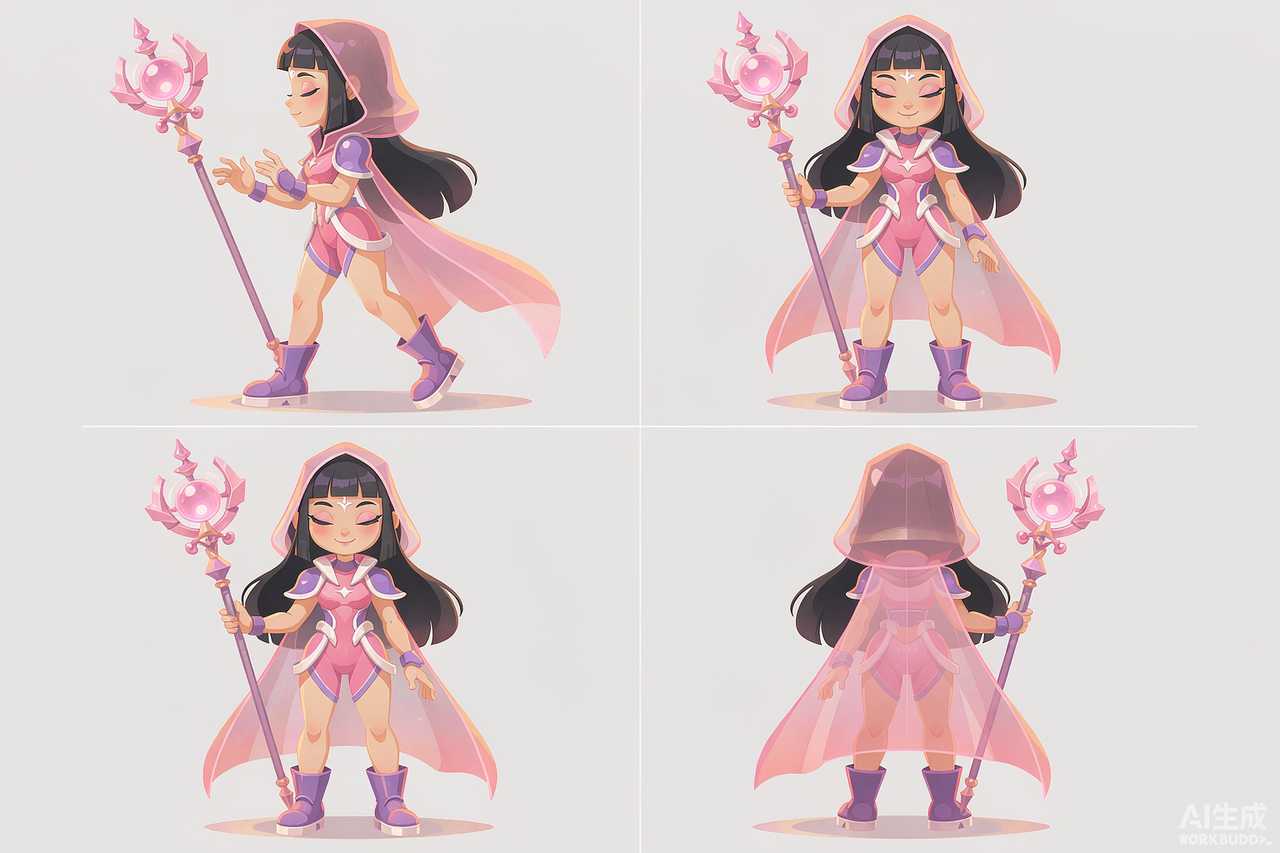
Il rendering del testo rimane una delle capacità più osservate, ed è l'ambito in cui i modelli Qwen storicamente se la cavano bene sia con gli script CJK sia con l'inglese. L'editing è l'altro fronte. Un post su r/StableDiffusion che mostrava fogli di progettazione di personaggi generati con la modalità editing di Qwen e senza LoRA ha attirato attenzione perché quel workflow richiedeva una pila di fine-tune e un weekend passato a cablare ComfyUI.
Perché questo conta al di là di un singolo modello
Qui sono visibili due correnti più ampie. La prima è che la community open-weights ha un nuovo default. Per lungo tempo, la generazione locale significava derivati di Stable Diffusion e varianti di Flux, con una costante caccia al checkpoint meno peggiore. Qwen Image 2.1 si inserisce in quell'ecosistema con capacità di editing moderne integrate, e gli strumenti sono seguiti quasi immediatamente. La seconda corrente è geografica. Un thread separato su r/singularity intitolato "I modelli AI cinesi impennano in popolarità globale — e Washington è preoccupata" ha accumulato discussioni proprio perché modelli come questo continuano ad arrivare in cima ai test di preferenza che gli utenti eseguono da soli, non quelli commissionati dai fornitori.
Per chiunque stia scegliendo il proprio modello principale in questo momento, la lettura pratica è semplice. Se vuoi la migliore qualità di editing in assoluto da un'API ospitata, i leader chiusi valgono ancora il loro prezzo. Se vuoi qualcosa che puoi eseguire, fine-tunare, quantizzare e collegare alla tua pipeline senza chiedere permesso, il contendente da 7B è difficile da ignorare. E se sei solo curioso, i pesi sono su Hugging Face. Ventiquattro secondi su un laptop di due anni fa sono una barra bassa da superare per un primo esperimento.
L'editing come nuovo campo di battaglia
La funzionalità più importante non è affatto il text-to-image. È l'editing. I modelli di immagini precedenti trattavano la modifica come un problema separato: riempi questa regione, collega un ControlNet, spera che le giunture scompaiano. Qwen Image 2.1 tratta l'editing come modalità nativa, lo stesso modello che disegna può ridisegnare. Una dimostrazione che ha circolato su r/StableDiffusion mostrava fogli di progettazione di personaggi, molteplici viste coerenti dello stesso personaggio in pose e outfit diversi, prodotte senza LoRA e senza rigging di riferimento. Chiunque abbia provato quel workflow un anno fa sa quanto costava: un fine-tune per personaggio, ore a dipingere maschere e risultati che cambiavano tra un'angolazione e l'altra.
L'editing è anche il punto in cui si concentra il valore commerciale. I team di marketing non vogliono immagini; vogliono la loro immagine, modificata. Uno scatto di prodotto con lo sfondo sostituito. Un poster con il titolo rigenerato in un'altra lingua. L'editing nativo fa collassare quella pipeline, e il fatto che ora esista in un modello scaricabile significa che il crollo raggiunge persone che non pagheranno mai per un'API.
Gli strumenti della community lo riflettono. Il port TensorSharp viene fornito con configurazioni di editing fin dal primo giorno, non come aggiunta successiva. Lo studio in stile Fooocus espone maschere, annotazioni, outpainting e riferimenti di posa come input di prima classe. Quando chi fa i port considera l'editing una funzionalità centrale anziché un bonus, è il mercato che vota su ciò che conta.
Come la community verifica davvero le affermazioni
I benchmark dei fornitori sono marketing finché qualcuno non li riproduce, quindi gli artefatti più interessanti di questo mese sono stati quelli collettivi. Il confronto di 192 immagini tra Qwen e Krea 2, generato con prompt identici e ordinato per categoria, è il formato che risolve davvero le discussioni. Ha la stessa virtù di un test di assaggio alla cieca: la classifica di nessuno sopravvive intatta al contatto con esso. Le categorie in cui un modello domina sono visibili a colpo d'occhio, e così quelle in cui entrambi falliscono.
Hacker News ha fatto la sua parte rifiutando di accettare il titolo così com'era. Le sezioni commenti del thread di rilascio e della segnalazione di Tom's Hardware hanno premuto sui soliti punti deboli: quale suite di benchmark, il set di prompt di chi, cosa succede al di fuori della distribuzione testata. Quello scetticismo è il sistema immunitario della community open-weights, ed è per questo che le affermazioni che sopravvivono lì hanno peso. La reputazione di Qwen Image 2.1 attualmente si basa meno sui numeri di Alibaba e più sul fatto che centinaia di persone lo hanno eseguito e per la maggior parte non hanno pubblicato thread di umiliazione.
L'economia del buono quanto basta e dell'open
C'è una lettura commerciale che va oltre la qualità del modello. La generazione di immagini ospitata ha un prezzo parametrato alla frontiera, e la frontiera è costosa da gestire. Un modello da 7B che offre gran parte della qualità della frontiera al costo dell'elettricità cambia ciò che i clienti saranno disposti a pagare. Cambia anche ciò su cui gli sviluppatori costruiscono: un modello aperto con pesi stabili può essere bloccato a una versione, fine-tunato e distribuito dentro un prodotto senza negoziare un accordo API o temere una dismissione.
Quest'ultimo punto merita enfasi perché l'industria ha appena offerto una lezione esemplare. OpenAI ha ritirato il prodotto DALL·E autonomo alla fine di agosto, incorporando la generazione di immagini in ChatGPT Images. Tecnicamente non si è perso nulla, ma ogni integrazione costruita sulla vecchia interfaccia ha dovuto migrare secondo i tempi di qualcun altro. I pesi aperti non mandano quell'email.
Nulla di tutto ciò rende Qwen Image 2.1 il miglior modello di immagini al mondo. Lo rende qualcosa di probabilmente più dirompente: il miglior modello di immagini che una persona qualsiasi può possedere completamente. La discussione sulla classifica sarà comunque risolta dal prossimo rilascio, e da quello dopo ancora. Il cambiamento di proprietà è la parte che dura.
Il ritmo è l'altra cosa da interiorizzare. Oltre venti rilasci di modelli di immagini in un solo mese, come ha contato di recente un utente di r/PromptEngineering, significa che qualsiasi affermazione su "miglior modello" ha una vita utile misurata in settimane. Qwen Image 2.1 è la prova attuale che piccolo e aperto può mettere in imbarazzo grande e chiuso. Dagli un mese, e la domanda interessante sarà cosa lo sostituirà.
Articoli correlati
I modelli cinesi di immagini AI stanno conquistando fan all'estero, e Washington osserva
L'adozione è tecnica prima che politica. Gli sviluppatori scaricano ciò che funziona, e al momento proviene sempre più spesso da laboratori cinesi.
Cosa scommettono i mercati predittivi sulle immagini AI
Soldi veri scommettono su chi vincerà nelle immagini AI. OpenAI guida sulle immagini statiche, MiniMax sul video, e i modelli aperti sono il jolly che nessuno prezza.
Qwen-Image 2.1 vs Nano Banana 2.0: un modello aperto da 7B è appena arrivato alle calcagna di Google
Un modello aperto da 7 miliardi di parametri ora è davanti a Nano Banana 2.0 di Google nel benchmark di Alibaba e a distanza di tiro ovunque altrove.
I modelli di immagini cinesi stanno conquistando il mondo, e questo mese la conversazione è cambiata
I modelli di immagini cinesi stanno conquistando il mondo. Come sono cambiati questo mese i benchmark, le sezioni commenti e Washington.