
Six mille références chinoises découpées en trois jeux de cartes : la personne, la tenue, la pose
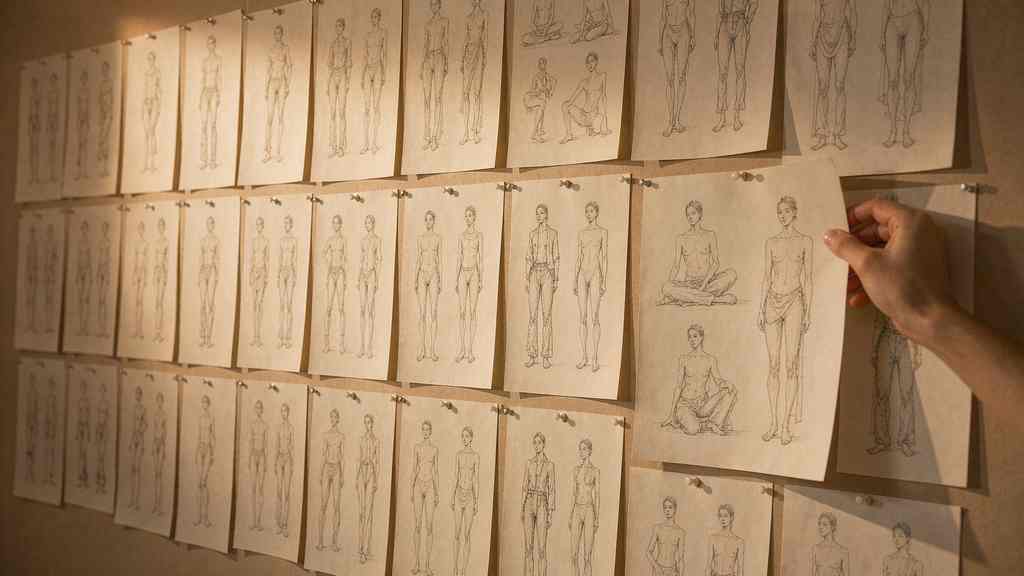
Commençons par la conclusion : si ce dépôt fait du bruit, ce n'est pas parce qu'il contient beaucoup d'images. Des images, il y en a partout, sur tous les serveurs de stockage du monde. Il fait du bruit parce qu'il découpe « choisir une image de référence » en trois pièces interchangeables — la personne, le vêtement, la pose — puis vous laisse assembler ces trois pièces en une recette à envoyer telle quelle au modèle.
Le dépôt s'appelle ai-pose-gallery-zh, l'auteur est Anhao. Le premier paragraphe du README pose les comptes sans détour : 1 439 mannequins neutres, avec 1 439 cartes de profondeur assorties ; 3 224 tenues ; 1 499 portraits ; au total 6 162 entrées de référence en chinois, 12 022 images haute définition en local, plus 1 760 images de référence issues des sites d'origine. Ces données ne sont pas de lui : il a mis en miroir les galeries publiques de trois auteurs — le site d'origine pour les poses et les vêtements est celui de ギア (@giaaibusi), et les 440 tenues manga viennent de CharaDB, chez たき AI. Son travail consiste à traduire, fusionner et ajouter une couche d'outils.
Le vrai problème réglé, c'est la recherche, pas la qualité d'image
Quiconque a fouillé une banque de références connaît le point de blocage. Vous voulez un mannequin adossé à un mur, les mains dans les poches, le corps incliné à quarante-cinq degrés. L'image est dans votre tête, mais pour la trouver vous faites défiler des vignettes page après page ; au bout de vingt pages, vous tombez sur un truc qui ressemble à 70 % de ce que vous voulez, et il faut encore le décrire vous-même. Les métadonnées du site d'origine sont en japonais : catégories de mouvement, sous-types de coiffure, styles de vêtements, tout est étiqueté en japonais. Un utilisateur chinois soit ne comprend pas, soit comprend mais n'arrive pas à en tirer un prompt.
Ce dépôt traduit intégralement les 6 162 métadonnées en chinois et les découpe à une granularité qui permet l'assemblage automatique : longueur des cheveux, 51 sous-types de coiffure, catégories de pose, étiquettes de tenue. Il affirme que les prompts ainsi composés sont « purs, sans interférence du japonais ». La formule sent le marketing, mais pour la génération d'images c'est un vrai problème : un modèle perd en stabilité dès qu'un prompt mélange deux langues.
Le trio est la clé, pas la longueur de la liste de fonctions
Son Web Studio vous fait piocher un élément dans chacune des trois bibliothèques : un portrait, une tenue, une pose. Le mannequin neutre et la carte de profondeur se basculent d'un clic. Une fois la sélection faite, vous pouvez glisser-déposer, coller ou saisir une URL pour ajouter vos propres références. La recette est stockée dans IndexedDB : fermez le navigateur, rouvrez-le, elle est toujours là. L'interaction n'a rien de renversant ; ce qui l'est, c'est de faire passer la « référence » d'une image unique à une entrée structurée.
Ensuite viennent les cinq connexions directes : Google Gemini, OpenAI GPT Image, Qwen d'Alibaba Cloud Bailian, Doubao de Volcano Ark, et ComfyUI en local. Les quatre premières fonctionnent avec une clé ; la cinquième exige une carte graphique dans votre machine. Le projet n'entraîne pas son propre modèle et ne compte pas s'y mettre : il parie que « même recette, on relance sur un autre modèle » deviendra une manœuvre banale.
Le plugin ComfyUI est la moitié la plus utile
Le dépôt est lui-même un plugin ComfyUI : un git clone dans custom_nodes/ et c'est prêt, avec quatre nœuds : pose, tenue, portrait, recette combinée. Les nœuds pose et recette embarquent une bascule use_depth, branchable directement sur ControlNet Depth. Le design est bien pensé : le mannequin neutre donne la structure, la carte de profondeur donne les relations spatiales ; laquelle des deux sert à la génération dépend de ce que vous visez — justesse de la posture ou justesse de la perspective.
Ce que je préfère, c'est le sélecteur visuel en fenêtre pop-up construit sur les 6 162 entrées. Vous l'ouvrez sur le canevas ComfyUI, vous choisissez, vous revenez câbler. Comparé à fouiller des dossiers puis glisser une image dans un nœud, le temps gagné n'est pas marginal.
Trois limites à énoncer clairement
Un : les droits sur les images ne lui appartiennent pas. Les poses, les tenues et les portraits viennent des sites publics des auteurs originaux ; le dépôt ne fait qu'un travail d'organisation et d'archivage en chinois, et le README précise noir sur blanc « interdiction de revendre en pack ». Pour un usage commercial, il faut retourner voir la licence des auteurs.
Deux : la galerie contient des mannequins de corps et des références de lingerie 18+, avec un mode sécurisé SFW activé par défaut. Ce n'est pas un détail : l'auteur le place juste après le premier point de sa clause de non-responsabilité, pas caché dans les petites lignes.
Trois, et c'est le plus important : il répète à l'envi que l'échange de visage sur des personnes réelles sans autorisation est interdit. Cette prudence a une raison : une bibliothèque qui sépare aussi proprement le trio « portrait + tenue + pose » est par nature l'amont d'une chaîne de deepfake. L'outil est neutre, l'usage ne l'est pas.
Pourquoi ce genre de projet ne cesse d'apparaître
Depuis un an, le seuil de la génération d'images est descendu de « savoir écrire un prompt » à « avoir une bonne référence ». Le côté modèles accompagne le mouvement : des modèles comme Seedream 5.5 commencent à produire nativement des éléments en couches avec canal alpha, GPT Image 2.6 descend l'édition par marquage local dans l'API — autant de façons de réduire le retravail après génération. Quand générer devient bon marché et stable, ce qui devient rare, c'est la capacité d'organiser l'entrée.
C'est là que réside le vrai sens des 6 162 références. Ce n'est pas une banque d'images, c'est un traducteur de « je veux cette ambiance-là » vers des coordonnées en trois segments qu'une machine peut exécuter. On peut dire qu'il ne fait que réorganiser trois sources japonaises en chinois, mais cette réorganisation est précisément l'endroit où la majorité des gens se bloquent.
Si vous voulez juste essayer, ouvrez la démo en ligne : ça marche même sur téléphone. Si vous voulez l'intégrer en production, réglez d'abord deux questions : jusqu'où va votre licence sur les contenus, et à qui vous comptez confier cette recette. La première décide si vous pouvez commercialiser ; la seconde décide si vous recevrez un jour une mise en demeure à trois heures du matin.
Articles associés
74 % : le chiffre qui décidera des trois prochaines années
Chez Nvidia, un point de marge brute vaut 3 milliards. À 74 %, puis 71 %, ce n'est pas une crise : c'est le chiffre qui dira si le marché croit encore au récit.
Trente-trois ans sans préparer de successeur
Un chasseur de têtes le dit sans détour : personne chez Nvidia n'a dirigé des milliers de personnes. La crise n'est pas le scandale, c'est l'organigramme.
99 milliards chez ses propres clients, et un nom technique embarrassant
Plus de 99 milliards investis chez ses propres clients. Lucent et Cisco l'ont fait avant elle, et l'histoire s'est mal terminée. La différence, cette fois, tient à un détail.
175 000 signatures, et un conseil qui compte autrement
175 000 signatures, dont 7 500 salariés, réclament le retour de Huang. Le conseil, lui, sait qu'une enquête non conclue rend tout retour impossible avant des mois.