
画出来它就出现:涂鸦到对象编辑走向成熟
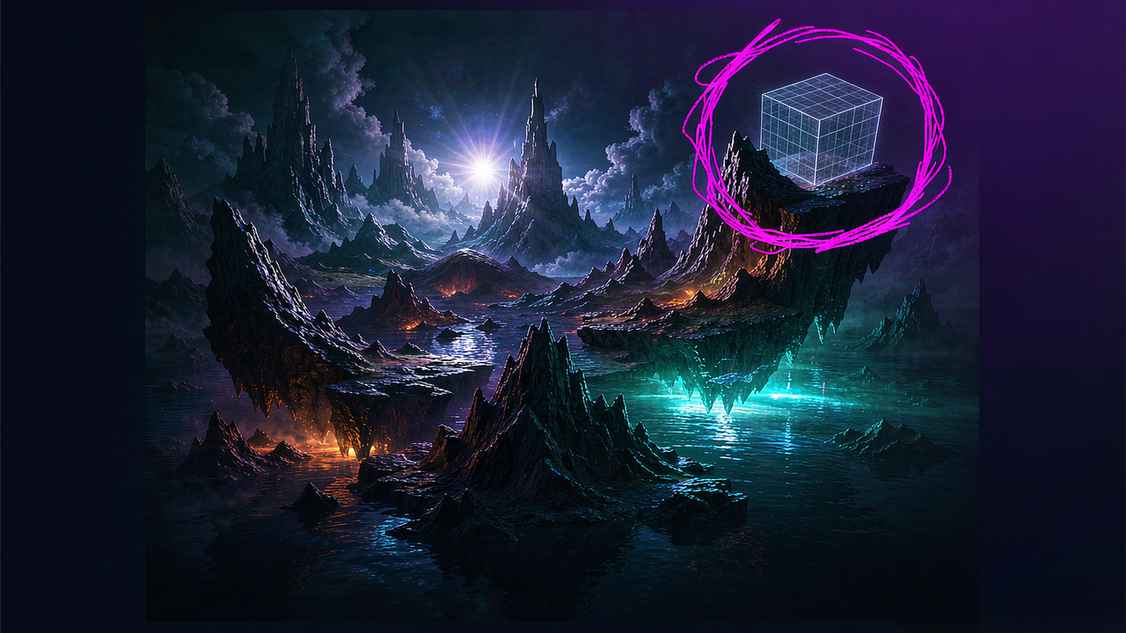
十月初,Hugging Face 上的某个角落,一个不起眼的研究发布悄悄展示了图像编辑的走向。ML-Intern-lab 的一个团队为阿里巴巴的 Qwen-Image-2.1 发布了一个名为 Doodle-in 的 LoRA。你拿一张照片,在想要修改的区域画上一条粗糙的品红色涂鸦,说出对象名称,模型就会替换涂鸦之下的内容,同时保持光照和场景其余部分不变。它基于 Open Images V7 构建的略多于 6,000 对数据训练而成。
这是一个名字不起眼的小众工具。但它也清晰地体现了贯穿全年的转变:图像 AI 中有意思的部分不再是生成,而是编辑。
真正的工作从来不是第一张图
问问任何靠图像模型谋生的人,他们真正把时间花在哪里。答案很少是第一次渲染,而是第二次、第三次和第十二次修改。改掉瓶子上的标签。保留人物的脸。把产品向左移两英寸,但不改变阴影。把夹克放到另一个背景上,却不碰衣领。
正是这些编辑,让一个能生成漂亮图像的生成器,和一个设计师可以交付的工具并不等同。差距在于控制力,整个市场也一直在围绕这一点重组。OpenAI 将其旗舰图像模型拆分为快速档和精确档,并把精确档定位为能精确保留人脸、标签或版式的编辑。Seedream 的 Pro 模型特意强调在编辑某一元素的同时保持画面其余部分不变。Ideogram 4.5 则围绕反复编辑后伪影累积这一具体问题构建。Grok 的图像模型把整套宣传归结为“编辑才是真正的工作”。
为什么一条涂鸦胜过一段文字
用文字描述局部编辑比看起来更难。“把左边架子上的植物换成小一点的”会招致模型重新解释整个左侧,或调整光照,或悄悄重新渲染架子。你在语言上越是想精确,就越是给模型留下更多可乘之机,去改动你没提到的某些东西。
涂鸦消除了这种歧义。它直接指出来。画出区域,说出对象名称,指令就压缩为两个输入,而不是一段话。这就是为什么这项技术在实现上颇为繁琐,却仍在传播。它借用了视觉工作中最古老的交互方式——手,并用在语言并不适合的地方。
实际应用场景,尤其是产品
区域编辑在需要重复的地方最为重要。产品目录需要同一件商品出现在几十种场景中,且每张图的光照和材质都保持一致。广告公司要针对不同市场调整同一张主视觉,而不必重拍。独立设计师需要在版式上反复迭代,而不必重新生成那些已经正确的部分。
在每种情况下,价值都不是创造力,而是不必从头再来。这正是那种做不出精彩演示、却会体现在预算里的价值。
这个模式值得注意,因为它与大多数人最初学习使用这些工具的方式相反。新手写长长的提示词,然后祈祷。靠这个谋生的人写简短的指令并直接指点,因为他们已经明白:你要求模型改变的东西越少,它就越不会改掉你不想要它改的东西。涂鸦就是这种习惯变成的界面,因此它感觉不像一项功能,更像是对这项工作一直如何完成的承认。
做对了这一点的工具,往往会隐没在流程之中。没人会用“我用了区域编辑器”来描述自己的一天。他们会说,自己修好了标签并发出了那批货。当一个编辑工具达到这种程度时,它就已经完成了使命,而一个名字拗口的研究型 LoRA 曾帮助实现这一点,则是这个故事里最无趣的部分。
这项技术还意味着什么
涂鸦只是若干输入方式之一,而有趣的问题是:某项具体工作需要哪一种。当改动是空间性的、局部的,指点胜过描述。当改动是风格性的、全局的,参考图又胜过两者,这就是为什么今年如此多的进展都关乎给模型喂更多参考图,而不是更长的提示词。当改动很细微、整张图又必须保持稳定时,蒙版加精确指令仍然胜出。技能不在于精通其中某一种,而在于知道哪一种合适。
还有一个更深的要点,关乎人与模型如何分工。模型擅长生成一张看似合理的图像,却不擅长判断哪张图才是正确的。涂鸦让人提供模型无法推断的部分,也就是意图,而把模型擅长的事——合成——留给它做。正是这种分工,让这项技术几乎立刻就让人觉得自然。它不是新界面,而是一个旧界面——手——被用在语言屡屡失败的地方。
同样的逻辑出现在今年发布的各类工具中。Magnific One 正是出于这个原因,在生成之前加入了一个艺术指导步骤:决定方向是人的行为,提前做这件事能让模型不必去猜。涂鸦就是同样的思路,只不过缩小到几百像素的尺度。
编辑工具简明指南
如果你要为某项编辑选择工具,一个粗略的排序会有帮助。对于可以指出区域的局部改动,使用涂鸦或蒙版工具:这是你能给出的最不含糊的指令。对于氛围、光照或风格的全局改动,使用参考图,让模型去匹配。对于不能扰动其他任何内容的改动,寻找那些宣称在反复编辑中保持一致性的工具,因为那正是你需要的特性,也是大多数工具最薄弱的地方。而对于任何要交给客户的成果,在你爱上结果之前,先解决授权问题。
需要诚实面对的部分
涂鸦到对象编辑并非魔法,其失败模式也是可以预见的。遮挡是难点。如果你想改变的对象位于别的东西后面,或部分被遮住,模型就必须想象缺失的部分,而它有时会想象错。反复编辑仍会漂移,这就是为什么多家实验室一直在发布修复方案,旨在让未被触碰的像素保持稳定。
还有一个值得检查的授权问题。Qwen-Image-2.1 是以面向研究的许可证发布的,社区微调会继承其基础模型所带的任何限制。对于个人实验来说没问题。对于商业工作,这种细节应该在客户交付物依赖它之前就解决,而不是之后。
要点总结
如果你在实际工作中使用图像模型,值得培养的技能不是提示词。而是拆解:判断图像中哪些部分应该保持冻结,哪些应该改变,然后选择最轻量的工具,只改动那些部分。有时是从涂鸦开始的局部编辑。有时是蒙版、参考图或专用编辑器。
Doodle-in 只是一个研究型 LoRA,到下个月可能就被遗忘。但它所指的方向不会。赢得明年图像工作市场的工具,将被评判的标准是:它们能否把你没有要求改动的一切,原封不动地保持原样。
相关文章
Decagon 的 PACT 协议,想让「同意」成为一个标准
Decagon 开源了一个协议,用来验证个人智能体的身份,以及客户授予它的权限。这是管道工程,而它决定了智能体经济能不能跑起来。
AI「重逢」热潮:一场还没想好该如何感受的讨论
AI 致敬短片把逝去的公众人物带回中国荧幕,拿下数十万点赞。然后反弹来了,而它争论的是「同意」。
Apple 发布了一个开源多模态模型,却几乎没告诉任何人
苹果的这次「研究优先」式发布悄然越过了主流视野,但模型那种细粒度的视觉 grounding,透露了它的 AI 栈正走向哪里。
OpenCut 与「开源剪映」的那一刻
一款免费、MIT 许可的视频剪辑器持续冲上 GitHub 趋势榜,而它的路线图里包含一个面向 AI 智能体的 MCP server。围绕 AI 媒体的工具,正在追上模型本身。