
描けば現れる:スクリブルからオブジェクトへの編集が成熟期を迎える
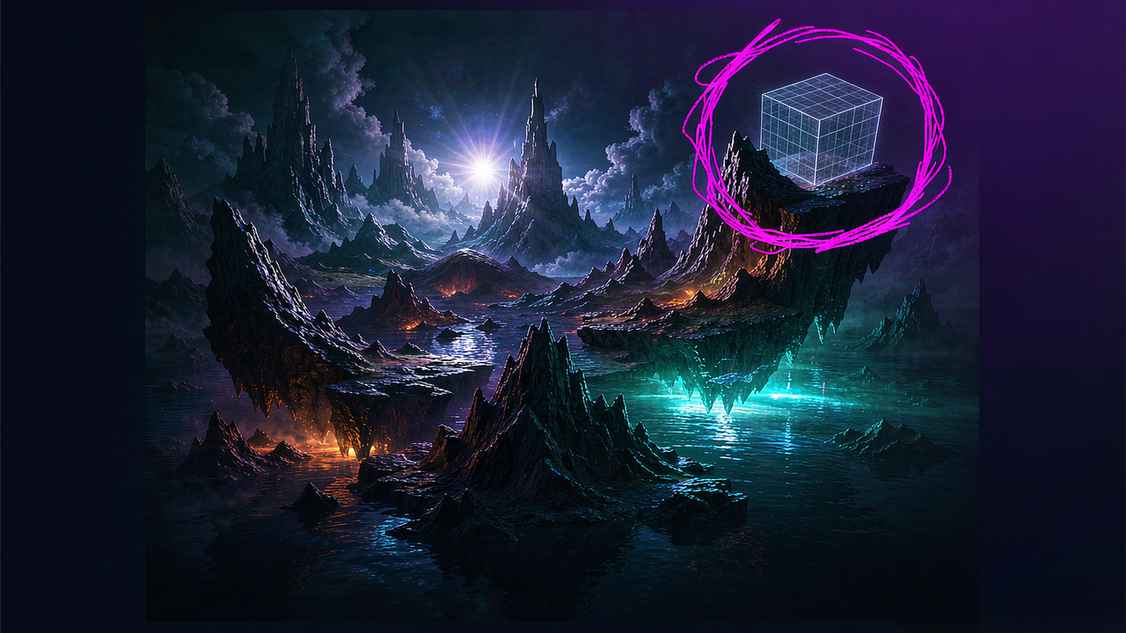
10月上旬、Hugging Faceのどこかで、小さな研究リリースが画像編集の行き先を静かに示していた。ML-Intern-labのチームが、AlibabaのQwen-Image-2.1向けにDoodle-inと呼ばれるLoRAを公開した。写真を撮り、変更したい領域にマゼンタの大まかな落書きを描き、オブジェクトに名前を付けると、モデルは照明とシーンの残りをそのままに、落書きの下にあるものを置き換える。Open Images V7から構築された6,000組余りのペアで訓練された。
地味な名前のニッチなツールだ。しかし、この1年ずっと進んできた変化を明確に示す例でもある。画像AIで面白い部分は生成ではなく編集になった。
本当の仕事は最初の画像ではなかった
画像モデルを仕事で使う人に、実際に何に時間を使っているか尋ねてみるといい。答えが最初のレンダリングであることはほとんどない。2回目、3回目、12回目の修正だ。ボトルのラベルを変える。人物の顔を保つ。影を変えずに商品を左へ2インチ動かす。襟に触れずにジャケットを別の背景に置く。
これらの編集があるからこそ、美しい画像を生成するものと、デザイナーが引き渡せるツールは同じではない。隔たりはコントロールにあり、市場全体がその周りで再編成されてきた。OpenAIは旗艦画像モデルを高速層と精密層に分け、精密な方を、顔やラベルやレイアウトを正確に保つ編集に向けた。SeedreamのProモデルは、フレームの残りを保持しながら1つの要素を編集することを売りにした。Ideogram 4.5は、繰り返し編集した後にアーティファクトが蓄積するという特定の問題を中心に作られた。Grokの画像モデルは、「編集こそが本当の仕事だ」というメッセージで全体を打ち出した。
なぜ落書きが段落に勝るのか
ローカル編集を言葉で説明するのは見た目より難しい。「左の棚の植物を小さめのものに変えて」と言うと、モデルは左側全体を再解釈したり、照明を調整したり、棚をこっそり再レンダリングしたりしかねない。言語で正確にしようとするほど、言及していない何かをモデルが変える余地が広がる。
落書きはその曖昧さを取り除く。指し示すのだ。領域が描かれ、オブジェクトに名前が付けられ、指示は段落ではなく2つの入力に集約される。実装が面倒でもこの手法が広がっているのはそのためだ。視覚作業で最も古いインタラクションである手を借り、言語が合わない場所で使う。
実用的なケース、とくに製品において
領域編集が最も重要になるのは、繰り返しが起こる場所だ。製品カタログでは、同じアイテムを何十もの文脈で見せる必要があり、それぞれ照明と素材が一貫していなければならない。キャンペーンを各地域向けに展開する代理店は、撮り直さずに1枚のヒーローイメージを市場ごとに調整する必要がある。インディーのデザイナーは、すでに正しい部分を再生成せずにレイアウトを反復したい。
いずれの場合も価値は創造性ではない。一からやり直さずに済むことだ。それはまさに、良いデモにはならないが、予算には表れる種類の価値だ。
このパターンは注目に値する。ほとんどの人がこれらのツールの使い方を最初に学ぶ方法と逆行するからだ。初心者は長いプロンプトを書いて願う。これを生業にする人は短い指示を書いて指し示す。モデルに変えてほしいと頼むものが少ないほど、望まないものを変えることも少ないと学んでいるからだ。落書きはその習慣をインターフェースにしたもので、だからこそ機能というより、仕事が常にどう行われてきたかの告白のように感じられる。
これをうまくやるツールは、プロセスに溶け込んで消えていく傾向がある。誰も「領域編集ツールを使った」とは言って一日を説明しない。「ラベルを直してバッチを出荷した」と言う。編集ツールがその境地に達したとき、それは仕事を果たしたのであり、扱いにくい名前の研究用LoRAがそこへの到達を助けたという事実は、この話で最も面白くない部分だ。
この手法がほのめかす他のこと
落書きは複数ある入力の1つであり、面白い問いは、与えられた仕事にどの入力が必要かだ。変更が空間的でローカルなら、説明より指し示す方が勝る。変更がスタイル的でグローバルなら、参照画像がどちらよりも勝る。だからこそ今年の進歩の多くは、長いプロンプトではなく、より多くの参照をモデルに与えることに関するものだった。変更が微妙で、画像全体を安定させなければならないなら、マスクと精密な指示が依然として勝つ。スキルはこれらのどれかを極めることではない。どれが合うかを知ることだ。
人とモデルがどのように分業するかについて、より深い点もある。モデルはもっともらしい画像を生成するのは得意だが、どの画像が正しいかを知るのは苦手だ。落書きは、モデルが推論できない部分、つまり意図を人が与え、モデルには得意な部分、つまり合成を任せる。その分業があるから、この手法はほぼ即座に自然に感じられる。新しいインターフェースではない。古いインターフェースである手を、言語が失敗し続けた場所に適用したものだ。
同じ論理は、今年リリースされたツールの随所に現れている。Magnific Oneが生成前にアートディレクションのステップを追加したのはまさにこの理由だ。方向性を決めるのは人間の行為であり、それを前もって行えばモデルが推測する必要がなくなる。落書きは、数百ピクセルのスケールで同じアイデアを表している。
編集ツールの簡単なフィールドガイド
特定の編集に何を使うかを選ぶなら、大まかな順序が役立つ。領域を指せるローカル変更には、落書きまたはマスクツールを使う。それが与えられる最も曖昧さの少ない指示だ。ムード、照明、スタイルのグローバルな変更には、参照画像を使い、モデルに合わせさせる。ほかの何も乱してはならない変更には、繰り返し編集を通じて一貫性を保つと謳うツールを探す。それがあなたに必要な特性であり、ほとんどのツールが最も苦手とするものだからだ。そしてクライアントに提出するものなら、結果に惚れ込む前にライセンスの問題を片付けておく。
正直であり続けるべき点
落書きからオブジェクトへの編集は魔法ではなく、失敗の仕方は予測できる。難しいのはオクルージョンだ。変更したいオブジェクトが別のものの後ろにある、または一部が隠れている場合、モデルは欠けた部分を想像しなければならず、時にはそれを誤って想像する。繰り返し編集では依然としてドリフトが起きる。だから複数のラボが、触れていないピクセルを安定して保つための修正をリリースしてきた。
確認する価値のあるライセンス上のしわ寄せもある。Qwen-Image-2.1は研究志向のライセンスで提供され、コミュニティのファインチューニングはベースモデルが持つ制限をそのまま引き継ぐ。個人の実験なら問題ない。商用利用なら、クライアントへの成果物がそれに依存する前に片付けるべき種類の詳細であり、後ではない。
持ち帰るべきこと
実務で画像モデルを使うなら、身につける価値のあるスキルはプロンプトではない。分解だ。画像のどの部分を凍結し、どの部分を変えるべきかを決め、それからそれらの部分だけを変える最も軽いツールを選ぶこと。それが落書きによるローカル編集のこともある。マスク、参照画像、専用エディタのこともある。
Doodle-inは研究用のLoRAであり、来月には忘れられているかもしれない。それが指し示す方向は忘れられないだろう。来年の画像作業を制するツールは、あなたが言及しなかったすべてをどれだけ正確に元のまま保てるかで評価される。
関連記事
Decagon の PACT プロトコルは「同意」を標準にしようとしている
Decagon は、個人エージェントの身元と、顧客が与えた権限を検証するプロトコルをオープンソース化した。地味な配管だが、エージェント経済が機能するかを決める。
AI「再会」ブーム:まだどう感じるべきか決めきれない中国の議論
AI の追悼動画が亡くなった著名人を中国の画面に連れ戻し、数十万の「いいね」を集めた。そして反発が来た。争点は「同意」だった。
Apple はオープンなマルチモーダルモデルを公開し、ほとんど誰にも知らせなかった
研究優先のこのリリースは主流の視野を静かにすり抜けたが、細粒度の視覚グラウンディングは Apple の AI スタックの行き先を語っている。
OpenCut と「オープンソース版 CapCut」の瞬間
無料で MIT ライセンスの動画編集アプリが GitHub のトレンドを上り続け、ロードマップには AI エージェント向けの MCP サーバーが含まれる。AI メディアを囲む道具がモデルに追いつきつつある。