
畫出來就出現:塗鴉轉物件編輯正式成熟
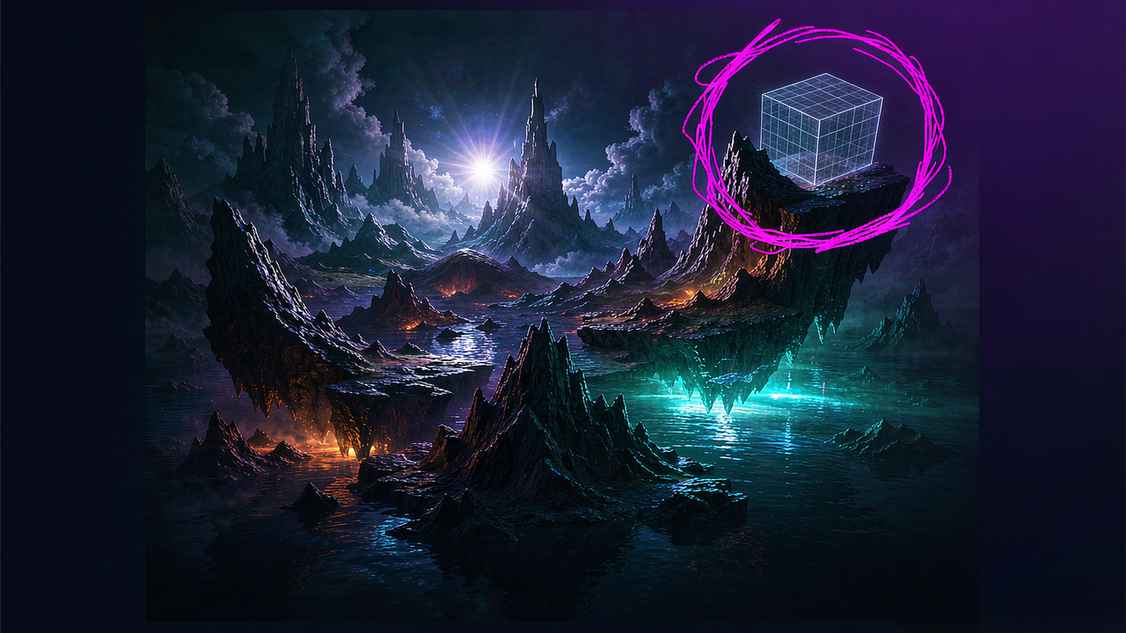
十月初,Hugging Face 上的某個角落,一份小型研究發布悄然揭示了影像編輯的走向。ML-Intern-lab 的團隊為阿里巴巴的 Qwen-Image-2.1 發布了一款名為 Doodle-in 的 LoRA。你拍一張照片,在想改變的區域上用洋紅色粗略塗鴉,說出物件名稱,模型就會替換塗鴉底下的內容,同時保留光線與場景其餘部分不變。它是在以 Open Images V7 建構的六千多組配對資料上訓練而成。
這是一款名字毫不起眼的利基工具。它同時也清楚示範了整年來逐漸成形的轉變:影像 AI 有趣的部分已不再是生成,而是編輯。
真正的工作從來不是第一張圖
問問任何靠影像模型吃飯的人,他們實際上把時間花在哪裡。答案很少是第一次算圖。而是第二次、第三次和第十二次修訂。把瓶身上的標籤換掉。保留那個人的臉。把產品往左移兩吋,但不改變陰影。把外套放到不同背景上,但不碰衣領。
這些編輯正是為什麼能生成漂亮影像的生成器,並不等同於設計師能直接交件的工具。差距在於控制,而整個市場一直圍繞著這點重新組織。OpenAI 將其旗艦影像模型拆成快速層與精準層,並把精準層主打用於能精確保留臉部、標籤或版面配置的編輯。Seedream 的 Pro 模型強調在編輯單一元素的同時,保持畫面其餘部分不變。Ideogram 4.5 則是圍繞著反覆編輯後瑕疵累積這個特定問題打造。Grok 的影像模型則把整體訴求定調為「編輯才是真正的工作」。
為什麼塗鴉勝過一段文字
用文字描述局部編輯比看起來更難。「把左邊層架上的植物換成小一點的」會讓模型重新詮釋整個左側,或調整光線,或悄悄重新算圖層架。你在語言上越想精確,就替模型創造越多面積去改變你沒提到的東西。
塗鴉消除了這種模糊性。它用指的。畫出區域、說出物件名稱,指令就縮減成兩個輸入,而不是一段文字。這就是為什麼即使實作起來相當麻煩,這項技術仍在擴散。它借用了視覺工作最古老的互動方式——手——並用在語言不適切的地方。
實務上的應用場景,尤其是產品
區域編輯在重複性高的地方最重要。產品型錄需要同一個品項出現在數十種情境中,每個情境的光線和材質都要一致。代理商改編廣告活動時,需要針對每個市場調整同一張主視覺,而不用重拍。獨立設計師需要在版面上反覆調整,而不必重新生成已經正確的部分。
在每個案例中,價值都不在於創意。而在於不必從頭來過。這正是那種做不出精彩 demo、卻會實實在在反映在預算上的價值。
這個模式值得注意,因為它與大多數人最初學習使用這些工具的方式背道而馳。初學者寫長長的提示詞然後祈禱。靠這個吃飯的人寫簡短指令然後用指的,因為他們學到:你要求模型改變的東西越少,它就越不會改到你不想改的地方。塗鴉就是這種習慣變成介面,這也是為什麼它感覺不太像一項功能,更像承認這份工作一直都是這樣做的。
把這件事做對的工具,往往會隱沒在流程中。沒有人會說自己今天用了區域編輯器來描述一天的工作。他們會說自己修好了標籤然後出貨了那批圖。當一款編輯工具達到這種境界,它就稱職了,而一款名字拗口的研究型 LoRA 幫忙促成這點,是這個故事裡最不有趣的部分。
這項技術還暗示了什麼
塗鴉只是眾多輸入方式之一,而有趣的問題是:某項特定工作需要哪一種。當改變是空間性且局部的,用指的會勝過用描述的。當改變是風格性且全面的,參考圖會勝過兩者,這也是為什麼這一年許多進展都在於餵給模型更多參考圖,而不是更長的提示詞。當改變細微、而整張影像必須保持穩定時,遮罩加上精確指令仍然勝出。真正的技能不在於精通其中一種,而在於知道哪一種適合。
這裡還有一個關於人與模型如何分工的更深層觀點。模型擅長產出看似合理的影像,卻不擅長判斷哪張影像才是對的。塗鴉讓人提供模型無法推斷的部分,也就是意圖,並讓模型去做它擅長的部分,也就是合成。這種分工正是為什麼這項技術幾乎立刻讓人覺得自然。它不是新介面。它是老介面——手——被用在語言不斷失敗的地方。
同樣的邏輯也出現在今年發布的各種工具中。Magnific One 正是基於這個理由,在生成前加入了一個藝術指導步驟:決定方向是人類的行為,事先做好就能讓模型不必瞎猜。塗鴉就是在幾百像素尺度上的同一個概念。
編輯工具簡易實戰指南
如果你正在為某項編輯挑選該用什麼工具,一個粗略的排序會有幫助。對於你能指出區域的局部修改,使用塗鴉或遮罩工具:那是你能給出最不含糊的指令。對於氛圍、光線或風格的全面改變,使用參考圖並讓模型去匹配。對於不能擾動其他任何東西的修改,尋找標榜在反覆編輯間保持一致性的工具,因為那正是你需要的特性,也是大多數工具最弱的一環。而對於任何要交給客戶的成果,在你愛上結果之前,先解決授權問題。
必須誠實面對的部分
塗鴉轉物件編輯不是魔法,而失敗模式是可預測的。遮蔽是困難的情況。如果你想改變的物件位在其他東西後面,或部分被遮住,模型就必須想像缺失的部分,而有時它會想錯。反覆編輯仍然會漂移,這就是為什麼多家實驗室一直在發布修正,目標是讓未被觸及的像素保持穩定。
還有一個值得留意的授權細節。Qwen-Image-2.1 是以研究導向的授權條款發布,而社群微調模型會繼承其基礎模型所帶有的任何限制。對個人實驗來說這沒問題。但對商業工作而言,這是那種應該在客戶交付成果依賴它之前就解決的細節,而不是之後。
關鍵要點
如果你在工作中實際使用影像模型,值得培養的技能不是提示詞撰寫,而是拆解:判斷影像中哪些部分應該保持凍結、哪些應該改變,然後選擇只改變那些部分的最輕量工具。有時那是用塗鴉做的局部編輯。有時是遮罩、參考圖或專用編輯器。
Doodle-in 是一款研究型 LoRA,下個月可能就被遺忘。但它指向的方向不會。未來一年在影像工作中勝出的工具,將以它們能否把你沒要求的一切精準保持原樣來評判。
相關文章
Decagon 的 PACT 協議,想讓「同意」成為一個標準
Decagon 開源了一個協議,用來驗證個人智能體的身分,以及客戶授予它的權限。這是管道工程,而它決定了智能體經濟能不能跑起來。
AI「重逢」熱潮:一場還沒想好該如何感受的討論
AI 致敬短片把逝去的公眾人物帶回中國螢幕,拿下數十萬點讚。然後反彈來了,而它爭論的是「同意」。
Apple 發布了一個開源多模態模型,卻幾乎沒告訴任何人
蘋果的這次「研究優先」式發布悄然越過了主流視野,但模型那種細粒度的視覺 grounding,透露了它的 AI 棧正走向哪裡。
OpenCut 與「開源剪映」的那一刻
一款免費、MIT 授權的影片剪輯器持續衝上 GitHub 趨勢榜,而它的路線圖裡包含一個面向 AI 智能體的 MCP server。圍繞 AI 媒體的工具,正在追上模型本身。