
gpu-unlock: dois valores e o dobro de TFLOPS numa GeForce
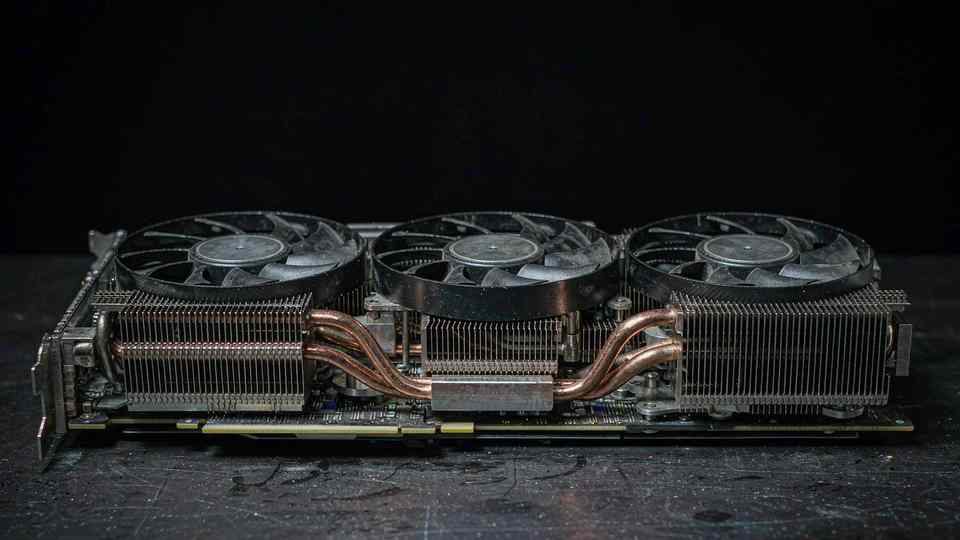
Tem um número no README do gpu-unlock que me fez largar a xícara de café: uma RTX 4090 sai de 165 para 329 TFLOPS em multiplicação de matrizes BF16. Não por overclock. Não por VBIOS modificada. Escrevendo dois valores nos seletores de velocidade da placa antes de o driver da NVIDIA carregar.
O projeto vem subindo na lista de tendências mensais do GitHub desde o outono e está na casa das 17.700 estrelas. É um módulo de kernel Linux, GPL-2.0, mantido por uma pessoa que assina o README com um pedido para que você o ajude a comprar mais GPUs.
O que a NVIDIA realmente entrega
As placas GeForce saem de fábrica com os tensor cores limitados à metade da taxa em matemática FP16, BF16 e TF32 com acumulação FP32. Não é um conjunto de instruções de nicho — é o que quase toda inferência não quantizada e praticamente todo fine-tuning usam. O mesmo silício vendido como RTX A-series ou como placa de datacenter roda na taxa cheia.
Isso não é segredo. É segmentação de mercado, e o README diz isso em uma linha quando um usuário pergunta por que a NVIDIA capou a placa: “eles querem que as empresas comprem as placas profissionais sem essas limitações, a preços significativamente maiores”.
O desbloqueio não é patch de driver nem flash de firmware. É um módulo que roda no initramfs, antes de o nvidia vincular a placa, grava os seletores de velocidade (SS0 0x88888888 seleciona a taxa BF16 cheia, um SS1 de 4 bits 0x8 habilita o IMLA4) e executa um reset em nível de função. A técnica combina uma abordagem de desbloqueio já existente com timing cuidadoso. Como nada no disco é alterado, uma nova versão do driver da NVIDIA não desfaz o serviço.
Os ganhos são reais, mas não uniformes
Os números de manchete são de vazão em matriz densa, e são grandes. Uma RTX 3060 vai de 27 para 51 TFLOPS. Uma 3090 vai de 75 para 125. Uma 4090 dobra na taxa de pico — com a ressalva, dita sem rodeios, de que a 4090 esgota a energia antes de esgotar os tensor cores, então cargas reais ganham bem menos do que o pico sugere.
Cargas reais são onde fica interessante, porque a dispersão é enorme:
- Prefill de LLM / processamento de prompt (FP16, BF16, AWQ, GPTQ): +25–55%
- Tempo até o primeiro token: 25–30% menor
- LoRA e fine-tuning completo em BF16: +25–50%
- Geração de imagem (SDXL, SD 1.5, modelos DiT no ComfyUI): +30–55%
- Geração de vídeo com cálculo BF16 (Wan 2.2): +15–20%
- Kernels FlashAttention e SDPA: +50–60%
- llama.cpp / Ollama com GGUF quantizado: 0–15%, sobretudo em contexto longo
- Decode token a token, INT8/FP8/INT4, jogos, CUDA FP32 puro: nenhuma mudança
A última linha é a que as pessoas esquecem. Se sua carga é decode limitado por largura de banda de memória — que é a maior parte da inferência de chat numa placa única — você não ganha nada. O desbloqueio compra vazão de matriz, não largura de banda. Quem roda um modelo de 4 bits com lote 1 pode fechar a aba.
Onde compensa é em prefill, fine-tuning e difusão. Um ganho de 30–55% em geração de imagem muda de verdade quantas iterações você consegue pagar numa tarde, e não custa nada na tomada além de calor.
Por que “bit a bit idêntico” é a afirmação interessante
O README afirma que as saídas são bit a bit idênticas antes e depois; só a velocidade muda. Essa única frase separa o projeto de overclock de um jeito que importa jurídica e praticamente.
Overclock muda resultados, pode corromper treinos longos e anula garantias de formas que os fabricantes conseguem detectar. Remover um limitador de taxa não muda a aritmética — as mesmas instruções executam na mesma ordem, só que mais delas por ciclo. Se você tem requisito de reprodutibilidade, ele continua valendo.
Também significa que os únicos riscos reais são térmicos e elétricos. A resposta do README é calibrada: throttling padrão e gerenciamento de energia continuam intactos, então a placa deve reduzir o clock em vez de fritar. Isso é plausível para um desktop com ventilação. Também não é, obviamente, uma garantia sobre a qual apostar uma workstation alugada.
Instalar, e o que quebra
Só Linux, e a instalação tem três passos se sua distribuição for Arch, Debian/Ubuntu ou Fedora:
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
make install
Depois acrescente gpu_unlock.targets=all à linha de comando do kernel — ou uma lista de endereços PCI separados por vírgula, se quiser apenas placas específicas — e reinicie. A verificação é journalctl -k -b | grep gpu_unlock.
O suporte a placas é onde o projeto é honesto sobre os próprios limites. Ampere (RTX 30) está marcado como estável, com mais de cem relatos de usuários. Ada (RTX 40) e Turing (RTX 20) são experimentais. Blackwell (RTX 50) não tem suporte e, segundo o autor, provavelmente não terá.
Dois modos de falha vale conhecer antes de tentar. Notebooks perdem o desbloqueio sempre que a GPU dedicada desliga, o que muitas fazem em repouso; desativar o gerenciamento de energia em tempo de execução ajuda em alguns modelos e não em outros. E suspender para a RAM reseta os seletores, embora o módulo reaplique o desbloqueio ao retomar, por padrão, com cerca de um segundo a mais.
Windows existe apenas como um port de terceiros, para o qual o README aponta com um “pode variar”. Ele também avisa, no tom plano de quem já viu isso acontecer, que há moedas cripto e instaladores por aí usando o nome do projeto, e que nenhum deles é dele.
A parte que ninguém quer escrever
Metade da capacidade de processamento de IA nos PCs gamer do mundo está atrás de uma chave de firmware que existe para proteger uma faixa de preço. Essa é a descoberta de fato aqui, e é maior que um repositório.
Depois que você sabe disso, outras coisas mudam de cara. O preço de GPU na nuvem é definido contra placas com o limitador desligado. Uma 3090 usada vale silenciosamente mais que a etiqueta há dois anos. E todo o argumento de “você precisa de GPU de datacenter para inferência séria” fica um pouco mais frágil quando um módulo de kernel recupera 65% da vazão de tensor numa placa que custa um décimo.
Há um contra-argumento legítimo, e eu vou fazê-lo: a segmentação é como a NVIDIA financia a pilha de software que torna essas placas usáveis em primeiro lugar. O CUDA não se pagou sozinho. Desbloquear uma placa de consumidor não é roubo, mas também não é de graça — o custo é carregado por todo mundo que compra a peça profissional.
É um argumento sobre justiça, não sobre a existência da chave. E argumentos sobre justiça costumam não parar alguém com uma máquina Linux sobrando e um fine-tuning que precisa terminar até sexta.
Se você for tentar
Faça numa máquina que você possa reinstalar sem drama. Confira a geração primeiro — é na Ampere que estão os relatos. Meça antes e depois com a carga que você realmente roda, não com um GEMM sintético, porque a história toda aqui é que o ganho depende inteiramente de você estar limitado pelo cálculo de matriz ou pela largura de banda.
E leia o FAQ. O autor responde à pergunta “isso prejudica minha GPU” com um não fundamentado, e à pergunta “por que a NVIDIA fez isso” com uma frase mais útil que a maioria dos whitepapers de fabricante.
Artigos relacionados
Uma planilha comunitária de toques que desliga os anúncios dos Android chineses
Não mexe no sistema, não desbloqueia nada, não faz flash de nada. Só vira os botões que os fabricantes já deixaram à mostra. O preço é uma lista que alguém precisa continuar escrevendo.
GPT Image 2.6 manteve o preço por token e elevou a fatura
O GPT Image 2.6 mantém cada tarifa por token do 2.5 e mesmo assim custa mais por imagem, porque boa parte do trabalho acontece agora nos tokens de saída. Onze dias após o lançamento, a estrutura de preços diz mais que o ranking.
Alguém reconstruiu o IDM por fora e anotou o que não tocou
Uma reimplementação em Rust do Internet Download Manager promete 5 vezes a velocidade e 86 idiomas. O documento mais interessante é o parágrafo que explica como ela foi feita sem copiar nada.
Rune é um framework de UI em Rust feito para que um agente possa verificar o próprio trabalho
Rune renderiza sem interface, despeja sua árvore de elementos e aceita entrada roteirizada, o que dá a um agente de código um sinal diffável que um screenshot nunca oferece. O framework está em pré-lançamento e não aceita pull requests.